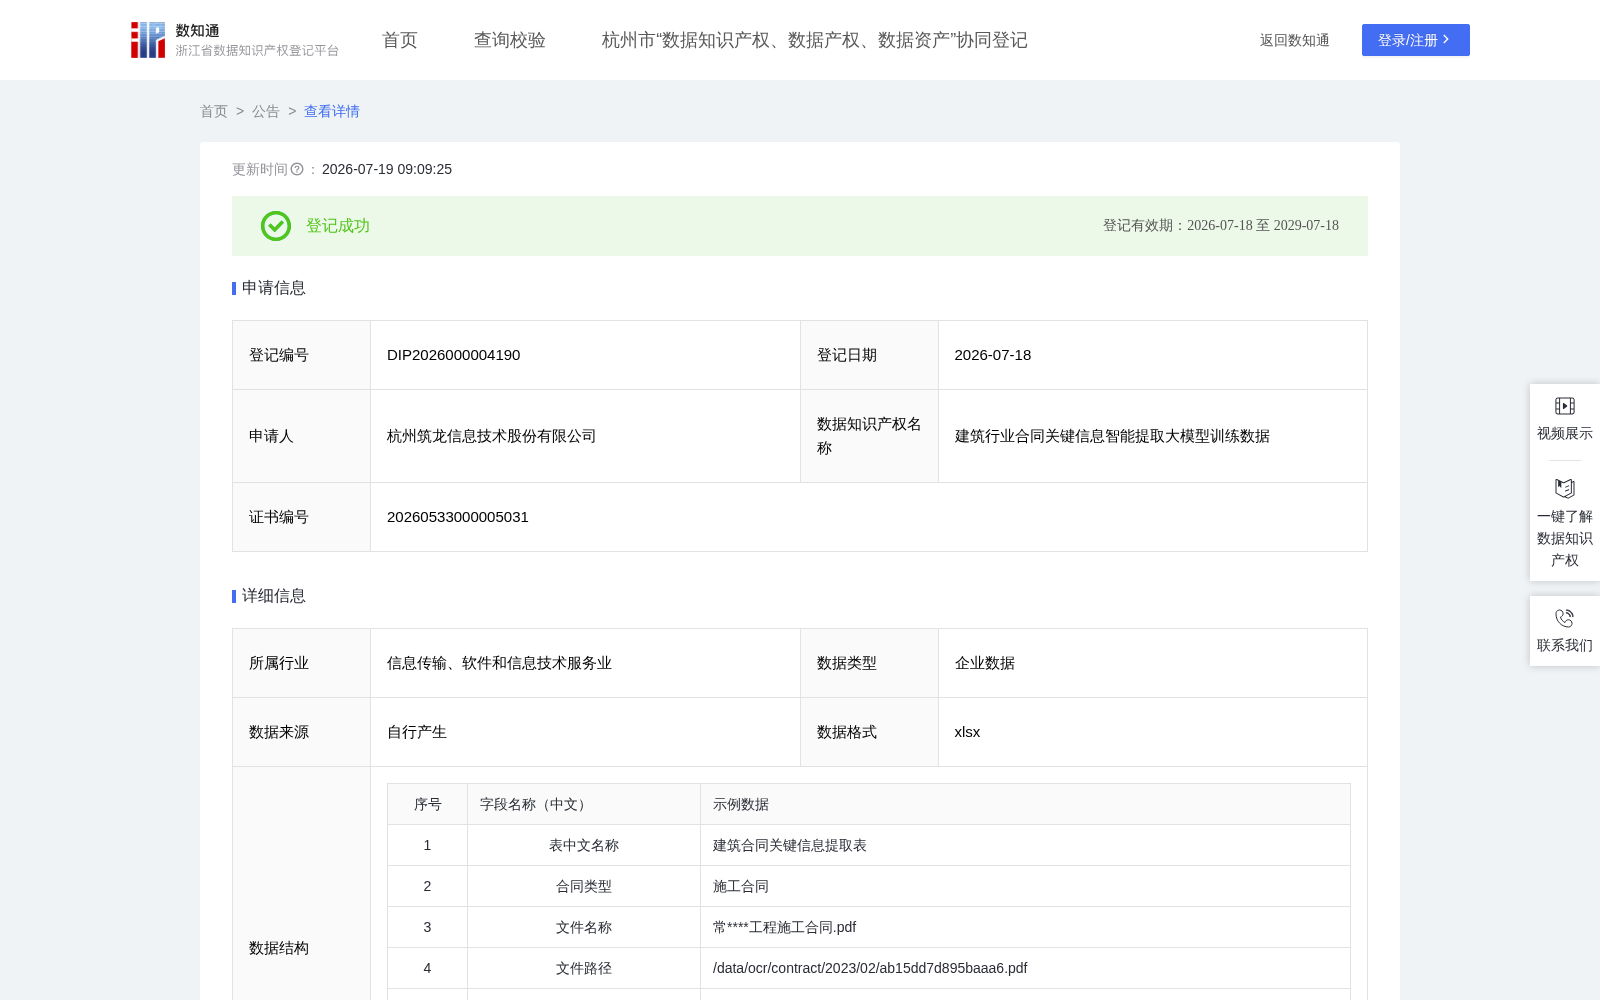
建筑行业合同关键信息智能提取大模型训练数据
收藏资源简介:
本数据集作为建筑行业合同关键信息智能提取大模型的核心训练语料,用于 RoBERTa-wwm-ext 预训练语言模型的领域微调,以及 BiLSTM-CRF 序列标注模型的训练,使模型能够准确识别合同中的甲方名称、乙方名称、合同金额、签订日期等 18 种关键实体。同时,数据集可支撑模型在 18 种提取场景下的端到端准确率评测、LOF 异常检测算法验证及置信度校准。基于提取结果,可构建建筑行业合同要素知识图谱,积累标准条款、付款方式等行业基准数据,并为智能合同管理、招投标辅助审核、财务结算对接等下游业务系统提供结构化数据支撑。一、数据清洗与标准化:一是去重处理,基于文件名称与提取场景组合键剔除重复记录;二是OCR识别校验,采用Tesseract OCR引擎开展字符级置信度验证,阈值设为0.85,低于阈值的结果标记为待人工复核;三是一致性校验,比对提取结果与标准答案,保障数据准确;四是信息脱敏,企业名称采用前1字+****+后4字脱敏;五是保留提取失败样本,提升模型对复杂合同版式的鲁棒性。 二、问题分类结构化:将合同提取场景分为三大类共18种。施工合同类含甲方乙方名称、项目名称、合同金额、签订日期等10种提取场景;劳务分包合同类涵盖分包范围、劳务人员数量、结算方式3种场景;采购合同类包含采购方与供应方名称、采购材料名称、交货期限、交货地点5种场景。 三、核心算法建模:OCR识别采用psm6、oem3模式,支持中英文混合识别,准确率≥98%。基于RoBERTa-wwm-ext模型结合BiLSTM-CRF模型完成深度语义解析与多实体一次性提取,输出实体类型、数值、位置及置信度。通过LOF局部异常因子算法完成异常检测,异常语料过滤率≥99%。依托关键词触发映射与多规则组合引擎,建立合同专业词汇与字段映射关系,结合NER识别结果综合提取多类关键字段,最后通过多维度逻辑核验,实现业务数据精准对齐。 四、语料库迭代优化:搭建应用-反馈-优化闭环机制,实时监控各场景提取正确率与置信度分布,针对错误样本溯源优化,定期注入新语料,持续扩充语料覆盖范围、提升合同关键信息提取准确率与模型稳定性。