
遇见数据集

persian-ocr-community-dataset-layout

收藏
Hugging Face2026-07-23 更新2026-07-24 收录
官方服务:

资源简介:

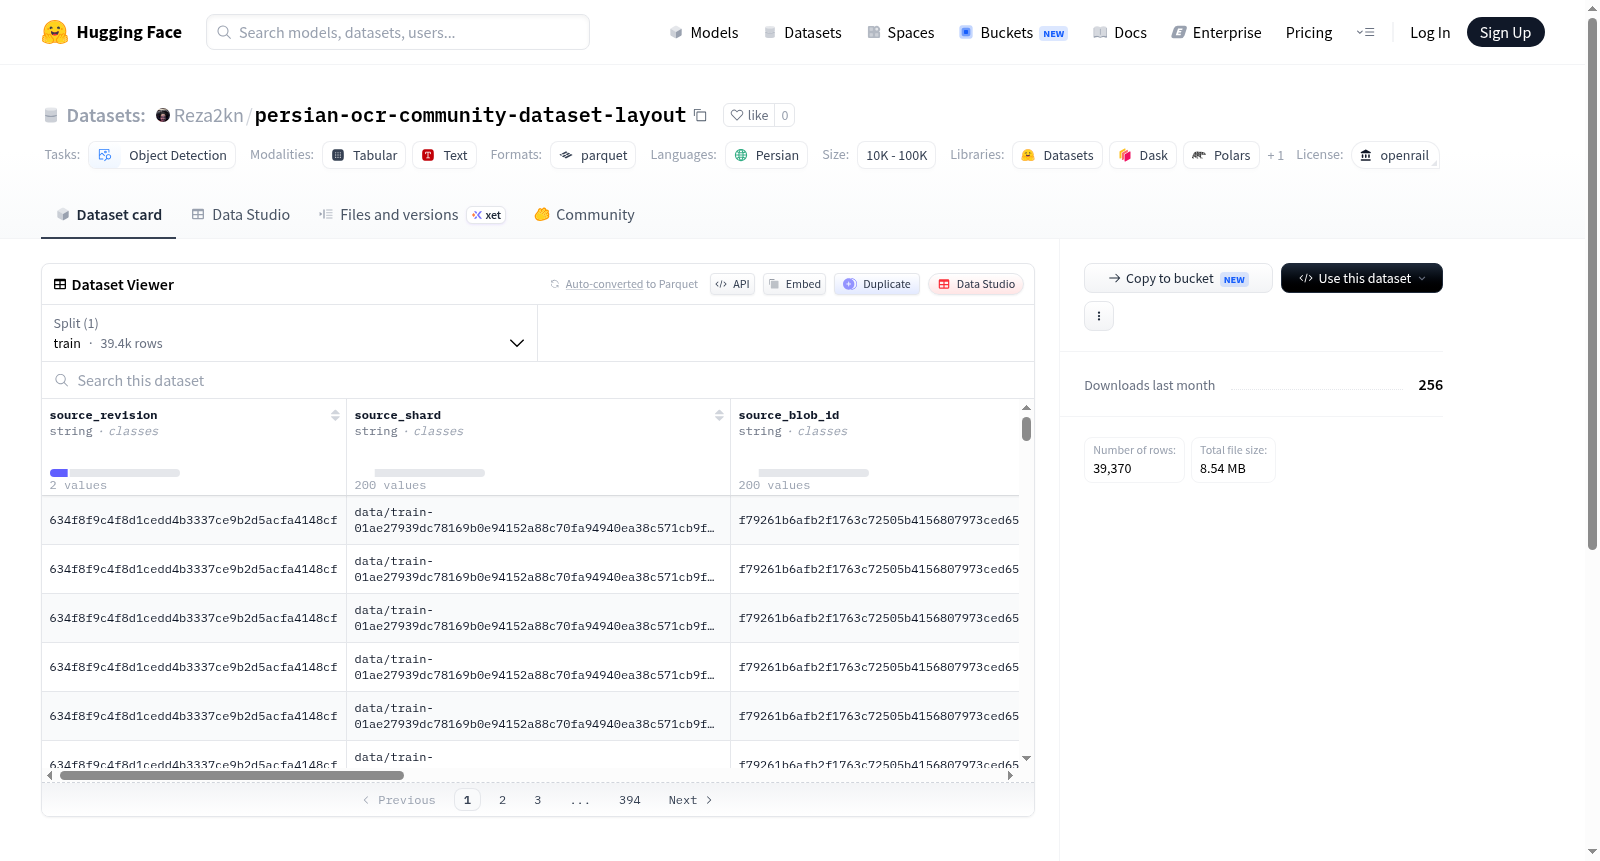
Persian OCR Community Layout Annotations 是一个用于目标检测任务的波斯语(fa)数据集,采用开放许可(openrail)。该数据集是 Reza2kn/persian-ocr-community-dataset 的补充标注集,专门为其页面图像提供可恢复的布局标注。数据集采用“sidecar”设计,标注数据与原始图像数据分离,图像本身仍保留在源数据集中。每一行数据都精确关联到源数据集的特定版本、Parquet分片、二进制大对象和行记录,包含页面标识符、页面尺寸、手写标志以及由 datalab-to/surya_layout2 模型在置信度阈值0.4下生成的、结构化的布局框。布局框信息存储在 `boxes` 字段中,具体包含:`label`(标签)、`confidence`(置信度)、光栅顺序的 `position`(位置)以及像素坐标 `x0`, `y0`, `x1`, `y1`。该数据集的设计旨在保持不断增长的源数据集的不可变性,并支持通过确定性连接进行边界框裁剪和下游的批处理Bina OCR任务。

Persian OCR Community Layout Annotations is a Persian (fa) dataset for object detection tasks, licensed under openrail. This dataset is a supplementary annotation set for Reza2kn/persian-ocr-community-dataset, specifically providing recoverable layout annotations for its page images. The dataset adopts a "sidecar" design, where annotation data is separated from the original image data, and the images themselves remain in the source dataset. Each data entry precisely links to a specific version, Parquet shards, Binary Large Object (BLOB), and row record of the source dataset, containing page identifiers, page dimensions, handwriting flags, and structured layout boxes generated by the datalab-to/surya_layout2 model with a confidence threshold of 0.4. The layout box information is stored in the `boxes` field, which specifically includes: `label`, `confidence`, the raster-ordered `position`, and pixel coordinates `x0`, `y0`, `x1`, `y1`. This dataset is designed to maintain the immutability of the ever-growing source dataset, and supports bounding box cropping and downstream batch-processed Bina OCR tasks via deterministic linking.

创建时间:
2026-07-22
原始信息汇总

数据集概述:Persian OCR Community Layout Annotations

  • 数据集名称:Persian OCR Community Layout Annotations
  • 许可证:openrail
  • 任务类别:目标检测(object-detection)
  • 语言:波斯语(fa)

内容与结构

该数据集为图像页面提供了可恢复的布局标注,图像来源自 Reza2kn/persian-ocr-community-dataset。每条数据记录指向源数据集的精确版本、Parquet 分片、二进制大对象(blob)及行,包含以下信息:

  • 页面标识符:唯一标识每个页面。
  • 页面尺寸:页面的宽度和高度。
  • 手写标识:指示页面是否为手写内容。
  • 结构化布局框:由 datalab-to/surya_layout2 模型生成,置信度阈值为 0.4。

字段说明

boxes 字段包含每条布局框的详细信息:

  • label:框的类别标签
  • confidence:模型置信度分数
  • position:按光栅顺序排列的位置信息
  • x0, y0, x1, y1:框的像素坐标(左上角和右下角)

设计特点

  • 侧车(Sidecar)设计:仅存储标注信息,图像保留在原始数据集中不重复存储。
  • 不可变源数据集:保持源数据集的可扩展性,支持确定性连接(join),可用于边界框裁剪和下游批处理 Bina OCR 任务。
搜集汇总
数据集介绍
persian-ocr-community-dataset-layout 数据集图片
构建方式
波斯语OCR社区布局注释数据集专为页面图像的版面分析而设计,其构建方式精巧而严谨。该数据集采用旁挂式设计,每个数据行精确指向源数据集`persian-ocr-community-dataset`的特定修订版本、Parquet分片、二进制大对象及其行索引,包含页面标识符、页面尺寸、手写体标记以及由`datalab-to/surya_layout2`模型在置信度阈值0.4下生成的版面框。这些版面框通过结构化格式存储,涵盖标签、置信度、光栅顺序位置和像素坐标,而原始图像则保留在源数据集中,避免冗余复制,确保数据源的简洁与一致性。
特点
该数据集的核心特性在于其高度结构化且可追溯的版面注释能力。每个版面框均携带了丰富的元信息,包括类别标签、置信度分数、光栅排序位置以及精确的像素坐标,为版面元素识别提供了坚实的数据基础。此外,手写体标记的引入使得数据集能够区分印刷与手写文本,显著增强了在多场景OCR任务中的适用性。旁挂式架构确保了源数据集的不可变性和可扩展性,支持确定性连接以进行边框裁剪与下游批处理Bina OCR操作,展现出卓越的灵活性与实用价值。
使用方法
使用该数据集时,研究人员可通过数据行中的精确指针直接访问源数据集中的对应图像,无需重复存储。随后,解析`boxes`字段中的版面框信息,利用其标签、置信度及像素坐标进行目标检测或版面分析模型的训练与评估。通过确定性连接机制,可高效完成边框裁剪任务,并将裁剪区域输入OCR模型进行文本识别。建议结合`persian-ocr-community-dataset`源数据集以及`datalab-to/surya_layout2`模型,以充分发挥该数据集的版面注释潜力,服务于波斯语文档分析的实际应用场景。
背景与挑战
背景概述
波斯语作为全球使用人数众多的语言之一,其历史文献与当代文档的数字化处理需求日益迫切。光学字符识别(OCR)技术虽在拉丁语系和汉字体系中取得显著进展,但针对波斯语这类从右至左书写、具有复杂连笔特征的语言,公开标注数据集仍极为匮乏。Persian OCR Community Layout Annotations数据集于2024年前后由Reza2kn及社区成员共同构建,旨在填补这一空白。该数据集聚焦于页面布局分析,为每张图像提供结构化标注,包括文本区、手写标记及坐标信息,解决了波斯语文档中多栏、非均匀排版等布局理解难题。通过将标注与源图像分离的“sidecar”设计,确保了数据集的持续扩展性与可重现性,为波斯语OCR系统的训练与评估提供了关键基础,有力推动了低资源语言文档分析领域的发展。
当前挑战
该数据集主要应对两大挑战。其一,领域问题层面,波斯语文档的OCR面临独特挑战:连笔字符导致字符分割困难,同一词汇在不同字体中形态差异显著,以及手写体与印刷体混合排版的普遍存在。当前主流OCR模型多基于二值化与连通域分析,难以处理这类高度非结构化的布局。其二,构建过程层面,数据来源庞杂,包含大量历史文档与现代印刷品,图像质量参差不齐,需统一分辨率、校正倾斜;标注一致性难以保证,不同标注者对文本区与手写区边界定义存在差异;模型生成的伪标签需经严格筛选,仅采纳置信度高于0.4的预测,但较低阈值可能引入噪声,需人工校验以平衡规模与精度。
常用场景
经典使用场景
在波斯语OCR与文档智能分析领域,精准的版面布局标注是提升识别精度的基石。该数据集作为经典使用场景,主要服务于页面级对象检测任务,为研究人员提供了包含文本区域、图像区块、表格结构等元素的精细化边界框与语义标签。通过引入手写标记和置信度阈值筛选的版面框,它使得模型能够区分手写与印刷体、定位内容层级,从而在复杂多栏或图文混排的波斯文文档中实现结构化解析。这一场景不仅支撑了传统的OCR管线优化,更成为多模态文档理解及版面还原等前沿探索的数据支撑。
衍生相关工作
围绕该数据集,研究社区已衍生出一系列具有代表性的经典工作。首先是基于该标注训练的开源版面分析模型,如经微调后的Surya Layout变体,其在波斯文上的检测精度显著优于通用英语模型;其次是结合该旁注数据集构建的端到端OCR管线,实现了从图像输入到结构化文本输出的全流程优化。此外,多篇学术论文将其作为主干数据,探讨了在低资源语境下利用对比学习增强版面特征表达的方法,以及利用其水印设计进行数据溯源与版本管理的研究,丰富了文档智能领域的方法论体系。
数据集最近研究
最新研究方向
当前,波斯语OCR领域正迈向精细化布局分析与多模态文档理解的前沿。该数据集通过侧载设计,为大规模波斯文页面图像提供可追溯、不可变且可恢复的布局标注,涵盖文本块、段落、表格等结构化元素。结合surya_layout2等先进模型,研究者可高效开展版面级目标检测、OCR前处理优化及手写与印刷文本的区分任务。这一资源有力推动了低资源语种文档智能化的进程,尤其在文化遗产数字化、官方档案自动化处理等热点应用中展现出关键价值,为构建高精度、可扩展的波斯语OCR系统奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

