
JUNJIE99/VISTA_S2
收藏官方服务:
资源简介:
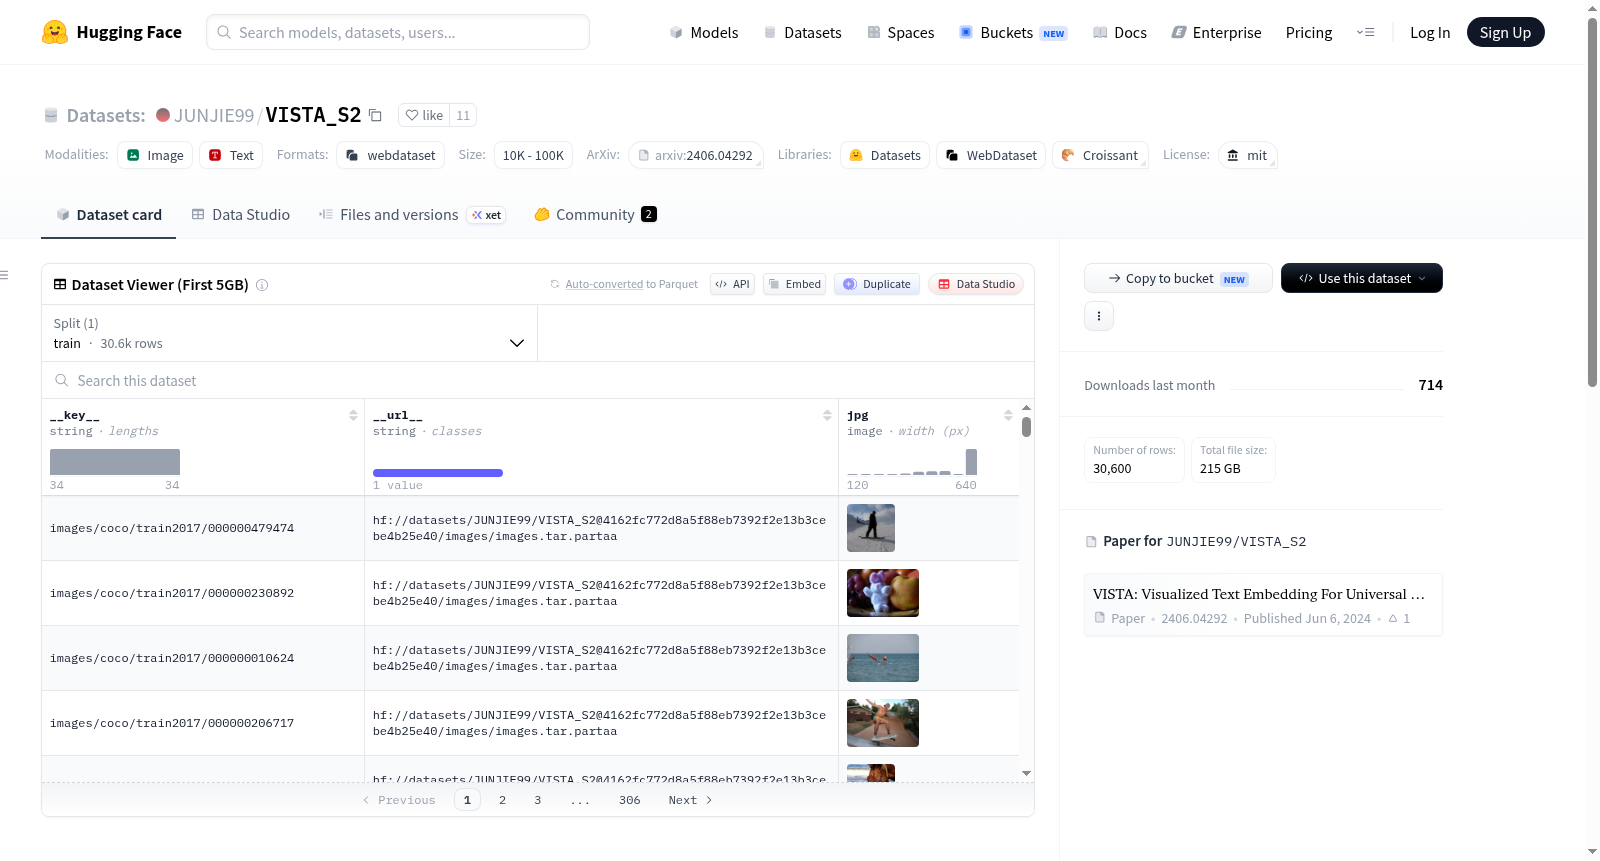
该数据集是一个混合多模态数据集,包含超过500,000个实例,用于多模态训练(论文中的第二阶段训练)。数据集可以从提供的Hugging Face链接下载,并包含图像压缩包,处理命令也在文件中提供。
This is a hybrid multimodal dataset containing over 500,000 instances, designed for multimodal training (the second-stage training mentioned in the accompanying paper). The dataset can be downloaded via the provided Hugging Face link, includes image compression packages, and the relevant processing commands are provided in the accompanying files.
提供机构:
JUNJIE99原始信息汇总
数据集概述
- 数据集名称: VISTA_S2
- 数据集类型: 混合多模态数据集
- 数据量: 超过500,000个实例
- 用途: 用于多模态训练(论文中的第二阶段训练)
- 下载链接: 🤗 HF Link
数据处理
-
图像压缩包处理: bash cat images.tar.part* > images.tar tar -xvf images.tar
-
目录结构:
images |__coco |__edit_image
引用信息
- 论文标题: VISTA: Visualized Text Embedding For Universal Multi-Modal Retrieval
- 作者: Zhou, Junjie and Liu, Zheng and Xiao, Shitao and Zhao, Bo and Xiong, Yongping
- 预印本链接: arXiv:2406.04292
- 年份: 2024
搜集汇总
数据集介绍
构建方式
VISTA_S2数据集隶属于Visualized BGE项目,旨在支持多模态检索任务的训练。该数据集通过混合生成方式构建,包含超过50万条多模态实例,专门用于论文中所述的第二阶段训练。图像数据以压缩包形式提供,需通过命令行分卷解压,解压后目录结构包含coco与edit_image两个子文件夹,分别对应不同来源的视觉内容。标注信息以jsonl格式存储,确保数据与注释的灵活关联,便于后续训练流程的集成。
特点
该数据集的核心特点在于其混合多模态属性,融合了来自COCO数据集与编辑图像的多源视觉数据,覆盖广泛场景与语义变化。超过50万条实例的庞大规模为模型提供了丰富的训练样本,有助于提升多模态检索的泛化能力。数据集的构建紧密结合VISTA模型的训练需求,特别针对多模态表示学习优化,使得模型能够同时处理文本与视觉信息的对齐与检索任务。
使用方法
使用VISTA_S2数据集时,首先需通过cat命令合并分卷压缩包并解压,获得完整的images目录。随后,可利用提供的jsonl注释文件进行模型训练,每个jsonl条目包含图像路径与对应的文本描述或标签。用户可根据自身框架需求,加载图像数据与注释,构建数据加载器。该数据集适用于多模态嵌入模型的第二阶段微调,尤其针对需要视觉文本联合训练的检索场景,可直接集成至FlagEmbedding等开源工具链中。
背景与挑战
背景概述
VISTA_S2数据集由北京智源人工智能研究院(BAAI)的研究团队于2024年创建,主要研究人员包括周俊杰、刘正、肖诗涛、赵波和熊永平。该数据集是《VISTA: Visualized Text Embedding For Universal Multi-Modal Retrieval》项目的核心组成部分,旨在解决多模态检索领域中文本与视觉信息难以统一表征的瓶颈问题。通过构建超过50万条混合多模态实例,VISTA_S2为多模态模型的第二阶段训练提供了丰富的对齐数据,推动了视觉语言模型在跨模态理解任务中的发展。该数据集的开源发布,对多模态嵌入学习领域产生了重要影响,为后续研究奠定了数据基础。
当前挑战
VISTA_S2数据集所面临的挑战主要源于多模态检索中模态异构性的复杂性。首先,在领域问题层面,如何实现文本与图像在统一语义空间中的精确对齐,克服不同模态间的语义鸿沟,是核心难题。其次,在数据集构建过程中,团队需处理海量图像与文本的自动标注与清洗,确保数据质量与多样性。此外,图像压缩包的分卷存储与解压流程增加了数据分发的技术门槛,而跨数据集(如COCO和编辑图像)的整合也带来了格式与标注一致性上的挑战。这些因素共同构成了VISTA_S2在推动多模态统一检索研究时必须克服的关键障碍。
常用场景
经典使用场景
在跨模态检索领域,VISTA_S2数据集作为视觉与语言表征对齐的桥梁,广泛应用于多模态嵌入模型的训练与评估。该数据集包含逾五十万条混合多模态实例,覆盖COCO及图像编辑等多样化场景,为学习图像与文本之间的语义映射提供了丰富的监督信号。研究者常借助此数据集微调视觉语言模型,以提升其在图文匹配、视觉问答及跨模态搜索等任务中的泛化能力,成为推动多模态理解走向统一表征的关键基石。
实际应用
在实际应用中,VISTA_S2数据集赋能了智能搜索、内容推荐与辅助设计等系统。例如,电商平台可借助基于此数据集训练的模型实现以图搜图或图文混合检索,精准匹配用户意图;社交媒体中则能优化图像标签生成与跨语言内容理解。此外,该数据集还支持图像编辑场景下的语义一致性校验,为创意工具提供智能化的视觉反馈,显著提升了人机交互的流畅度与效率。
衍生相关工作
围绕VISTA_S2数据集,衍生出了一系列标志性工作,如VISTA模型本身即基于此数据集进行第二阶段训练,实现了视觉化文本嵌入的统一多模态检索。后续研究进一步借鉴其数据构建范式,开发出针对视频与文本对齐的扩展版本,以及面向细粒度跨模态推理的增强型模型。这些工作共同丰富了多模态学习的生态,验证了大规模混合数据集在推动表征通用性方面的核心价值。
以上内容由遇见数据集搜集并总结生成


