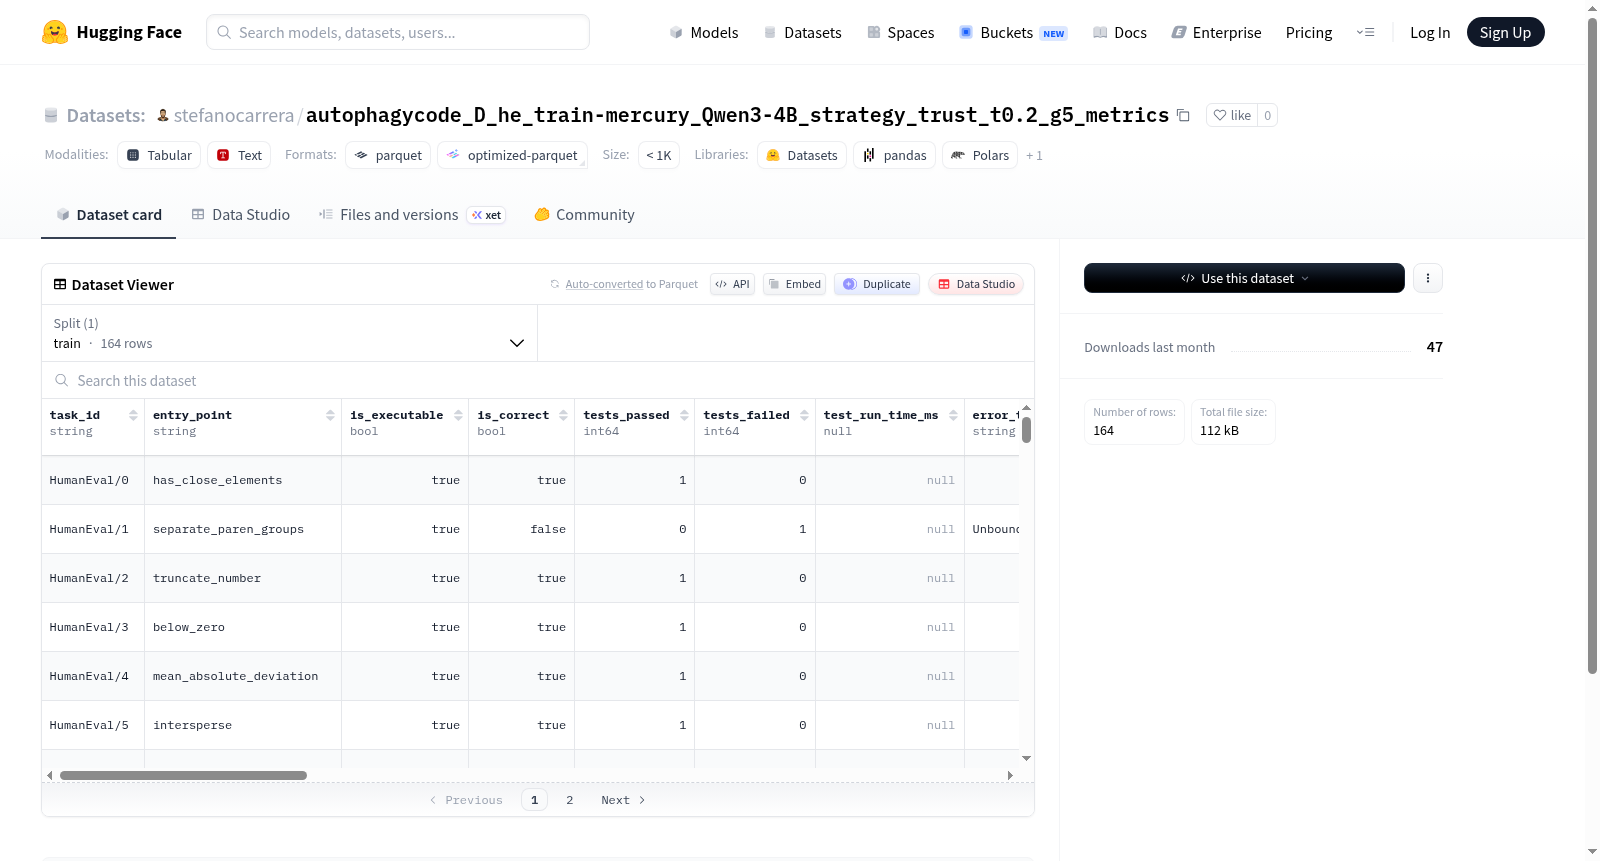
autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t0.2_g5_metrics
收藏资源简介:
该数据集是一个面向代码分析与质量评估的专用数据集,包含164个训练样本,总大小为254,410字节。数据集提供了丰富的代码特征指标,包括任务ID、可执行状态、正确性标记、通过/失败的测试数量、各类Halstead复杂度指标(词汇量、长度、体积、难度、工作量、时间)、圈复杂度、可维护性指数、代码行数(LOC/SLOC)、注释比例、词汇多样性(TTR)、函数定义数量等。此外还包含代码执行相关的元数据(如入口点重复标记)和熵值计算指标(香农熵、预测熵)。这些结构化数据适用于软件工程领域的代码质量评估、缺陷预测、自动化测试验证等任务。
This is a specialized dataset tailored for code analysis and quality assessment. It contains 164 training samples, with a total size of 254,410 bytes. The dataset provides comprehensive code feature metrics, including task ID, executable status, correctness label, number of passed/failed tests, various Halstead complexity metrics (vocabulary size, length, volume, difficulty, effort, programming time), cyclomatic complexity, maintainability index, lines of code (LOC/SLOC), comment ratio, lexical diversity (TTR), number of function definitions, etc. In addition, it also includes metadata related to code execution (such as entry point duplication flag) and entropy calculation metrics (Shannon entropy, predictive entropy). This structured data is suitable for tasks such as code quality assessment, defect prediction and automated test validation in the field of software engineering.
根据您提供的数据集详情页面内容,以下是对该数据集的总结:
数据集概述
- 数据集名称:autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t0.2_g5_metrics
- 数据集地址:https://huggingface.co/datasets/stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t0.2_g5_metrics
- 数据集大小:下载大小为 107,781 字节(约105 KB),数据集总大小为 254,410 字节(约248 KB)
数据集结构
该数据集仅包含一个分割(split)—— train(训练集),共包含 164 个样本。
特征字段
数据集包含以下26个特征字段,涵盖了代码任务、代码质量指标和复杂性度量:
| 字段名称 | 数据类型 | 说明 |
|---|---|---|
| task_id | string | 任务标识符 |
| entry_point | string | 入口函数 |
| is_executable | bool | 代码是否可执行 |
| is_correct | bool | 代码是否正确 |
| tests_passed | int64 | 通过的测试数 |
| tests_failed | int64 | 失败的测试数 |
| test_run_time_ms | null | 测试运行时间(毫秒) |
| error_type | string | 错误类型 |
| halstead_vocabulary | int64 | Halstead 词汇量 |
| halstead_length | int64 | Halstead 长度 |
| halstead_volume | float64 | Halstead 体积 |
| halstead_difficulty | float64 | Halstead 难度 |
| halstead_effort | float64 | Halstead 工作量 |
| halstead_time | float64 | Halstead 时间 |
| cyclomatic_complexity | int64 | 圈复杂度 |
| maintainability_index | float64 | 可维护性指数 |
| loc | int64 | 代码总行数 |
| sloc | int64 | 代码有效行数 |
| comment_percentage | float64 | 注释百分比 |
| TTR | float64 | 类型令牌比 |
| token_dict | string | 令牌字典 |
| shannon_entropy | float64 | 香农熵 |
| mean_predictive_entropy | float64 | 平均预测熵 |
| max_predictive_entropy | float64 | 最大预测熵 |
| n_func_defined | int64 | 定义的函数数量 |
| entry_point_repeated | bool | 入口点是否重复 |
配置信息
- 配置名称:default
- 数据文件路径:
data/train-*(训练集数据文件)