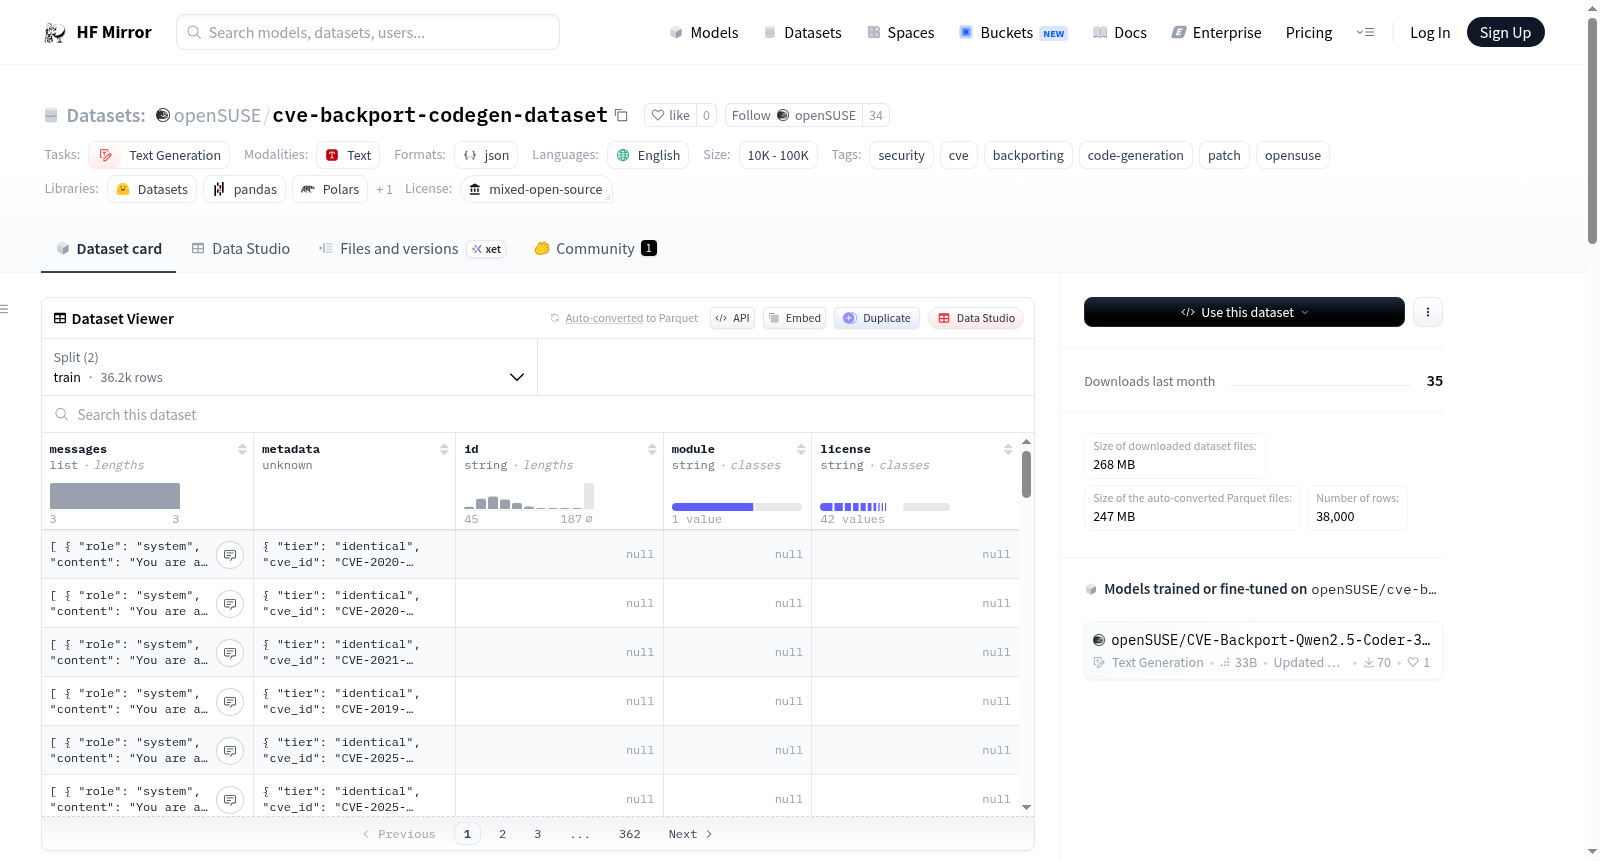
openSUSE/cve-backport-codegen-dataset
收藏资源简介:
--- license: other license_name: mixed-open-source license_link: LICENSE task_categories: - text-generation language: - en tags: - security - cve - backporting - code-generation - patch - opensuse size_categories: - 10K<n<100K --- # CVE Backport Code Generation Dataset Per-hunk code generation dataset for CVE security patch backporting, derived from openSUSE Build Service maintenance patches. ## Task Given a region of vulnerable source code and a description of the upstream CVE fix, the model outputs the **fixed version of the code**. A programmatic diff then produces the final patch. This plays to LLM strengths in code completion and avoids format-sensitivity issues with direct diff generation. ## Files | File | Examples | Description | |------|----------|-------------| | `train.jsonl` | 36,166 | **Latest (v5)** — all 3-turn codegen, no test generation | | `eval.jsonl` | 1,834 | Held-out evaluation set (unchanged across versions) | ## Version History | Version | Examples | What changed | |---------|----------|-------------| | **v5** | 36,166 | All examples converted to 3-turn codegen (removed 772 five-turn test-gen examples from v4). Codegen-only focus improved adapted-tier recall from 86% to 90% | | **v4** | 36,168 | +501 examples from source matching fix, 772 five-turn examples with CVE test cases | | **v3** | 35,778 | Cleaned v2: removed 186 toxic examples (XML test data, DH prime tables, assembly blobs) | | **v2** | 24,452 | Synthetic cross-version augmentation (+7,445 adapted-tier examples), more packages | | **v1** | 17,007 | Initial dataset: per-hunk code generation from openSUSE maintenance patches | ## Format All v5 examples use 3-turn ChatML format (system / user / assistant): ```json { "messages": [ {"role": "system", "content": "You are a security patch backporting assistant..."}, {"role": "user", "content": "## File: lib/url.c\n## Lines: 100-130\n\n```c\n{vulnerable code}\n```\n\n## Fix\nCVE-2024-1234: description"}, {"role": "assistant", "content": "{fixed code}"} ], "metadata": { "cve_id": "CVE-2024-1234", "package": "curl", "language": "c", "tier": "identical", "suse_license": "MIT" } } ``` ## Coverage - **2,300+ CVEs** across **145 packages** - Languages: C (80%), Python (7%), C++ (3%), Shell, Perl, JavaScript, Java, Go, PHP, Ruby - Tiers: identical (patch applies directly), adapted (context differs), synthetic-adapted (cross-version augmentation) - **99.8% per-example SPDX license metadata** ## Licenses All training examples are derived from publicly available openSUSE Build Service maintenance patches. Per-example license metadata is in `metadata.suse_license`. The most common licenses are: LGPL-2.1-or-later, OpenSSL, GPL-2.0-only, MIT, PHP-3.01, Apache-2.0, GPL-2.0-or-later, BSD-3-Clause, GPL-3.0-or-later, BSD-2-Clause, Python-2.0, MPL-2.0, ImageMagick ## Model Trained models are at [openSUSE/CVE-Backport-Qwen2.5-Coder-32B](https://huggingface.co/openSUSE/CVE-Backport-Qwen2.5-Coder-32B). The CLI tool for using the model is at [github.com/openSUSE/cve-backport-tool](https://github.com/openSUSE/cve-backport-tool).
许可证:其他 许可证名称:混合开源 许可证链接:LICENSE 任务类别: - 文本生成 语言: - 英语 标签: - 安全 - 通用漏洞与披露(CVE) - 补丁向后移植 - 代码生成 - 补丁 - openSUSE 样本规模: - 10000~100000 # CVE补丁向后移植代码生成数据集 面向通用漏洞与披露(CVE)安全补丁向后移植的逐代码块代码生成数据集,数据源自openSUSE构建服务的维护补丁。 ## 任务说明 给定存在漏洞的源代码片段与上游CVE补丁的描述信息,模型将输出该代码的修复版本,随后通过程序化差异(diff)生成最终补丁。该任务适配大语言模型在代码补全方面的能力优势,同时规避了直接生成差异补丁时对格式的敏感性问题。 ## 数据集文件 | 文件 | 样本数量 | 描述 | |------|----------|-------------| | `train.jsonl` | 36166 | **最新版(v5)** —— 全部采用3轮代码生成格式,无测试生成内容 | | `eval.jsonl` | 1834 | 预留评估集(各版本保持一致) | ## 版本历史 | 版本 | 样本数量 | 变更内容 | |---------|----------|-------------| | **v5** | 36166 | 所有样本均转换为3轮代码生成格式(移除了v4版本中的772条5轮测试生成样本)。仅聚焦代码生成的调整将适配型召回率从86%提升至90% | | **v4** | 36168 | 新增501条与修复匹配的源样本,以及772条包含CVE测试用例的5轮样本 | | **v3** | 35778 | 基于v2进行清洗:移除了186条有害样本(XML测试数据、DH质数表、汇编二进制块) | | **v2** | 24452 | 新增跨版本合成增强数据(7445条适配型样本),覆盖更多软件包 | | **v1** | 17007 | 初始数据集:基于openSUSE维护补丁生成的逐代码块代码生成数据集 | ## 数据格式 所有v5版本的样本均采用3轮ChatML格式(系统提示/用户提示/助手回复): json { "messages": [ {"role": "system", "content": "你是一名安全补丁向后移植助手……"}, {"role": "user", "content": "## 文件:lib/url.c ## 行范围:100-130 c {存在漏洞的代码} ## 补丁说明 CVE-2024-1234:描述信息"}, {"role": "assistant", "content": "{修复后的代码}"} ], "metadata": { "cve_id": "CVE-2024-1234", "package": "curl", "language": "C", "tier": "identical", "suse_license": "MIT" } } ## 覆盖范围 - **2300+ 个CVE** 覆盖 **145个软件包** - 开发语言:C语言(80%)、Python(7%)、C++(3%)、Shell、Perl、JavaScript、Java、Go、PHP、Ruby - 适配等级:完全匹配(补丁可直接应用)、适配型(上下文存在差异)、合成适配型(跨版本合成增强数据) - **99.8% 的样本带有SPDX许可证元数据** ## 许可证说明 所有训练样本均源自公开可用的openSUSE构建服务维护补丁。每条样本的许可证元数据存储于`metadata.suse_license`字段中。最常见的许可证包括: LGPL-2.1-or-later、OpenSSL、GPL-2.0-only、MIT、PHP-3.01、Apache-2.0、GPL-2.0-or-later、BSD-3-Clause、GPL-3.0-or-later、BSD-2-Clause、Python-2.0、MPL-2.0、ImageMagick ## 模型与工具 训练得到的模型托管于 [openSUSE/CVE-Backport-Qwen2.5-Coder-32B](https://huggingface.co/openSUSE/CVE-Backport-Qwen2.5-Coder-32B)。 该模型的命令行工具托管于 [github.com/openSUSE/cve-backport-tool](https://github.com/openSUSE/cve-backport-tool)。