
trl-lib/kto-mix-14k
收藏官方服务:
资源简介:
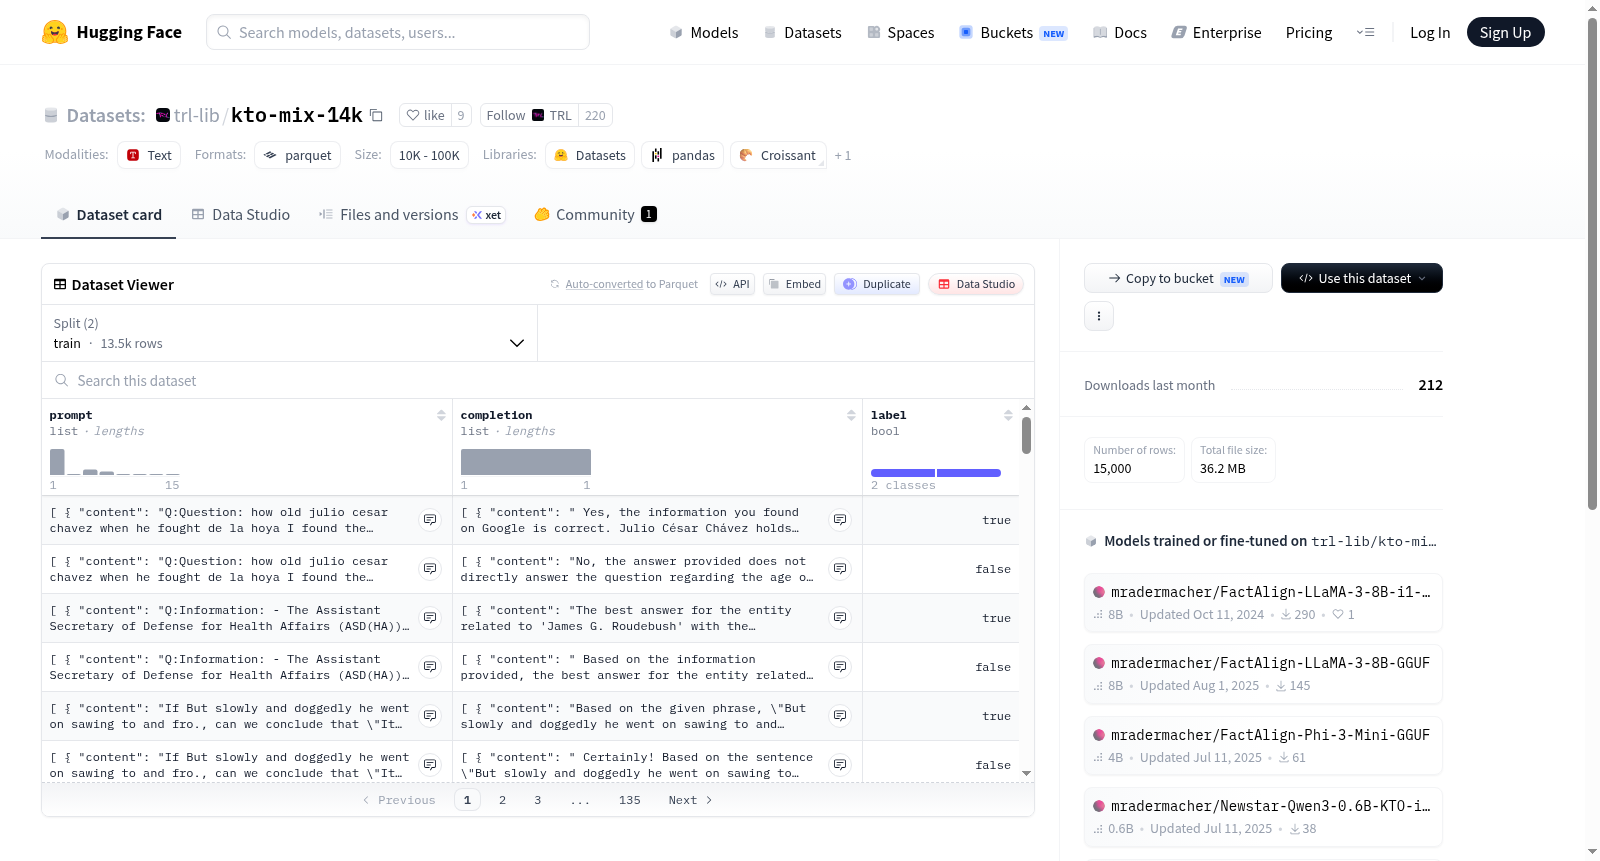
该数据集是KTO格式的版本,基于argilla/dpo-mix-7k数据集。数据集包含prompt、completion和label三个特征,其中prompt和completion都是包含content和role的列表,label是布尔类型。数据集分为train和test两个部分,分别包含13500和1500个示例。
该数据集是KTO格式的版本,基于argilla/dpo-mix-7k数据集。数据集包含prompt、completion和label三个特征,其中prompt和completion都是包含content和role的列表,label是布尔类型。数据集分为train和test两个部分,分别包含13500和1500个示例。
提供机构:
trl-lib原始信息汇总
数据集概述
数据集名称
- trl-lib/kto-mix-14k
数据集特征
- prompt
- content (dtype: string)
- role (dtype: string)
- completion
- content (dtype: string)
- role (dtype: string)
- label (dtype: bool)
数据集分割
- train
- num_examples: 13500
- num_bytes: 40982405
- test
- num_examples: 1500
- num_bytes: 4544225
数据集大小
- download_size: 18071772
- dataset_size: 45526630
配置文件
- config_name: default
- data_files
- split: train, path: data/train-*
- split: test, path: data/test-*
- data_files
搜集汇总
数据集介绍
构建方式
在偏好对齐与强化学习领域,高质量反馈数据的稀缺性始终是制约模型性能提升的关键瓶颈。为应对这一挑战,trl-lib/kto-mix-14k数据集应运而生,它是对广受认可的argilla/dpo-mix-7k数据集进行KTO格式转换的产物。该数据集通过将原始的DPO偏好对数据重构为KTO所需的隐式反馈格式,保留了prompt与completion的对话结构,同时引入布尔型标签以区分正负样本,从而实现了从二元偏好到隐式反馈的无缝迁移。这种构建策略不仅充分利用了现有优质数据资源,还拓展了其在KTO训练框架下的适用场景。
特点
该数据集最显著的特征在于其精巧的格式设计与规模平衡。它包含13500条训练样本与1500条测试样本,总容量约45.5MB,在保证数据多样性的同时避免了过度冗余。每个样本由prompt和completion两个对话片段构成,每个片段均明确标注角色与内容,这种结构化设计便于模型精准理解上下文。尤为重要的是,布尔型标签的引入使数据能够直接用于KTO算法的隐式反馈学习,无需额外转换,显著降低了使用门槛。此外,数据集源自经过验证的dpo-mix-7k,确保了反馈信号的可靠性与一致性。
使用方法
使用trl-lib/kto-mix-14k数据集时,推荐通过Hugging Face Datasets库加载,利用默认配置即可直接获取划分好的训练集与测试集。在模型训练中,可将prompt字段作为输入,completion字段作为生成目标,并依据label字段进行KTO损失计算。具体而言,当label为True时,该样本视为正反馈,模型应强化对应completion的生成概率;反之则为负反馈,需降低该路径的生成倾向。为确保数据兼容性,建议使用支持对话格式的tokenizer进行预处理,并将prompt与completion拼接为符合模型输入规范的序列。
背景与挑战
背景概述
在大语言模型对齐研究中,基于人类反馈的强化学习(RLHF)及其变体如直接偏好优化(DPO)已成为提升模型行为与人类价值观一致性的核心技术。然而,DPO方法依赖于成对偏好数据,其构建成本高昂且难以扩展。为突破这一瓶颈,Kahneman-Tversky优化(KTO)作为一种无需偏好对的对齐方法应运而生,其仅需对单个输出进行“好”或“坏”的二元标注即可驱动模型优化。trl-lib/kto-mix-14k数据集正是为支持KTO训练而创建,由HuggingFace的trl团队于2024年基于argilla/dpo-mix-7k改造而来。该数据集包含14,000个样本,划分为13,500条训练集与1,500条测试集,每条数据由提示(prompt)、生成内容(completion)及二元标签(label)构成,旨在为KTO方法提供标准化的训练基准。该数据集的出现填补了KTO训练数据稀缺的空白,推动了无需偏好对的对齐研究从理论走向实践,成为评估KTO算法性能的重要基准资源。
当前挑战
该数据集所解决的领域问题在于:传统RLHF或DPO方法依赖大量成对偏好数据,而KTO通过引入二元标签机制降低了对数据结构的严苛要求,但随之而来的挑战是二元标签的语义模糊性——仅凭“好”与“坏”的标注难以精准反映人类偏好的细微差别,可能导致模型在复杂场景下产生不一致的对齐效果。在数据集构建过程中,由于kto-mix-14k是对dpo-mix-7k的格式转换,原始DPO数据中的成对偏好信息被压缩为单一标签,这一过程不可避免地丢失了偏好强度与相对排序信息,使得标签质量高度依赖原始数据集的标注一致性。此外,数据集规模仅14k,对于需要大量训练数据的现代大语言模型而言,样本多样性不足可能限制KTO方法在长尾分布或专业领域中的泛化能力,同时二元标签的噪声敏感性也要求模型具备更强的鲁棒性,这对KTO算法的设计提出了更高要求。
常用场景
经典使用场景
在偏好对齐与人类反馈强化学习领域,trl-lib/kto-mix-14k数据集作为KTO(Kahneman-Tversky Optimization)格式的经典基准,被广泛用于训练语言模型以理解人类偏好。该数据集将原始DPO格式的二元偏好对转化为KTO所需的隐式反馈信号,通过14k条精心构建的提示-完成对及对应的布尔标签,为研究者提供了探索非显式偏好建模的标准化平台。其核心应用在于评估和优化模型在无需显式比较偏好对时的对齐能力,尤其适用于需要从二元反馈中学习奖励模型的场景,如ChatGPT风格对话系统的微调。
实际应用
在实际应用中,该数据集被用于构建更符合人类偏好的智能客服、内容生成和对话系统。例如,企业可利用其训练模型自动筛选符合品牌调性的回复,或优化推荐系统中的个性化响应。在内容审核领域,基于该数据集微调的模型能更精准地识别有害内容,因为二元标签(接受/拒绝)天然适配审核决策场景。此外,教育辅助工具、心理健康支持系统等需谨慎表达的应用中,该数据集帮助模型学会在敏感话题上提供恰当反馈,显著提升了人机交互的信任度与安全性。
衍生相关工作
该数据集衍生了一系列重要工作,包括KTO优化算法的理论扩展(如KTO+)、多模态偏好对齐研究(将KTO应用于图像-文本对齐)以及跨语言偏好迁移学习。其前身argilla/dpo-mix-7k催生了DPO到KTO的格式转换方法论,而trl-lib/kto-mix-14k本身则直接支撑了TRL库中KTO训练器的开发。后续研究者基于该数据集提出了动态阈值KTO、混合偏好学习等变体,并探索了其在弱监督偏好对齐中的潜力,形成了从数据构建到算法优化的完整研究链条。
以上内容由遇见数据集搜集并总结生成


