
alexandrainst/m_mmlu
收藏官方服务:
资源简介:
该数据集是[MMLU数据集](https://huggingface.co/datasets/cais/mmlu)的机器翻译版本。冰岛语(is)部分使用了Miðeind的Greynir模型进行翻译,挪威语(nb)部分使用了DeepL进行翻译,其余语言使用了GPT-3.5-turbo进行翻译。这部分数据集最初上传至[这个Github仓库](https://github.com/nlp-uoregon/mlmm-evaluation)。
This dataset is a machine-translated variant of the [MMLU dataset](https://huggingface.co/datasets/cais/mmlu). The Icelandic (is) subset was translated using Miðeind's Greynir model, the Norwegian Bokmål (nb) subset was translated using DeepL, and all other language subsets were translated using GPT-3.5-turbo. This dataset was originally uploaded to [this GitHub repository](https://github.com/nlp-uoregon/mlmm-evaluation).
提供机构:
alexandrainst原始信息汇总
多语言MMLU数据集
数据集概述
该数据集是MMLU数据集的机器翻译版本。
配置详情
数据集包含以下语言的配置:
- 阿拉伯语 (ar)
- 训练集:
data/ar/train.jsonl - 验证集:
data/ar/val.jsonl - 测试集:
data/ar/test.jsonl
- 训练集:
- 孟加拉语 (bn)
- 训练集:
data/bn/train.jsonl - 验证集:
data/bn/val.jsonl - 测试集:
data/bn/test.jsonl
- 训练集:
- 加泰罗尼亚语 (ca)
- 训练集:
data/ca/train.jsonl - 验证集:
data/ca/val.jsonl - 测试集:
data/ca/test.jsonl
- 训练集:
- 丹麦语 (da)
- 训练集:
data/da/train.jsonl - 验证集:
data/da/val.jsonl - 测试集:
data/da/test.jsonl
- 训练集:
- 德语 (de)
- 训练集:
data/de/train.jsonl - 验证集:
data/de/val.jsonl - 测试集:
data/de/test.jsonl
- 训练集:
- 英语 (en)
- 训练集:
data/en/train.jsonl - 验证集:
data/en/val.jsonl - 测试集:
data/en/test.jsonl
- 训练集:
- 西班牙语 (es)
- 训练集:
data/es/train.jsonl - 验证集:
data/es/val.jsonl - 测试集:
data/es/test.jsonl
- 训练集:
- 巴斯克语 (eu)
- 训练集:
data/eu/train.jsonl - 验证集:
data/eu/val.jsonl - 测试集:
data/eu/test.jsonl
- 训练集:
- 法语 (fr)
- 训练集:
data/fr/train.jsonl - 验证集:
data/fr/val.jsonl - 测试集:
data/fr/test.jsonl
- 训练集:
- 古吉拉特语 (gu)
- 训练集:
data/gu/train.jsonl - 验证集:
data/gu/val.jsonl - 测试集:
data/gu/test.jsonl
- 训练集:
- 印地语 (hi)
- 训练集:
data/hi/train.jsonl - 验证集:
data/hi/val.jsonl - 测试集:
data/hi/test.jsonl
- 训练集:
- 克罗地亚语 (hr)
- 训练集:
data/hr/train.jsonl - 验证集:
data/hr/val.jsonl - 测试集:
data/hr/test.jsonl
- 训练集:
- 匈牙利语 (hu)
- 训练集:
data/hu/train.jsonl - 验证集:
data/hu/val.jsonl - 测试集:
data/hu/test.jsonl
- 训练集:
- 亚美尼亚语 (hy)
- 训练集:
data/hy/train.jsonl - 验证集:
data/hy/val.jsonl - 测试集:
data/hy/test.jsonl
- 训练集:
- 印度尼西亚语 (id)
- 训练集:
data/id/train.jsonl - 验证集:
data/id/val.jsonl - 测试集:
data/id/test.jsonl
- 训练集:
- 冰岛语 (is)
- 训练集:
data/is/train.jsonl - 验证集:
data/is/val.jsonl - 测试集:
data/is/test.jsonl
- 训练集:
- 意大利语 (it)
- 训练集:
data/it/train.jsonl - 验证集:
data/it/val.jsonl - 测试集:
data/it/test.jsonl
- 训练集:
- 卡纳达语 (kn)
- 训练集:
data/kn/train.jsonl - 验证集:
data/kn/val.jsonl - 测试集:
data/kn/test.jsonl
- 训练集:
- 马拉雅拉姆语 (ml)
- 训练集:
data/ml/train.jsonl - 验证集:
data/ml/val.jsonl - 测试集:
data/ml/test.jsonl
- 训练集:
- 马拉地语 (mr)
- 训练集:
data/mr/train.jsonl - 验证集:
data/mr/val.jsonl - 测试集:
data/mr/test.jsonl
- 训练集:
- 挪威语 (nb)
- 训练集:
data/nb/train.jsonl - 验证集:
data/nb/val.jsonl - 测试集:
data/nb/test.jsonl
- 训练集:
- 尼泊尔语 (ne)
- 训练集:
data/ne/train.jsonl - 验证集:
data/ne/val.jsonl - 测试集:
data/ne/test.jsonl
- 训练集:
- 荷兰语 (nl)
- 训练集:
data/nl/train.jsonl - 验证集:
data/nl/val.jsonl - 测试集:
data/nl/test.jsonl
- 训练集:
- 葡萄牙语 (pt)
- 训练集:
data/pt/train.jsonl - 验证集:
data/pt/val.jsonl - 测试集:
data/pt/test.jsonl
- 训练集:
- 罗马尼亚语 (ro)
- 训练集:
data/ro/train.jsonl - 验证集:
data/ro/val.jsonl - 测试集:
data/ro/test.jsonl
- 训练集:
- 俄语 (ru)
- 训练集:
data/ru/train.jsonl - 验证集:
data/ru/val.jsonl - 测试集:
data/ru/test.jsonl
- 训练集:
- 斯洛伐克语 (sk)
- 训练集:
data/sk/train.jsonl - 验证集:
data/sk/val.jsonl - 测试集:
data/sk/test.jsonl
- 训练集:
- 塞尔维亚语 (sr)
- 训练集:
data/sr/train.jsonl - 验证集:
data/sr/val.jsonl - 测试集:
data/sr/test.jsonl
- 训练集:
- 瑞典语 (sv)
- 训练集:
data/sv/train.jsonl - 验证集:
data/sv/val.jsonl - 测试集:
data/sv/test.jsonl
- 训练集:
- 泰米尔语 (ta)
- 训练集:
data/ta/train.jsonl - 验证集:
data/ta/val.jsonl - 测试集:
data/ta/test.jsonl
- 训练集:
- 泰卢固语 (te)
- 训练集:
data/te/train.jsonl - 验证集:
data/te/val.jsonl - 测试集:
data/te/test.jsonl
- 训练集:
- 乌克兰语 (uk)
- 训练集:
data/uk/train.jsonl - 验证集:
data/uk/val.jsonl - 测试集:
data/uk/test.jsonl
- 训练集:
- 越南语 (vi)
- 训练集:
data/vi/train.jsonl - 验证集:
data/vi/val.jsonl - 测试集:
data/vi/test.jsonl
- 训练集:
- 中文 (zh)
- 训练集:
data/zh/train.jsonl - 验证集:
data/zh/val.jsonl - 测试集:
data/zh/test.jsonl
- 训练集:
许可
该数据集的许可为 cc-by-nc-4.0。
任务类别
- 问答
任务ID
- 多项选择问答
数据集大小
- 10K<n<100K
语言
- 阿拉伯语 (ar)
- 孟加拉语 (bn)
- 加泰罗尼亚语 (ca)
- 丹麦语 (da)
- 德语 (de)
- 英语 (en)
- 西班牙语 (es)
- 巴斯克语 (eu)
- 法语 (fr)
- 古吉拉特语 (gu)
- 印地语 (hi)
- 克罗地亚语 (hr)
- 匈牙利语 (hu)
- 亚美尼亚语 (hy)
- 印度尼西亚语 (id)
- 冰岛语 (is)
- 意大利语 (it)
- 卡纳达语 (kn)
- 马拉雅拉姆语 (ml)
- 马拉地语 (mr)
- 挪威语 (nb)
- 尼泊尔语 (ne)
- 荷兰语 (nl)
- 葡萄牙语 (pt)
- 罗马尼亚语 (ro)
- 俄语 (ru)
- 斯洛伐克语 (sk)
- 塞尔维亚语 (sr)
- 瑞典语 (sv)
- 泰米尔语 (ta)
- 泰卢固语 (te)
- 乌克兰语 (uk)
- 越南语 (vi)
- 中文 (zh)
搜集汇总
数据集介绍
构建方式
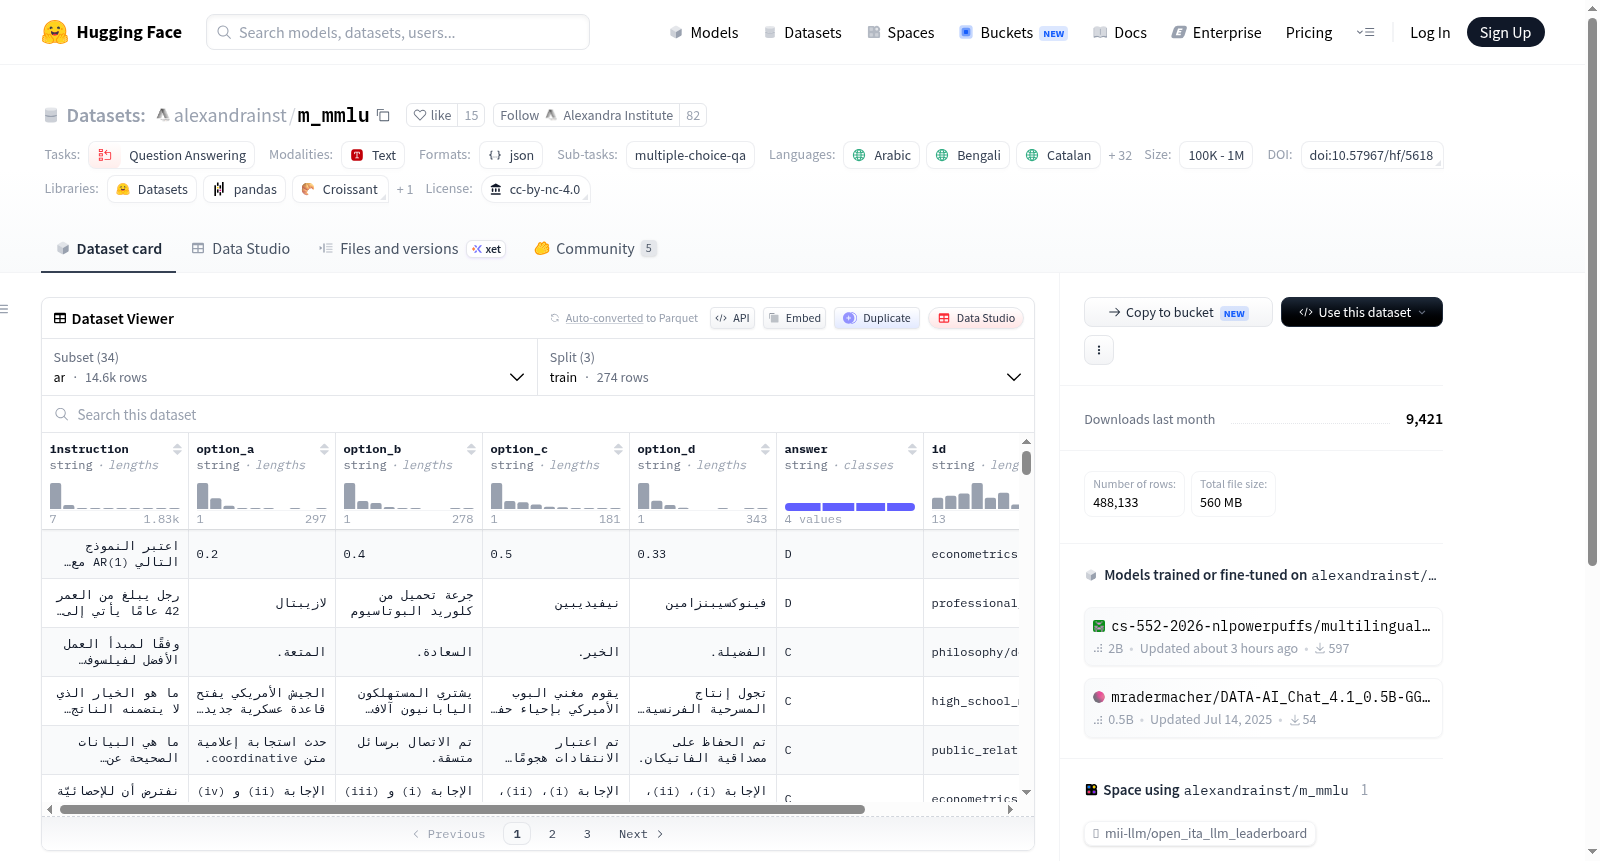
在自然语言处理与多语言理解研究领域,多语言基准数据集对于评估模型的跨语言泛化能力至关重要。alexandrainst/m_mmlu数据集是基于英文MMLU基准的机器翻译版本,涵盖了阿拉伯语、孟加拉语、加泰罗尼亚语等34种语言。其中,冰岛语部分采用Miðeind公司的Greynir模型完成翻译,挪威语部分借助DeepL引擎,其余语言则由俄勒冈大学使用GPT-3.5-turbo模型进行自动化翻译,原始翻译结果存放于该团队的GitHub仓库中。数据集按语言划分为独立配置,每个配置包含训练、验证和测试三部分,数据以JSONL格式存储。
特点
该数据集最为显著的特点在于其广泛的多语言覆盖能力,囊括了从印欧语系到达罗毗荼语系、从闪含语系到汉藏语系的多样语言,为跨语言问答任务提供了丰富的评测素材。数据规模介于10K至100K之间,聚焦于多项选择问答任务,严格遵循CC-BY-NC-4.0许可协议。通过统一的机器翻译流程,数据集在保留原始MMLU知识体系与题目结构的基础上,实现了内容的本土化迁移,使得研究者能够在同一任务框架下公平比较模型在不同语言上的表现。
使用方法
在使用该数据集时,研究者可通过HuggingFace Datasets库按需加载特定语言的配置,例如加载阿拉伯语子集时只需指定配置名称为'ar'。数据集已预先划分好train、val和test三个标准切分,便于直接用于模型训练、超参数调优与最终评估。每条数据采用JSONL格式,包含问题、选项及正确答案等字段,适配常见的多项选择问答评估流程。鉴于数据来源为机器翻译,建议用户在实际应用前对特定语言的质量进行抽样检验,以确保评测结果的可靠性。
背景与挑战
背景概述
大规模多任务语言理解(MMLU)数据集是评估大型语言模型知识广度与推理能力的经典基准,然而其以英语为核心的设计限制了非英语语境下的适用性。为弥补这一鸿沟,Alexandra Institute联合俄勒冈大学与Miðeind等机构于2023年推出了多语言MMLU(mMMLU)数据集,通过机器翻译将原MMLU覆盖至阿拉伯语、孟加拉语、中文等33种语言。该数据集的核心研究问题在于检验语言模型在多语言环境下的泛化能力,并推动跨语言自然语言处理的发展。其影响力体现在为低资源语言提供了标准化评估工具,促进了全球范围内语言模型的公平性研究,同时揭示了机器翻译质量对下游任务的潜在影响。
当前挑战
mMMLU面临的首要挑战是语言覆盖的均衡性:尽管包含33种语言,但各语言间的翻译质量参差不齐,冰岛语与挪威语采用专业翻译模型,而多数语言依赖GPT-3.5-turbo,可能导致文化特定知识或语境歧义的丢失。构建过程中,机器翻译的误差累积效应尤为突出,例如成语、专业术语或隐含语义的误译会扭曲原本的问答逻辑,进而影响评估结果的可靠性。此外,数据集规模有限(10K至100K样本),难以充分捕捉低资源语言的多样性,且缺乏人工验证环节,使得模型表现差异难以完全归因于语言能力本身,而非翻译噪声的干扰。
常用场景
经典使用场景
在自然语言处理与多语言理解的前沿探索中,Multilingual MMLU数据集作为一项开创性资源,将经典的MMLU基准测试拓展至涵盖阿拉伯语、中文、法语等33种语言。其核心应用场景在于评估和比较大规模语言模型在多语言环境下的知识推理与问答能力。研究者通过该数据集,能够在统一框架下检验模型从医学、法律到工程等57个学科领域的跨语言泛化表现,从而揭示当前模型在不同语言文化背景下的知识掌握程度与认知偏差。
实际应用
在实际应用层面,mMMLU数据集直接服务于全球化AI产品的落地部署与质量保障。它被广泛用于多语言问答系统的开发与迭代,例如国际医疗咨询平台、跨国法律文档检索工具以及多语种教育辅导系统。通过模拟用户使用不同母语提出的复杂知识性问题,开发者能够精准识别模型在特定语言上的薄弱环节,进而优化训练数据的语言分布或引入针对性微调策略,确保AI服务在全球用户群体中的公平性与可靠性。
衍生相关工作
mMMLU的发布催生了一系列富有影响力的衍生研究工作。其中,基于该数据集的多语言模型基准排行榜成为衡量模型泛化能力的重要参考,推动了如XGLM、mT5等模型的跨语言评估。研究者利用mMMLU探索了翻译质量对评测结果的影响,提出了检测机器翻译伪影的鲁棒性分析方法。此外,该数据集还启发了若干针对低资源语言的性能增强工作,包括基于提示学习的跨语言知识蒸馏与多任务联合训练策略,显著提升了小语种场景下的问答准确率。
以上内容由遇见数据集搜集并总结生成


