
遇见数据集

MA-tokenweights/all-the-news-2-tfidf-invfreq-topic-stratified-v1-val-sequences

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

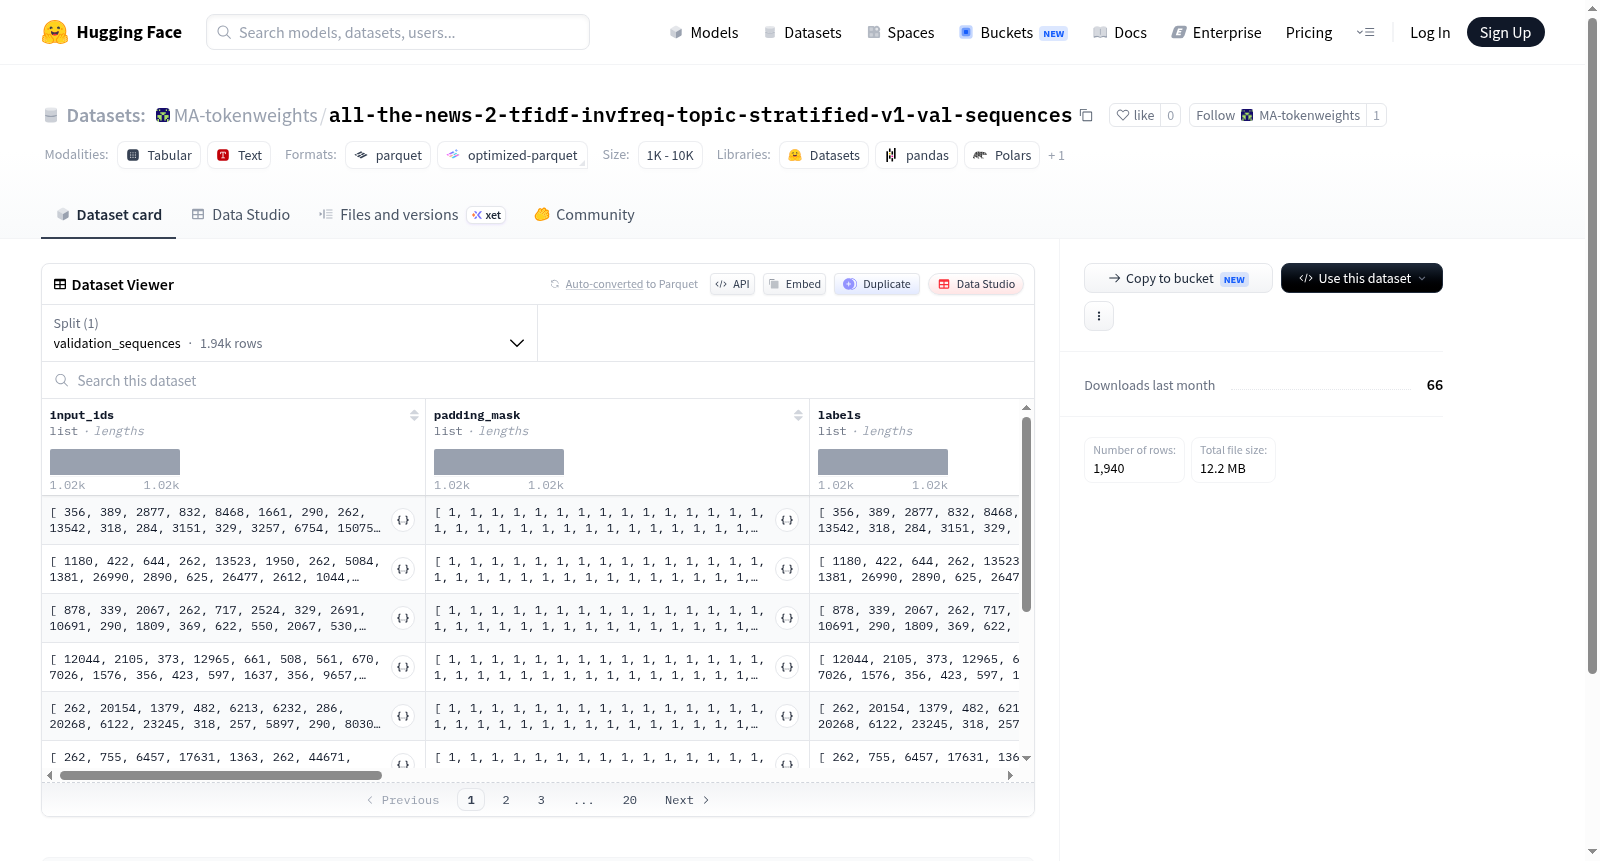
该数据集是一个用于自然语言处理任务的结构化数据集,包含文本序列的标记化表示和相关标注信息。特征包括输入ID序列(input_ids)、填充掩码(padding_mask)、标签序列(labels)、真实标记(real_tokens)、文章ID(article_id)、文章唯一标识符(article_uid)、数据源分割(source_split)、主题ID(topic_id)、主题强度(topic_strength)、序列索引(sequence_index)、标记起始位置(token_start)、标记结束位置(token_end)以及标记权重(token_weights)。数据集仅包含验证分割(validation_sequences),共1940个示例,文件大小约55.8 MB,适用于模型验证或评估任务,可能用于文本分类、序列标注或主题分析等场景。

This is a structured dataset designed for natural language processing (NLP) tasks, encompassing tokenized representations of text sequences and associated annotation information. Its features include input ID sequences (input_ids), padding masks (padding_mask), label sequences (labels), real tokens (real_tokens), article IDs (article_id), unique article identifiers (article_uid), data source splits (source_split), topic IDs (topic_id), topic strengths (topic_strength), sequence indices (sequence_index), token start positions (token_start), token end positions (token_end), and token weights (token_weights). This dataset only contains the validation split (validation_sequences), with a total of 1940 examples, and has a file size of approximately 55.8 MB. It is suitable for model validation or evaluation tasks, and can be applied to scenarios such as text classification, sequence labeling, or topic analysis.
提供机构:
MA-tokenweights
搜集汇总
数据集介绍
MA-tokenweights/all-the-news-2-tfidf-invfreq-topic-stratified-v1-val-sequences 数据集图片
构建方式
该数据集源自名噪一时的“所有新闻2.0”(All the News 2.0)语料库,通过引入TF-IDF逆文档频率权重与主题分层技术构建而成。具体而言,首先对原始新闻语料进行主题建模,依据主题强度对文档进行分层划分;随后在每个分层内部,利用TF-IDF算法计算词汇权重,并据此抽取代表序列。最终,这些序列被整合为验证集split,并精心标注了每个序列的输入ID、填充掩码、标签、真实令牌、文章标识符、来源分类、主题归属与强度等信息,形成了结构严谨的验证序列集合。
使用方法
该数据集专为验证环节设计,适用于各类以序列为输入的自然语言处理模型。使用方法上,可通过HuggingFace的datasets库直接加载validation_sequences split,并将input_ids作为模型输入、labels作为监督信号进行训练或评估。得益于事先嵌入的TF-IDF权重与主题分层属性,研究者可在微调语言模型时,利用token_weights实现注意力加权,或依据topic_id对验证结果进行分组分析。此外,article_id与token_start/end字段支持将预测结果映射回原始文档空间,便于进行多维度错误诊断与可视化解读。
背景与挑战
背景概述
该数据集由研究人员在自然语言处理领域构建,基于“All the News”2.0版本语料库,经过TF-IDF逆文档频率分析与主题分层处理,最终形成了验证集序列数据。其创建旨在支持大规模新闻文本的语义理解与主题建模研究,例如通过序列化的输入表示(如input_ids和padding_mask)训练语言模型或进行文本分类任务。数据集由多个机构合作开发,聚焦于多主题新闻文档的序列化标注与权重分配,为后续研究提供了结构化的验证基准,推动了新闻文本分析中主题一致性评估与序列建模方法的发展。
当前挑战
该数据集所面临的挑战主要源于领域问题的复杂性与构建过程的精细要求。在领域层面,新闻文本的多主题交织与语义演化使得模型需要同时捕捉局部词汇模式与全局主题分布,而传统基于词频的方法难以平衡稀疏性与代表性。在构建过程中,如何从海量新闻中提取准确的TF-IDF特征并进行无监督主题分层,同时避免过拟合于特定领域的新闻来源,是一大难点。此外,序列化过程中需确保输入片段(sequence_index)与原始文章的对应关系(article_uid)无误,且对各主题的权重分配(topic_strength)保持客观性,这对数据预处理与标注一致性提出了严格考验。
常用场景
经典使用场景
该数据集名为'all-the-news-2-tfidf-invfreq-topic-stratified-v1-val-sequences',源自庞大的新闻语料库,通过TF-IDF与逆频率加权技术对新闻文本进行主题分层处理,并进一步切分为序列化表示。其经典使用场景聚焦于新闻文本的语义理解与主题建模,研究者可借助其中预处理的token序列、主题强度及权重信息,高效训练或评估面向新闻领域的语言模型,尤其适用于长文本编码器与主题感知的序列分类任务。
解决学术问题
该数据集着力解决新闻文本中主题分布不均匀与序列长度变异性带来的建模难题。通过主题分层与逆频率加权,它有效缓解了类别不平衡问题,为学术研究提供了标准化的验证集,使得研究人员能够在公平基准上对比不同模型在新闻主题分类、序列标注及语义相似度计算上的表现。其意义在于推动新闻内容挖掘领域的可复现性,并促进面向复杂长文场景的注意力机制与上下文编码方法的创新。
实际应用
在实际应用层面,该数据集可支撑新闻聚合平台的自动化标签生成、个性化新闻推荐系统的话题偏好预测,以及舆情监控中关键议题的实时识别。其序列化结构与主题强度指标赋予模型捕捉局部语义与全局主题关联的能力,从而在文档摘要生成、多标签分类等工业场景中提升准确率与鲁棒性,为媒体机构的数据分析工具提供高质量训练素材。
数据集最近研究
最新研究方向
该数据集聚焦于新闻语料的主题建模与序列化表示,最新研究趋势将其应用于跨领域新闻事件脉络的语义追踪与主题强度演化分析。通过TF-IDF加权与逆文档频率融合,结合分层主题划分策略,研究者正探索如何利用该验证集序列验证大语言模型在新闻摘要生成、虚假信息检测及舆论趋势预判中的泛化能力,其结构化标签体系为可解释性AI提供了关键基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

