
遇见数据集

DarkArtsForge/Bible-responses-dataset-gotquestions

收藏
Hugging Face2026-06-13 更新2026-06-14 收录
官方服务:

资源简介:

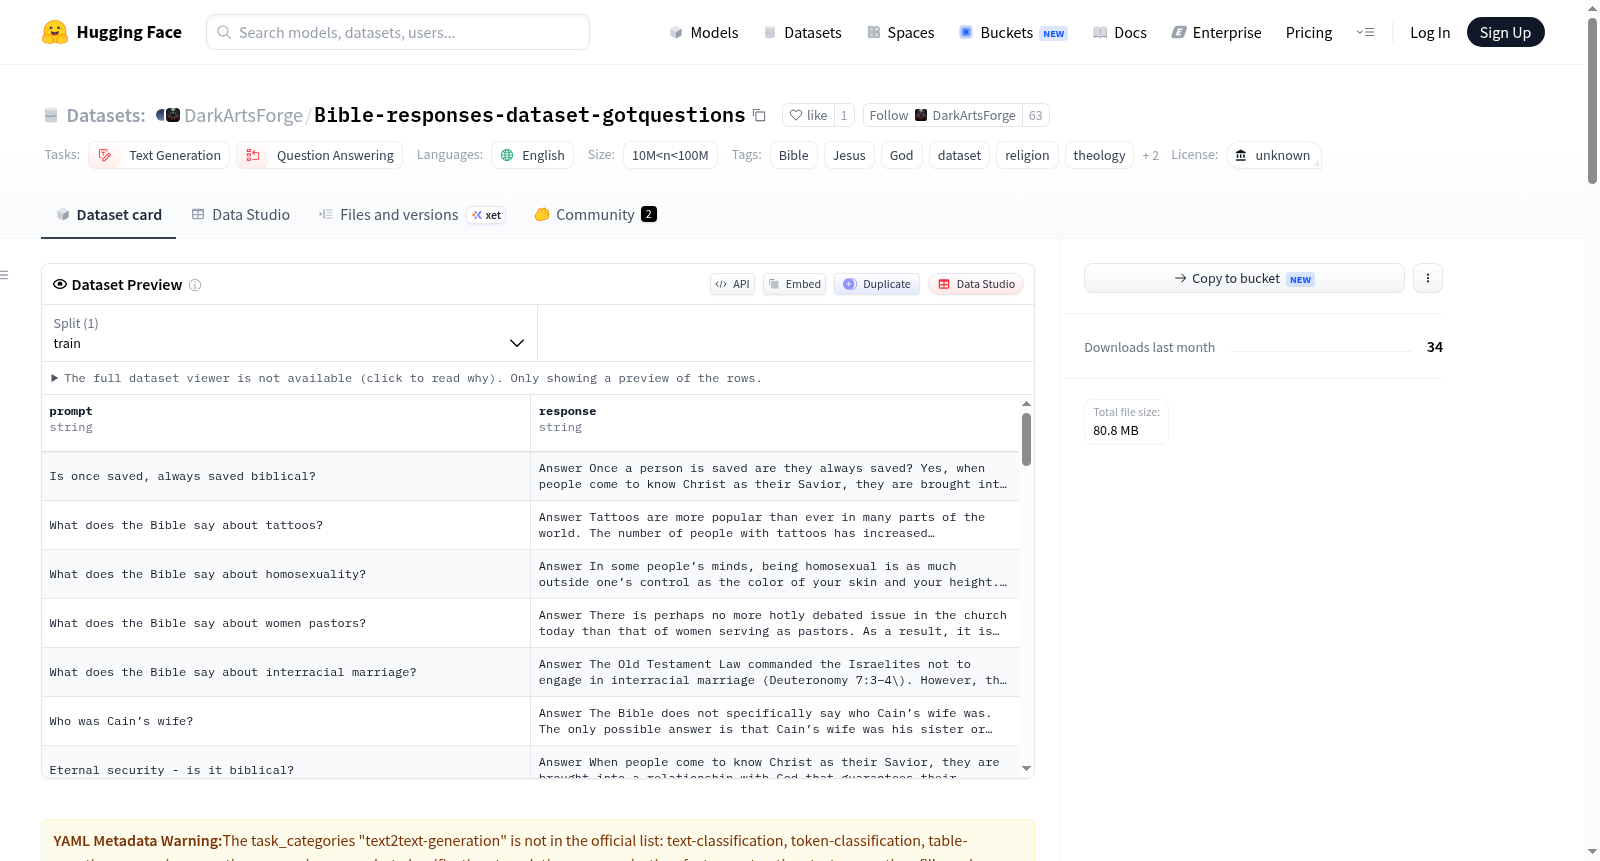
该数据集包含结构化、人工生成的神学内容,主要来源于网站GotQuestions。每个条目以问题(prompt)和相应答案(response)的格式呈现。数据集以JSON格式提供,旨在用于微调AI模型,但也可用于其他目的。数据集的结构包括一个问题和一个以Answer开头的答案,并提供了Python脚本来清理响应。创建过程耗时约七小时,旨在保持准确性并提供基于圣经的高质量神学信息。数据集基于公开可用的神学内容,适用于教育、研究、机器学习任务或与神学、问答系统、宗教研究相关的应用。

This dataset contains structured, human-generated theological content primarily sourced from the website GotQuestions. Each entry is presented in the format of a question (prompt) and its corresponding answer (response). The dataset is provided in JSON format, intended for fine-tuning AI models but also applicable for other use cases. The dataset structure includes a question and an answer starting with the keyword "Answer", and a Python script is provided for cleaning responses. The creation process took approximately seven hours, with the goal of maintaining accuracy and delivering high-quality, Bible-based theological information. The dataset is built upon publicly available theological content, and is suitable for education, research, machine learning tasks, or applications related to theology, question answering systems, and religious studies.
提供机构:
DarkArtsForge
搜集汇总
数据集介绍
DarkArtsForge/Bible-responses-dataset-gotquestions 数据集图片
构建方式
该数据集以神学问答为核心,系统性地从GotQuestions网站采集高质量、基于圣经的问答内容。构建过程耗时约七小时,确保每一条目的准确性与神学严谨性。数据以JSON格式组织,每一条目包含一个“prompt”字段(用户提问)和一个“response”字段(相应的神学解答),其中多数回答以“Answer”开头,体现结构化与规范性。数据集面向AI模型微调而设计,同时保留广泛适用性。
使用方法
用户可直接加载JSON文件进行AI模型微调,针对神学领域的文本生成或问答任务。若需去除回答中的“Answer”前缀,可运行提供的Python清洗函数。数据集适用于教育和研究目的,使用时需标注原始内容来源GotQuestions。建议与ConvoLite平台中的Milo-professional模型结合,快速搭建基于圣经的AI应用,实现从数据到部署的无缝衔接。
背景与挑战
背景概述
在人工智能与自然语言处理交叉领域,基于特定知识体系的问答系统构建一直是研究热点,尤其在宗教与神学文本处理中,如何生成符合教义且逻辑严谨的回应成为关键挑战。该数据集由独立研究者于近年来创建,主要挖掘自基督教神学资源网站GotQuestions,整合了数万条结构化的神学问答对,每条数据包含用户提出的具体问题与基于圣经的详尽解答。其核心研究问题聚焦于如何为语言模型注入精确的神学知识,使其在面临诸如“救赎”、“称义”等核心概念时,能产出既符合圣经原文又具备人文深度的回答。该数据集的出现为神学领域的微调模型提供了宝贵的训练范本,推动了机器学习在宗教研究、智能辅导与对话系统中的应用拓展。
当前挑战
该数据集所面对的挑战多重且复杂。在领域问题层面,神学文本具有高度抽象性与诠释多样性,传统问答系统难以处理涉及“原罪”、“恩典”等微妙教义的区别,模型极易陷入简化或异端解释的困境。构建过程中则面临更具体的难题:数据来源为公开网站,版权归属与许可协议不明确,使用者需主动溯源并尊重原创者权益;内容采集耗时约七小时,但未涉及多轮验证,部分答案以“Answer”开头需额外清洗;同时,样本规模虽达千万量级,但主题分布可能偏向特定教派,影响模型的泛化能力与中立性。
常用场景
经典使用场景
该数据集以《圣经》神学为根基,围绕基督教信仰中的核心教义、经文解释与生活实践,构建了结构化的问答对。每个样本包含一个神学问题与其对应的详尽解答,内容涵盖救恩、称义、成圣等关键主题。其经典使用场景在于作为指令微调数据,用于训练大语言模型在神学领域的回答能力,使其能够基于圣经文本生成准确、合乎正统教义的回馈,尤其适用于构建具备宗教知识储备的问答系统。
解决学术问题
在计算语言学与数字人文学科的交汇处,神学文本的自动化理解与生成长期缺乏高质量、人工验证的训练资源。该数据集填补了这一空白,为研究者提供了系统化的神学问答语料,解决了大语言模型在宗教领域事实性回答中的教义偏差与知识缺失问题。其意义在于推动了基于信仰文本的自然语言处理研究,使得模型能够更准确地解析圣经术语、理解神学逻辑,从而服务于宗教教育、跨文化对话及数字化宗教传播的学术探索。
实际应用
在实际应用中,该数据集可用于开发面向信徒与公众的智能问答助手,例如植入教会网站或App的在线教义咨询工具,帮助用户理解具体的圣经章节或教义概念。此外,它也能支撑神学院校的数字化教学资源平台,生成针对课程内容的问答练习。在更广泛的场景中,经过微调的模型可作为文化传承的辅助手段,为纪录片、宗教读物或跨文化交流项目提供符合神学规范的文本生成服务。
数据集最近研究
最新研究方向
结合神学领域数字化转型的前沿趋势,该数据集聚焦于构建高质量、基于圣经的神学问答语料库,旨在推动宗教文本与大语言模型的深度融合。当前研究热点在于利用人工精校的问答对(如GotQuestions网站内容),微调出能准确理解并回应当代信徒关于救赎、成圣等教义问题的AI模型。这一方向不仅服务于牧养场景中的智能问答系统开发,更映射出人工智能与宗教学交叉领域的新探索——即如何通过结构化神学知识(如“因信称义”的数十种圣经表述)缓解模型在宗教议题上的价值对齐问题,从而为数字化时代的宗教传播与信仰咨询提供可靠的技术支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

