
遇见数据集

J-Mourad/MNAD.v1

收藏
Hugging Face2023-05-16 更新2024-03-04 收录
官方服务:

资源简介:

MNAD数据集是一个包含超过100万篇摩洛哥新闻文章的语料库,这些文章以现代阿拉伯语书写,来源于11个主要的电子新闻源。数据集分为两个版本:MNAD.v1和MNAD.v2。MNAD.v1包含418,563篇文章,分为19个类别,来源于Akhbarona.ma、Hespress.ma、Hibapress.com和Le360.com四个新闻网站。MNAD.v2增加了653,901篇文章,总计1,069,489篇文章,来源于七个额外的摩洛哥新闻网站。MNAD.v2在数据预处理和清洗方面进行了改进,包括去除重复项、消除多余空格、删除NaN值、替换换行符、排除过长和过短的文章以及删除非阿拉伯语文章,以提高数据集的可用性和价值。

The MNAD dataset is a corpus comprising over one million Moroccan news articles written in Modern Standard Arabic, sourced from 11 major electronic news outlets. It is divided into two versions: MNAD.v1 and MNAD.v2. MNAD.v1 contains 418,563 articles categorized into 19 classes, originating from four news websites: Akhbarona.ma, Hespress.ma, Hibapress.com, and Le360.com. MNAD.v2 adds 653,901 articles, bringing the total count to 1,069,489 articles, sourced from seven additional Moroccan news websites. MNAD.v2 features improved data preprocessing and cleaning procedures, including removing duplicates, eliminating redundant whitespace, deleting NaN values, replacing newline characters, excluding overly long or short articles, and removing non-Arabic articles, to enhance the usability and value of the dataset.

提供机构:
J-Mourad
原始信息汇总

关于MNAD数据集

数据集概述

  • MNAD数据集 包含超过 100万篇 现代阿拉伯语的摩洛哥新闻文章。
  • 这些文章来自11个主要电子新闻源。
  • 数据集用于学术研究,如数据挖掘、信息检索等非商业活动。

数据集字段

  • Title: 文章标题
  • Body: 文章正文
  • Category: 文章类别
  • Source: 文章来源的电子报纸

版本1 (MNAD.v1)

  • 包含 418,563 篇文章,分为19个类别。
  • 数据来自Akhbarona.ma, Hespress.ma, Hibapress.com, Le360.com。
  • 存储在四个CSV文件中,每个文件对应一个新闻网站。
  • 每个CSV文件包含Title, Body, Category三个字段。
  • 包含约 906,125 个独特的阿拉伯语词汇。

版本2 (MNAD.v2)

  • 新增 653,901 篇文章,总文章数达到 1,069,489。
  • 新增文章来自七个摩洛哥新闻网站。
  • 所有文章合并为一个CSV文件 MNADv2.csv,新增"Source"字段。
  • 包含数据预处理和清洗的改进,如去除重复、NaN值处理等。

数据集下载

引用信息

  • 引用文献: bibtex @inproceedings{MNAD2021, author = {Mourad Jbene and Smail Tigani and Rachid Saadane and Abdellah Chehri}, title = {A Moroccan News Articles Dataset (MNAD) For Arabic Text Categorization}, year = {2021}, publisher = {IEEE}, booktitle = {2021 International Conference on Decision Aid Sciences and Application (DASA)}, doi = {10.1109/dasa53625.2021.9682402}, url = {https://doi.org/10.1109/dasa53625.2021.9682402}, }
搜集汇总
数据集介绍
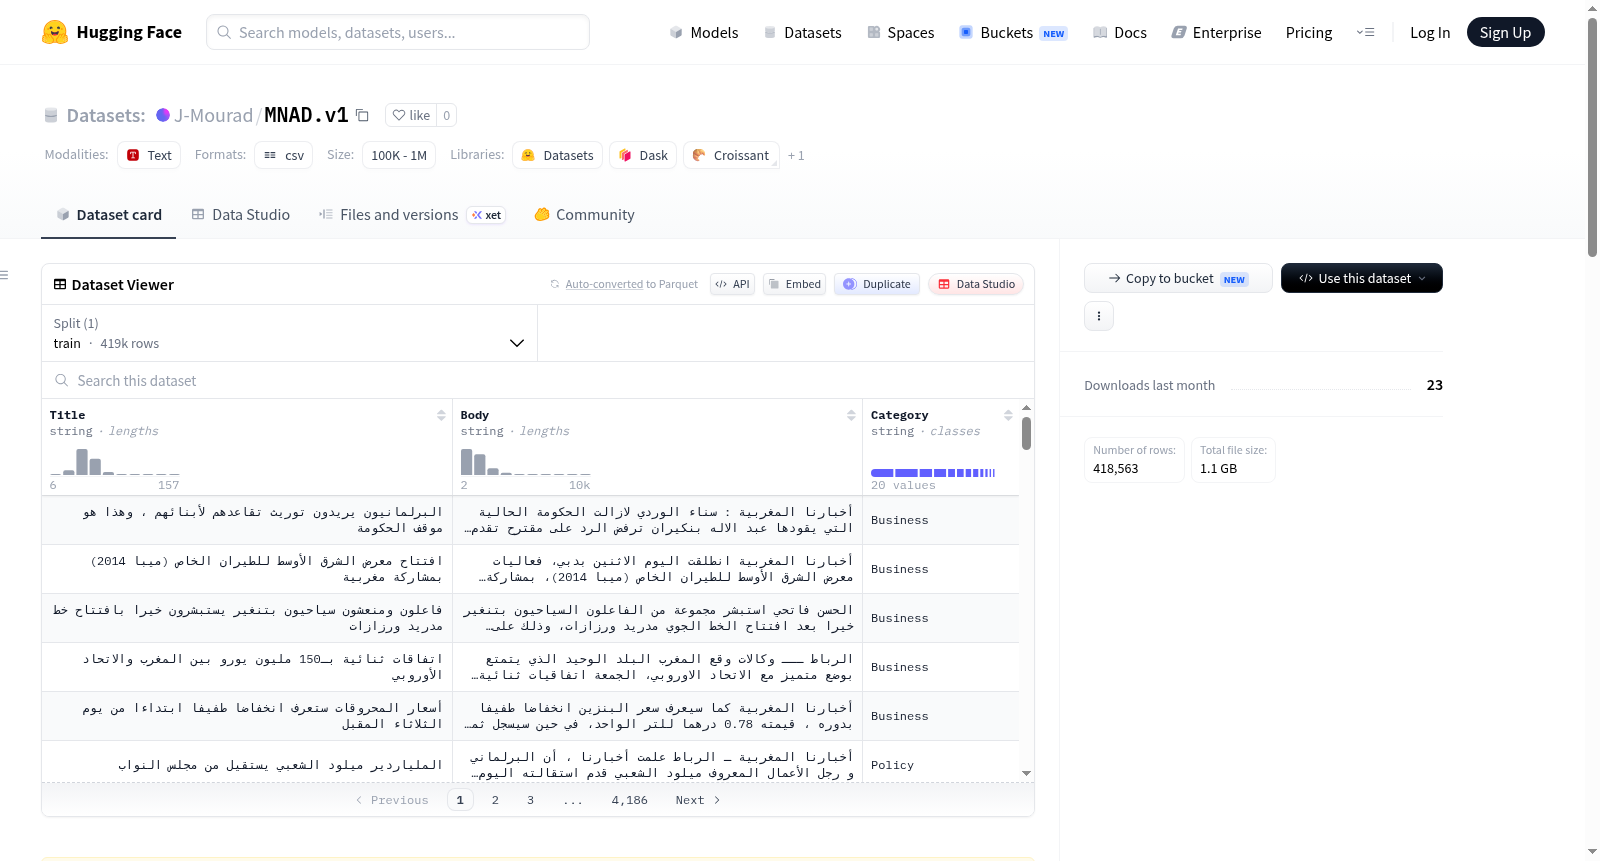
J-Mourad/MNAD.v1 数据集图片
构建方式
MNAD数据集(Moroccan News Articles Dataset)是面向摩洛哥现代阿拉伯语新闻语料的大规模资源,其构建经历了两个阶段的迭代演进。初始版本(MNAD.v1)汇集了来自Akhbarona.ma、Hespress.ma、Hibapress.com和Le360.com四大知名电子新闻源的418,563篇文章,按19个类别归类,并分存为四个独立的CSV文件,每条记录包含标题、正文和类别字段。随后发布的MNAD.v2版本在保留原有类别体系的基础上,从al3omk.com、medi1news.com等七个新增新闻网站额外采集653,901篇文章,使得总量突破一百万篇(共计1,069,489条)。v2版本将所有数据合并至单一CSV文件(MNADv2.csv),并新增“Source”字段以标注文章来源。此外,v2版实施了更为精细的预处理与清洗流程,包括去除重复项与NaN值、剔除过长或过短的非阿拉伯语文章、规范化空格与换行符等操作,显著提升了数据质量与可用性。
特点
该数据集的核心特色在于其规模宏大、来源多元且语料丰富,为阿拉伯语文本分析领域提供了坚实的基准资源。MNAD.v2整合了来自11个摩洛哥主流新闻网站的逾百万篇文章,覆盖19个新闻类别,词汇量高达约90.6万独特词项,充分反映了摩洛哥现代标准阿拉伯语的多样性与地域特征。数据集不仅包含完整的标题与正文内容,还通过类别与来源字段支持多维度检索与分析。其经过严格清洗与去重处理,有效规避了噪声干扰,确保了语料的纯净度与一致性。作为已被国际会议论文(2021 DASA)采用的基准数据集,MNAD在阿拉伯语文本分类、聚类、信息检索等研究任务中展现了卓越的适用性与权威性。
使用方法
研究者可通过Kaggle或HuggingFace平台直接获取MNAD.v1与MNAD.v2数据集,其中v2版本以单一CSV文件(MNADv2.csv)提供,便于加载与处理。使用时,建议利用Python的pandas库读取文件,并依据“Category”字段进行文本分类任务的数据划分,或基于“Source”字段分析不同新闻源的语言风格差异。由于数据已进行初步清洗,可直接用于训练词嵌入模型、构建文本分类器或执行聚类分析。在评估模型性能时,可参考原始论文中的实验设置,将数据集按比例划分为训练集与测试集。此外,研究者可结合阿拉伯语自然语言处理工具(如Farasa、MADAMIRA)进行分词、词性标注等预处理,以适配下游任务需求。引用该数据集时,请务必标注原始论文(Jbene et al., 2021),以尊重学术贡献。
背景与挑战
背景概述
在阿拉伯语自然语言处理领域,高质量标注语料库的匮乏长期制约着文本分类、信息检索等核心任务的进展。针对这一困境,由Mourad Jbene、Smail Tigani、Rachid Saadane及Abdellah Chehri等研究人员于2021年构建的MNAD数据集应运而生,其v1版本收录了来自摩洛哥四大电子新闻源的418,563篇现代阿拉伯语文章,涵盖19个类别,拥有约90.6万个独特词汇。该数据集在2021年国际决策辅助科学与应用会议上作为基准被提出,旨在为阿拉伯语文本分类研究提供标准化评测资源。随后发布的v2版本将规模扩充至逾百万篇,新增七个新闻源并引入更精细的清洗流程,显著提升了语料的多样性与可靠性,已成为阿拉伯语文本挖掘领域的重要基石。
当前挑战
MNAD数据集所面临的挑战首先源于其核心研究问题——阿拉伯语文本分类的固有复杂性,包括摩洛哥方言与现代标准阿拉伯语的混杂、阿拉伯语形态的丰富性对词干提取与特征表示的干扰,以及跨类别新闻在主题边界上的模糊性。在构建过程中,挑战同样显著:从十一个来源采集数据时需应对异构格式与编码不一致问题;v2版本虽优化了去重、空值处理及非阿拉伯语过滤,但海量数据中的噪声残留(如特殊符号、不完整句子)仍可能影响模型泛化能力;此外,19个类别间的样本分布不均衡,部分小众新闻类别数据稀疏,为分类器的鲁棒训练增添了难度。
常用场景
经典使用场景
MNAD.v1数据集汇聚了来自摩洛哥四大主流电子新闻媒体的逾41万篇现代阿拉伯语文章,覆盖19个新闻类别,为阿拉伯语文本分类研究提供了规模宏大且标注清晰的基准语料。研究者可基于标题与正文内容,利用深度学习和传统机器学习模型进行多类别分类任务,探索阿拉伯语特有的形态复杂性与词汇多样性对分类性能的影响,从而推动低资源语言自然语言处理技术的进步。
实际应用
在实际应用中,MNAD.v1可支撑阿拉伯语新闻门户的智能内容管理系统,实现文章自动归类与个性化推荐,提升用户阅读体验。同时,该数据集赋能舆情分析平台,实时追踪摩洛哥及马格里布地区社会热点话题的分布与演变,辅助媒体机构与政策制定者洞察公众情绪。其多源异构特性还可用于训练跨平台新闻聚合引擎,优化信息检索效率。
衍生相关工作
MNAD.v1的发布催生了多项经典工作,如基于卷积神经网络与双向长短期记忆网络的阿拉伯语文本分类模型,以及融合词嵌入与主题模型的混合分类框架。后续研究还利用该数据集对比了不同预训练语言模型(如AraBERT、mBERT)在摩洛哥新闻语料上的迁移学习效果,推动了针对北非阿拉伯语变体的专用语言模型开发,并衍生出针对新闻摘要生成与事件抽取的扩展数据集。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

