ErrorBench
收藏资源简介:
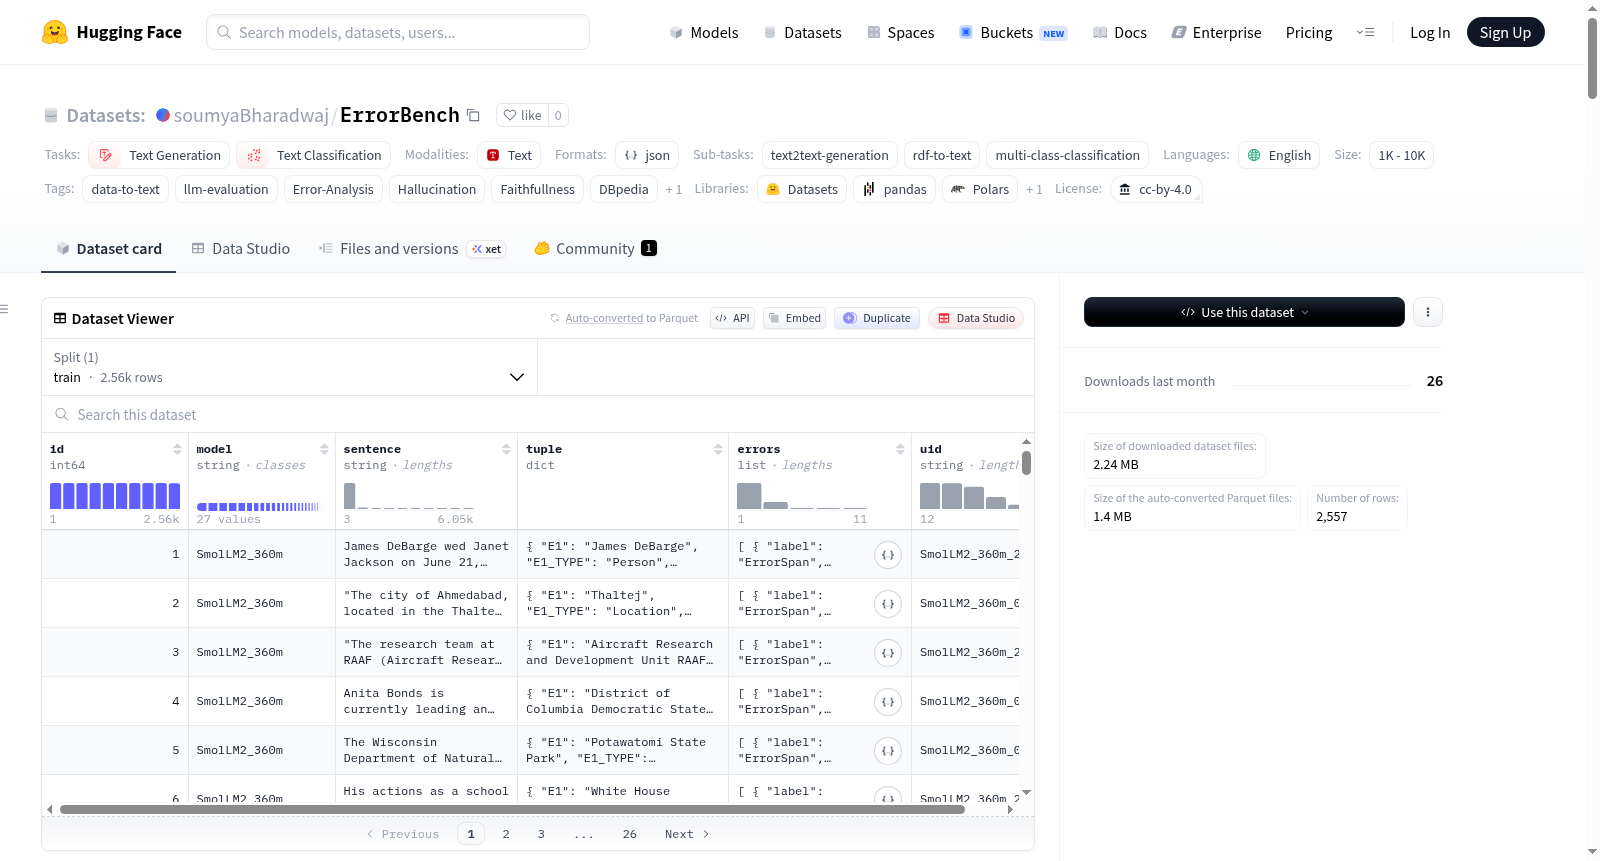
ErrorBench是一个人工标注的细粒度基准数据集,用于分析大型语言模型(LLMs)在数据到文本(D2T)生成中的错误。数据集包含从结构化DBpedia三元组生成的句子,并标注了10种错误类别的细粒度错误标签。该数据集旨在支持对生成失败(如幻觉、遗漏、提示泄漏、不连贯性及实体或关系错误)的详细分析,这些错误无法通过传统的表面级指标(如BLEU或ROUGE)捕捉。每个输入三元组与多个LLM的输出配对,支持跨模型比较错误分析、元评估以及开发LLM生成文本的自动错误检测系统。数据集包含224个三元组,6,048个生成句子,约2,557个错误标注句子,约4,732个标注错误跨度,涵盖9个LLM家族的27个模型变体。数据集结构包括全局唯一ID、模型名称、生成句子、输入三元组及错误标注信息。适用于数据到文本生成系统评估、LLM细粒度错误分析、幻觉检测、忠实性评估等任务。
ErrorBench is a manually annotated fine-grained benchmark dataset developed to analyze errors in data-to-text (D2T) generation by large language models (LLMs). It comprises sentences generated from structured DBpedia triples, with each instance labeled with fine-grained error tags belonging to 10 error categories. This dataset enables detailed analysis of generation failures—including hallucinations, omissions, prompt leakage, incoherence, and entity or relation errors—that cannot be captured by traditional surface-level evaluation metrics such as BLEU or ROUGE. Each input triple is paired with outputs from multiple LLMs, facilitating cross-model comparative error analysis, meta-evaluation, and the development of automated error detection systems for text generated by LLMs. The dataset includes 224 triples, 6,048 generated sentences, approximately 2,557 error-annotated sentences, and around 4,732 annotated error spans, covering 27 model variants across 9 LLM families. Its structure consists of globally unique IDs, model names, generated sentences, input triples, and error annotation information. It is suitable for tasks including data-to-text generation system evaluation, fine-grained LLM error analysis, hallucination detection, and faithfulness assessment.
ErrorBench 数据集概述
数据集简介
ErrorBench 是一个用于分析大型语言模型在数据到文本生成任务中生成错误的人工标注、跨度级基准数据集。该数据集包含从结构化 DBpedia 三元组生成的句子,并标注了跨越 10 个错误类别的细粒度跨度级错误标签。
关键信息
- 语言:英语
- 许可证:Creative Commons Attribution 4.0 (cc-by-4.0)
- 任务类别:文本生成、文本分类
- 具体任务:文本到文本生成、RDF到文本、多类分类
- 论文ID:errorbench
- 标签:数据到文本、LLM评估、错误分析、幻觉、忠实度、DBpedia、文本生成
数据集统计
- 总三元组数量:224
- 总生成句子数量:6,048
- 错误标注句子数量:≈2,557
- 总标注错误跨度数量:≈4,732
- 评估的LLM家族数量:9
- 总模型变体数量:27
- 标注类型:人工跨度级标注
任务描述
任务是基于结构化三元组进行数据到文本生成。三元组形式为:(实体1, 实体1类型, 关系, 实体2, 实体2类型)。模型生成描述实体间关系的句子,生成的句子随后被人工标注跨度级错误。
数据结构
每个实例包含以下字段:
| 字段 | 描述 |
|---|---|
| id | 实例的全局唯一数字ID |
| uid | 原始模型特定实例ID |
| model | 生成句子的模型名称 |
| sentence | 模型生成的句子 |
| tuple.E1 | 实体1 |
| tuple.E1_TYPE | 实体1类型 |
| tuple.RELATION | 关系 |
| tuple.E2 | 实体2 |
| tuple.E2_TYPE | 实体2类型 |
| errors.label | 错误跨度标签 |
| errors.spans | 字符跨度索引 |
| errors.text | 包含错误的文本跨度 |
| errors.error_type | 错误类别 |
注意:由于数据集合并了来自 27 个不同模型的输出,原始三元组ID在不同模型间重复。因此:
id= 全局唯一数据集IDuid= 原始模型特定实例标识符 (格式: ModelName_TupleID)
错误分类(10个类别)
| 错误类型 | 描述 |
|---|---|
| 实体遗漏 | 句子中缺少必需实体 |
| 关系遗漏 | 关系未表达 |
| 添加 | 三元组中不存在的额外信息 |
| 重复 | 重复的标记或短语 |
| 拼写/格式漂移 | 格式化或拼写问题 |
| 提示回显 | 提示或推理泄漏 |
| 关系模糊 | 关系表达不清晰 |
| 实体类型变更 | 实体类型表达错误 |
| 不连贯 | 句子无意义或矛盾 |
| 部分实体不匹配 | 实体部分不正确 |
评估指标
数据集支持使用两种指标进行评估:
- 总错误跨度率:每个句子的平均错误跨度数。
- 生成质量指数:完全无错误句子的百分比。
预期用途
ErrorBench 可用于:
- 评估数据到文本生成系统
- LLM的细粒度错误分析
- 幻觉检测
- 忠实度评估
- 训练自动错误检测模型
- 研究LLM生成中的缩放效应
- 提示工程研究
- 基准测试结构化文本生成系统
数据集创建流程
- 从 DBpedia 收集结构化三元组。
- 使用来自 9 个模型家族的 27 个 LLM 变体生成句子。
- 每个模型为每个三元组生成一个句子。
- 生成的句子被人工标注。
- 使用 10 类别分类法分配跨度级错误标签。
引用
如果使用此数据集,请引用:
@inproceedings{bharadwaj2026errorbench, title={ErrorBench: Fine-Grained Error Analysis of Multi-Family LLMs in Data-to-Text Generation}, author={Bharadwaj, Soumya and Anand, Ashish}, booktitle={International Joint Conference on Neural Networks (IJCNN)}, year={2026}, organisation={IEEE} }