Auto-ClawEval-mini
收藏资源简介:
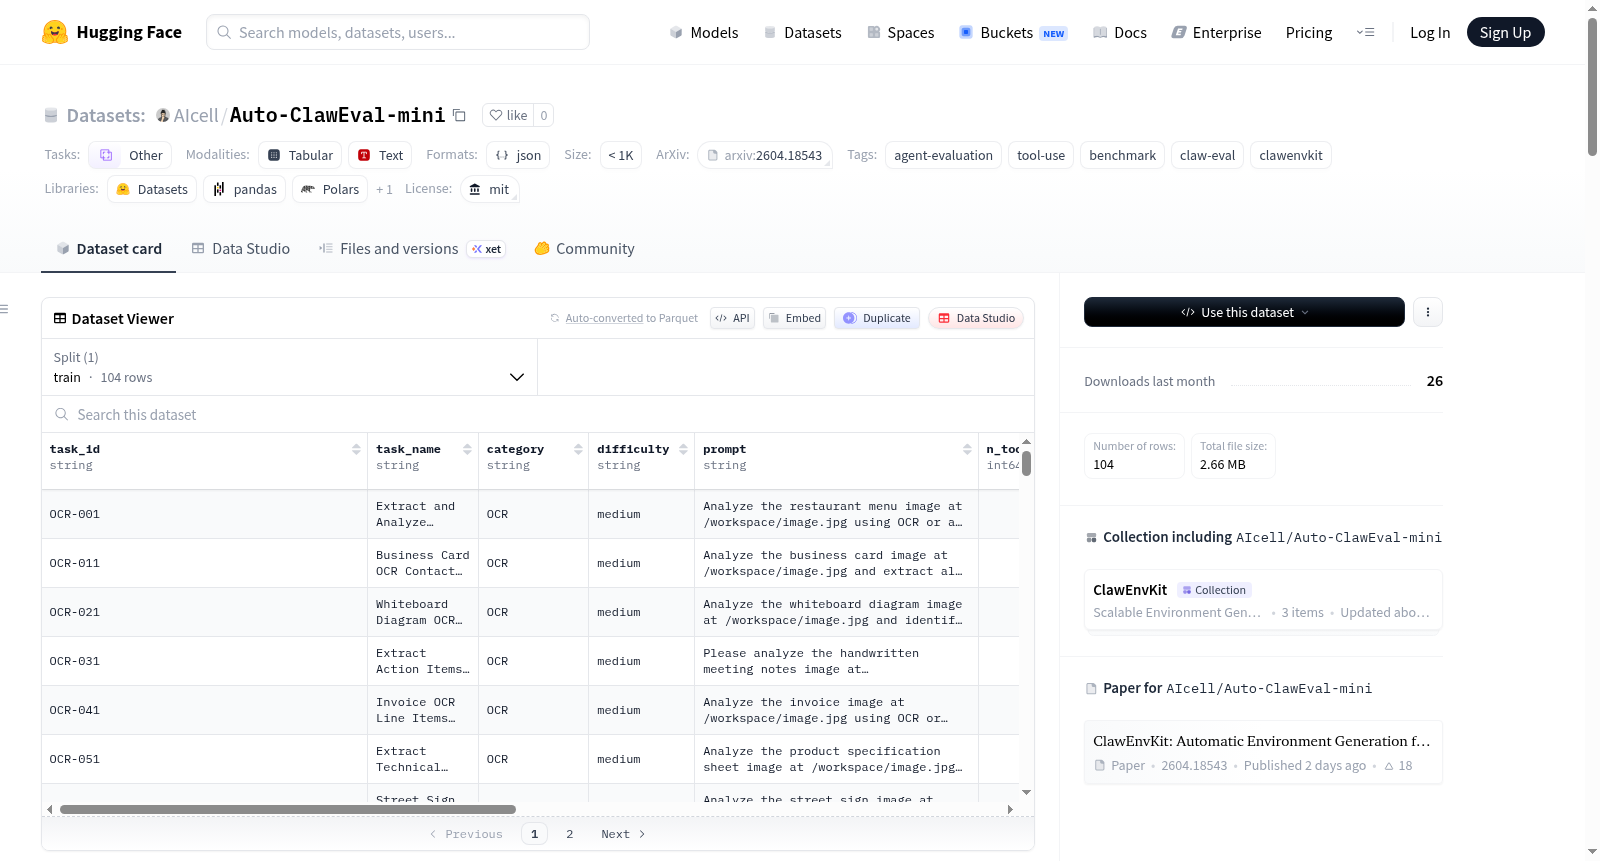
Auto-ClawEval-mini 是一个紧凑的智能体评估基准数据集,由 ClawEnvKit 创建,包含 104 个任务。数据集涵盖 24 个类别和 20 个模拟服务,任务类型包括 API 基础(77%)和文件依赖(23%)。每个任务通过 YAML 文件定义,包含任务 ID、名称、类别、难度、提示、工具、固定装置、文件、评分组件、安全检查以及参考解决方案等字段。数据集还提供了一个扁平索引文件 metadata.jsonl,便于快速访问任务信息。该数据集适用于智能体评估和工具使用等任务,支持通过 ClawEnvKit 的多种评估工具进行测试。数据集规模小于 1K,适用于小型到中型的研究项目。
Auto-ClawEval-mini is a compact benchmark dataset for agent evaluation, developed by ClawEnvKit, which contains 104 tasks. It covers 24 categories and 20 simulated services, with task types including 77% API-based and 23% file-dependent. Each task is defined via a YAML file, containing fields such as task ID, name, category, difficulty, prompt, tools, fixtures, files, scoring components, security checks, and reference solutions. The dataset also provides a flat index file metadata.jsonl for quick access to task information. This dataset is suitable for tasks like agent evaluation and tool usage, and supports testing through multiple evaluation tools provided by ClawEnvKit. With a scale of less than 1K, it is ideal for small to medium-sized research projects.
Auto-ClawEval-mini 数据集概述
基本信息
- 数据集名称:Auto-ClawEval-mini
- 许可证:MIT
- 任务类别:其他(other)
- 数据集大小:少于1,000条(n<1K)
- 数据集地址:https://huggingface.co/datasets/AIcell/Auto-ClawEval-mini
数据集规模与结构
- 任务数量:104个任务
- 任务类别数:24个类别
- 模拟服务数:20个
- 任务类型分布:基于API的任务占77%,基于文件的任务占23%
数据组成
数据集包含以下文件结构:
- tasks/ 目录:按类别组织,每个任务对应一个YAML文件,定义提示词、工具、评分和安全检查
- metadata.jsonl:扁平索引文件,每行对应一个任务
任务YAML结构
| 字段 | 类型 | 说明 |
|---|---|---|
task_id |
字符串 | 唯一标识符(如 todo-001) |
task_name |
字符串 | 简短可读名称 |
category |
字符串 | 所属类别(共24类) |
difficulty |
字符串 | 难度等级(easy/medium/hard) |
prompt |
字符串 | 面向智能体的自然语言任务描述 |
tools |
列表 | 可用工具(名称、端点、方法、服务、描述) |
fixtures |
字典 | 任务运行前加载到服务中的模拟数据 |
files |
列表 | 挂载到工作空间的固定文件(图片、文档、数据库) |
scoring_components |
列表 | 带权重的评分检查(15种确定性类型 + llm_judge) |
safety_checks |
列表 | 安全约束(如 tool_not_called、keywords_not_in_output) |
reference_solution |
字符串/列表 | 逐步预期的执行流程 |
使用方式
通过Hugging Face CLI下载
bash huggingface-cli download AIcell/Auto-ClawEval-mini --repo-type dataset --local-dir Auto-ClawEval-mini
通过datasets库加载
python from datasets import load_dataset ds = load_dataset("AIcell/Auto-ClawEval-mini", split="train") print(ds[0]["prompt"]) print(ds[0]["task_id"], ds[0]["category"], ds[0]["services"])
读取完整任务定义
python import yaml from huggingface_hub import hf_hub_download
path = hf_hub_download( repo_id="AIcell/Auto-ClawEval-mini", repo_type="dataset", filename="tasks/todo/todo-001.yaml", ) task = yaml.safe_load(open(path)) print(task["prompt"]) print(task["tools"]) print(task["scoring_components"])
评估支持
ClawEnvKit 工具包支持10种评估框架,分为3个集成层级:
| 层级 | 评估框架 |
|---|---|
| 插件(Plugin) | OpenClaw |
| MCP | Claude Code, NanoClaw, IronClaw, PicoClaw, ZeroClaw |
| SKILL.md + shell | CoPaw, NemoClaw, Hermes |
| 基线(Baseline) | Agent Loop(无Docker,函数调用) |
相关资源
- ClawEnvKit(https://github.com/xirui-li/ClawEnvKit)— 用于生成和评估智能体环境的工具包
- Auto-ClawEval(https://huggingface.co/datasets/AIcell/Auto-ClawEval)— 完整基准测试集,包含1,040个任务
- Claw-Eval(https://github.com/qwibitai/claw-eval)— 人工编写的基线基准测试集
引用
bibtex @misc{li2026clawenvkitautomaticenvironmentgeneration, title={ClawEnvKit: Automatic Environment Generation for Claw-Like Agents}, author={Xirui Li and Ming Li and Derry Xu and Wei-Lin Chiang and Ion Stoica and Cho-Jui Hsieh and Tianyi Zhou}, year={2026}, eprint={2604.18543}, archivePrefix={arXiv}, primaryClass={cs.AI}, url={https://arxiv.org/abs/2604.18543}, }