
遇见数据集

wgk-ja-trajectories

收藏
Hugging Face2026-06-03 更新2026-06-04 收录
官方服务:

资源简介:

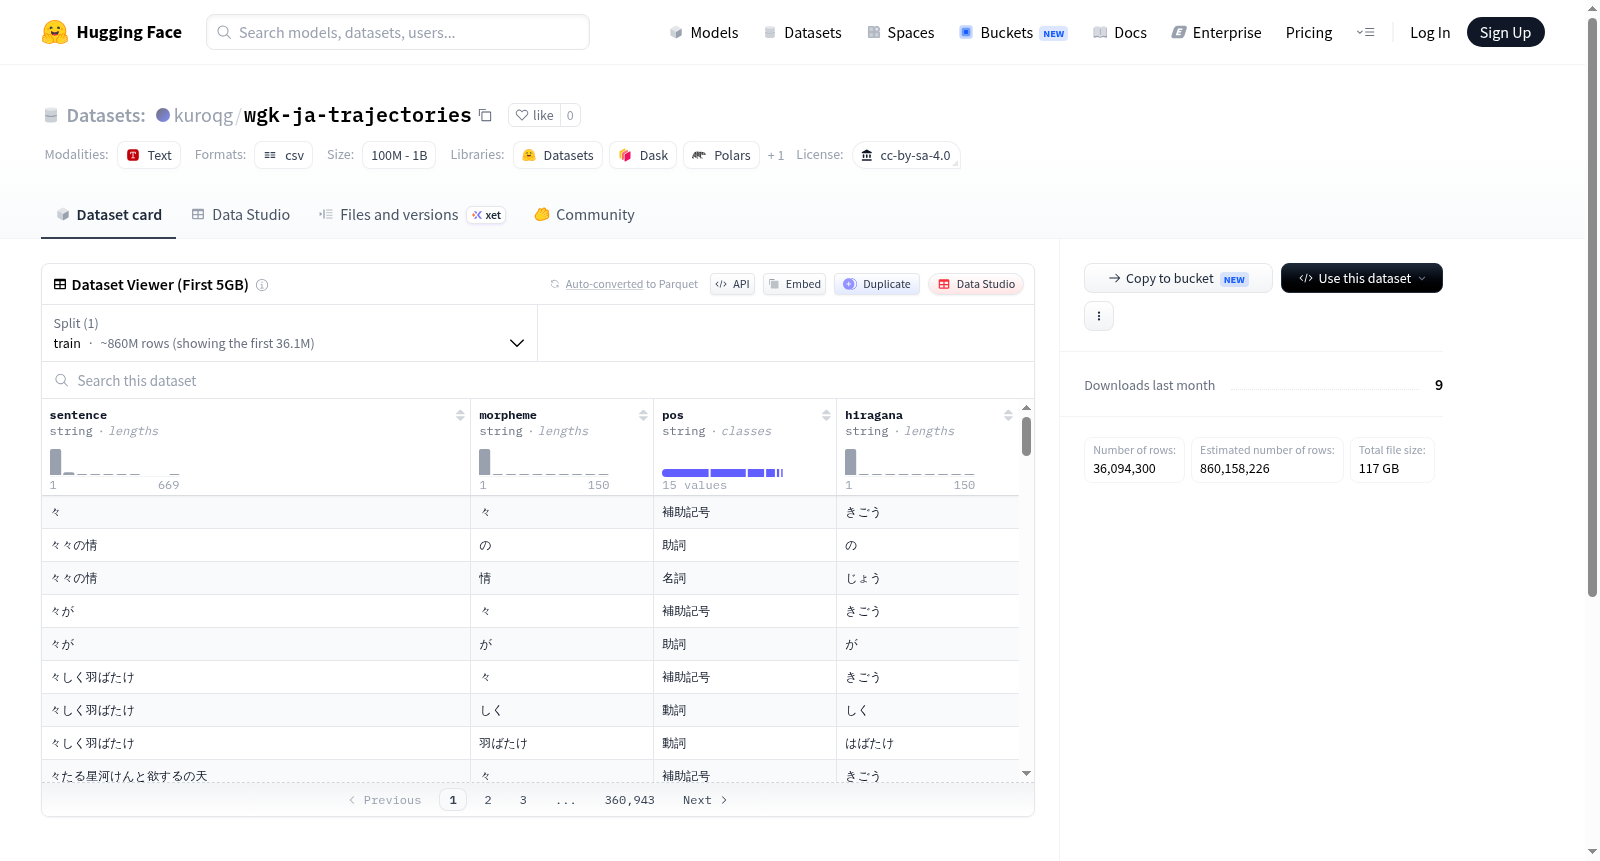
该数据集名为wgk-ja-trajectories,派生自日语维基百科,其原始内容遵循知识共享署名-相同方式共享4.0国际(CC BY-SA 4.0)许可协议。数据集包含经过处理的日语词汇数据以及为日语单词-手势键盘研究而生成的手势轨迹数据,专门用于支持日语单词-手势键盘(WGK)的相关研究与应用开发。

The dataset, named wgk-ja-trajectories, is derived from the Japanese Wikipedia. Its original content is licensed under the Creative Commons Attribution-ShareAlike 4.0 International (CC BY-SA 4.0) license. The dataset contains processed Japanese lexical data and gesture trajectory data generated for Japanese word-gesture keyboard research, and is specifically designed to support research and application development related to Japanese word-gesture keyboards (WGK).

创建时间:
2026-06-03
原始信息汇总

数据集概述

数据集名称:wgk-ja-trajectories

来源:源自日语维基百科(Japanese Wikipedia)

许可证:遵循 Creative Commons Attribution-ShareAlike 4.0 International (CC BY-SA 4.0) 许可

内容:该数据集包含经过处理的词汇数据以及为日语单词手势键盘(Word-Gesture Keyboard, WGK)研究所生成的手势轨迹。
搜集汇总
数据集介绍
wgk-ja-trajectories 数据集图片
构建方式
该数据集源自日本维基百科,基于CC BY-SA 4.0许可协议进行派生构建。研究者从日本维基百科中提取原始文本内容,经过专门的词汇数据处理流程,形成了结构化的词汇数据。在此基础上,通过算法生成与日语词汇对应的手势轨迹,旨在服务于日语手势键盘(WGK)的研究领域。数据集的构建过程兼顾了词汇的语义完整性与手势轨迹的物理合理性。
特点
该数据集融合了真实文本语料与合成手势轨迹两大要素,兼具语言学与交互设计的双重属性。词汇数据源自海量的日本维基百科内容,确保了语言覆盖的广度与频率分布的合理性;生成的手势轨迹则针对日语假名与汉字的输入特点进行优化,支持Word-Gesture Keyboard研究中对连续滑动输入的建模需求。数据集以CC BY-SA 4.0开放许可发布,便于学术研究与二次开发。
使用方法
本数据集适用于日语手势键盘系统的训练与评估。用户可加载词汇数据作为语言模型训练的基础语料,同时利用生成的手势轨迹开展输入预测、手势识别或用户行为模拟实验。建议在基于轨迹的序列建模任务中,将词汇与对应轨迹配对使用,以构建端到端的划词输入系统。数据处理时需注意遵循CC BY-SA 4.0许可要求,并引用原始日本维基百科来源。
背景与挑战
背景概述
该数据集源自日本维基百科,基于知识共享署名-相同方式共享4.0国际许可协议发布,专注于日语词汇手势键盘(WGK)研究领域。WGK是一种通过滑动手势输入词汇的交互技术,旨在提升移动设备上的文本输入效率。该数据集由相关研究团队于近年创建,核心研究问题在于如何利用大规模词汇数据生成精准的滑动手势轨迹,从而支持日语输入系统的优化与评估。其发布对自然语言处理与人机交互交叉领域具有重要推动作用,为手势识别算法、用户行为建模及多语言输入方法研究提供了基础数据资源。
当前挑战
当前数据集面临的主要挑战包括:1)领域问题层面,日语词汇手势键盘需处理复杂的平假名、片假名及汉字混合输入,传统手势轨迹模型难以覆盖多字节字符的动态路径,且用户滑动手势存在高度个体差异,需平衡通用性与个性化需求;2)构建过程中,从维基百科原始文本提取词汇并生成轨迹时,需解决分词歧义、低频词轨迹稀疏性以及噪声剔除问题,同时确保数据集在CC-BY-SA许可下的合规使用与跨场景适应性。
常用场景
经典使用场景
在日语言语交互与输入法优化的研究领域中,wgk-ja-trajectories数据集扮演着不可或缺的角色。该数据集聚焦于日语单词手势键盘(Word-Gesture Keyboard)的轨迹生成,通过将日语维基百科的词汇进行深度处理,构建了词汇与手势轨迹之间的映射关系。研究者常利用该数据集来训练和评估基于滑动输入的手势识别模型,尤其适用于连续手写轨迹的解码与预测。其经典应用场景包括:从原始的手势坐标序列中恢复用户意图输入的正确词汇,验证手势识别算法的鲁棒性,以及开发面向日语输入的高效手势解码系统。
解决学术问题
该数据集针对日语手势输入中因词汇量庞大、同音词繁多而导致的轨迹歧义问题,提供了标准化的基准数据。在学术研究中,它有效解决了手势轨迹与日文文本间的对齐难题,使得研究者能够量化评估不同模型在近邻词区分与轨迹预测上的性能。通过提供经过清洗的词汇分布与真实轨迹样本,该数据集推动了日语手势-文本转换的端到端研究,填补了非英语语种在手势键盘领域缺乏公开标注资源的空白,显著提升了日语输入系统的智能性与用户适应性。
衍生相关工作
该数据集衍生出了一系列围绕日语手势轨迹建模的经典工作,包括基于注意力机制的轨迹到文本解码模型、结合语言模型的动态手势解码算法,以及利用对比学习优化同音词轨迹区分的框架。部分研究在此基础上构建了多模态日语输入系统,融合加速度计与触摸轨迹数据以提升识别精度。此外,数据集中的词汇分布规律也被迁移至跨语种手势键盘的迁移学习研究中,为中文、韩文等书写系统的手势交互提供了方法论参考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


