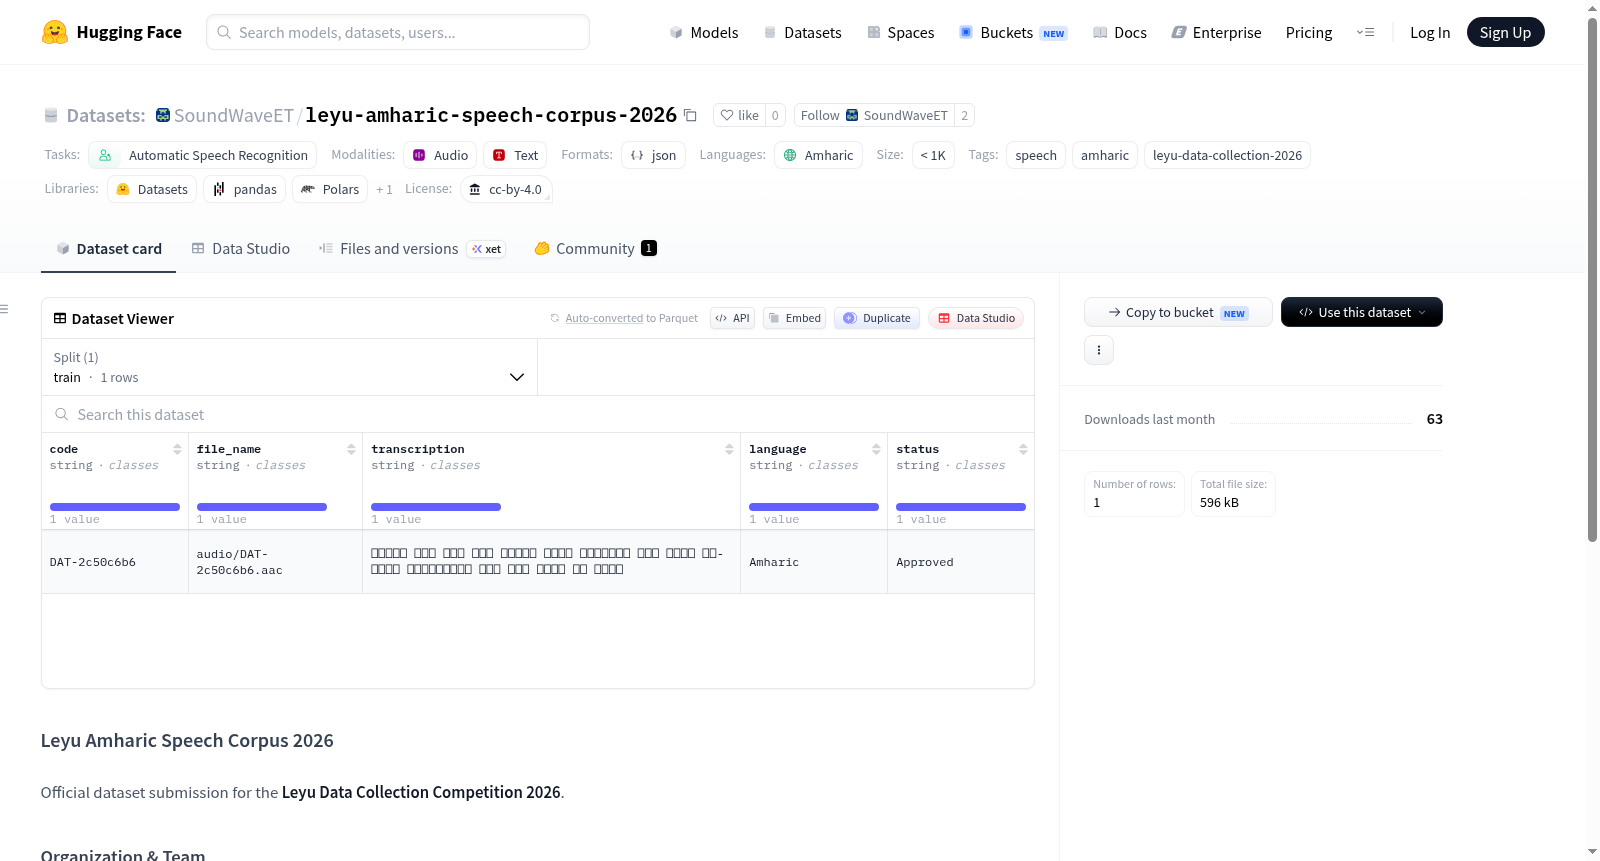
leyu-amharic-speech-corpus-2026
收藏资源简介:
Leyu Amharic Speech Corpus 2026 是一个面向自动语音识别(ASR)任务的阿姆哈拉语语音数据集。该数据集是“Leyu Data Collection Competition 2026”的官方提交内容,由 SoundWaveET 组织维护。数据集包含约1千到1万个语音样本,每个样本对应一段阿姆哈拉语文本转录。数据集采用 CC-BY-4.0 许可证,适用于训练和评估阿姆哈拉语语音识别系统。示例文本为阿姆哈拉语句子,如“ኢትዮጵያ የቡና መገኛ ሀገር በመሆንዋ በዓለም ትታወቃለች። የቡና ማፍላት ሥነ-ሥርዓት በኢትዮጵያውያን ዘንድ ትልቅ ባህላዊ ዋጋ አለው።...”
The Leyu Amharic Speech Corpus 2026 is an Amharic speech dataset designed for automatic speech recognition (ASR) tasks. It is the official submission of the Leyu Data Collection Competition 2026 and is maintained by SoundWaveET. The dataset contains approximately 1,000 to 10,000 speech samples, each with a corresponding Amharic text transcription. It is licensed under CC-BY-4.0 and is suitable for training and evaluating Amharic speech recognition systems. An example text is an Amharic sentence such as ኢትዮጵያ የቡና መገኛ ሀገር በመሆንዋ በዓለም ትታወቃለች። የቡና ማፍላት ሥነ-ሥርዓት በኢትዮጵያውያን ዘንድ ትልቅ ባህላዊ ዋጋ አለው።...
Leyu Amharic Speech Corpus 2026 数据集概述
基本信息
- 数据集名称: Leyu Amharic Speech Corpus 2026
- 语言: 阿姆哈拉语(am)
- 许可证: CC-BY-4.0
- 任务类别: 自动语音识别(Automatic Speech Recognition)
- 标签: 语音、阿姆哈拉语、leyu-data-collection-2026
- 数据规模: 1K < n < 10K 条样本
背景说明
该数据集是 Leyu Data Collection Competition 2026 的官方提交数据集,由 Hugging Face 组织 SoundWaveET 发布。
组织与团队
- Hugging Face 组织: SoundWaveET
- 数据集仓库: SoundWaveET/leyu-amharic-speech-corpus-2026
- 获批提交总数: 1
代表性记录
- 记录编码:
DAT-2c50c6b6 - 状态: 已批准(Approved)
- 提示文本(阿姆哈拉语): "ኢትዮጵያ የቡና መገኛ ሀገር በመሆንዋ በዓለም ትታወቃለች። የቡና ማፍላት ሥነ-ሥርዓት በኢትዮጵያውያን ዘንድ ትልቅ ባህላዊ ዋጋ አለው።..."(大意:埃塞俄比亚以咖啡产地闻名于世,咖啡冲泡仪式在埃塞俄比亚人中具有重要的文化价值……)