
tasksource/arct2
收藏官方服务:
资源简介:
该数据集用于评估神经网络模型对自然语言论证的理解能力。原始数据集存在统计线索的利用问题,因此构建了一个对抗性数据集以提供更稳健的评估。该数据集应作为未来工作的标准。
This dataset is designed to evaluate the natural language argument understanding capabilities of neural network models. The original dataset suffers from the issue of leveraging statistical cues, thus an adversarial dataset was constructed to enable more robust evaluation. This dataset should serve as a standard benchmark for future research work.
提供机构:
tasksource原始信息汇总
数据集概述
基本信息
- 许可证: Apache-2.0
- 任务类别: 文本分类
- 语言: 英语
来源与引用
- 数据集链接: https://github.com/IKMLab/arct2
- 出版物:
- 标题: Probing Neural Network Comprehension of Natural Language Arguments
- 作者: Niven, Timothy 和 Kao, Hung-Yu
- 会议: 第57届计算语言学协会会议
- 日期: 2019年7月
- 地点: 佛罗伦萨, 意大利
- 出版者: 计算语言学协会
- URL: https://www.aclweb.org/anthology/P19-1459
- 页码: 4658--4664
- 摘要: 文章探讨了BERT模型在Argument Reasoning Comprehension Task上的表现,指出其高准确率主要源于对数据集中伪统计线索的利用,并提出了一种对抗性数据集以更准确评估模型对自然语言论证的理解能力。
搜集汇总
数据集介绍
构建方式
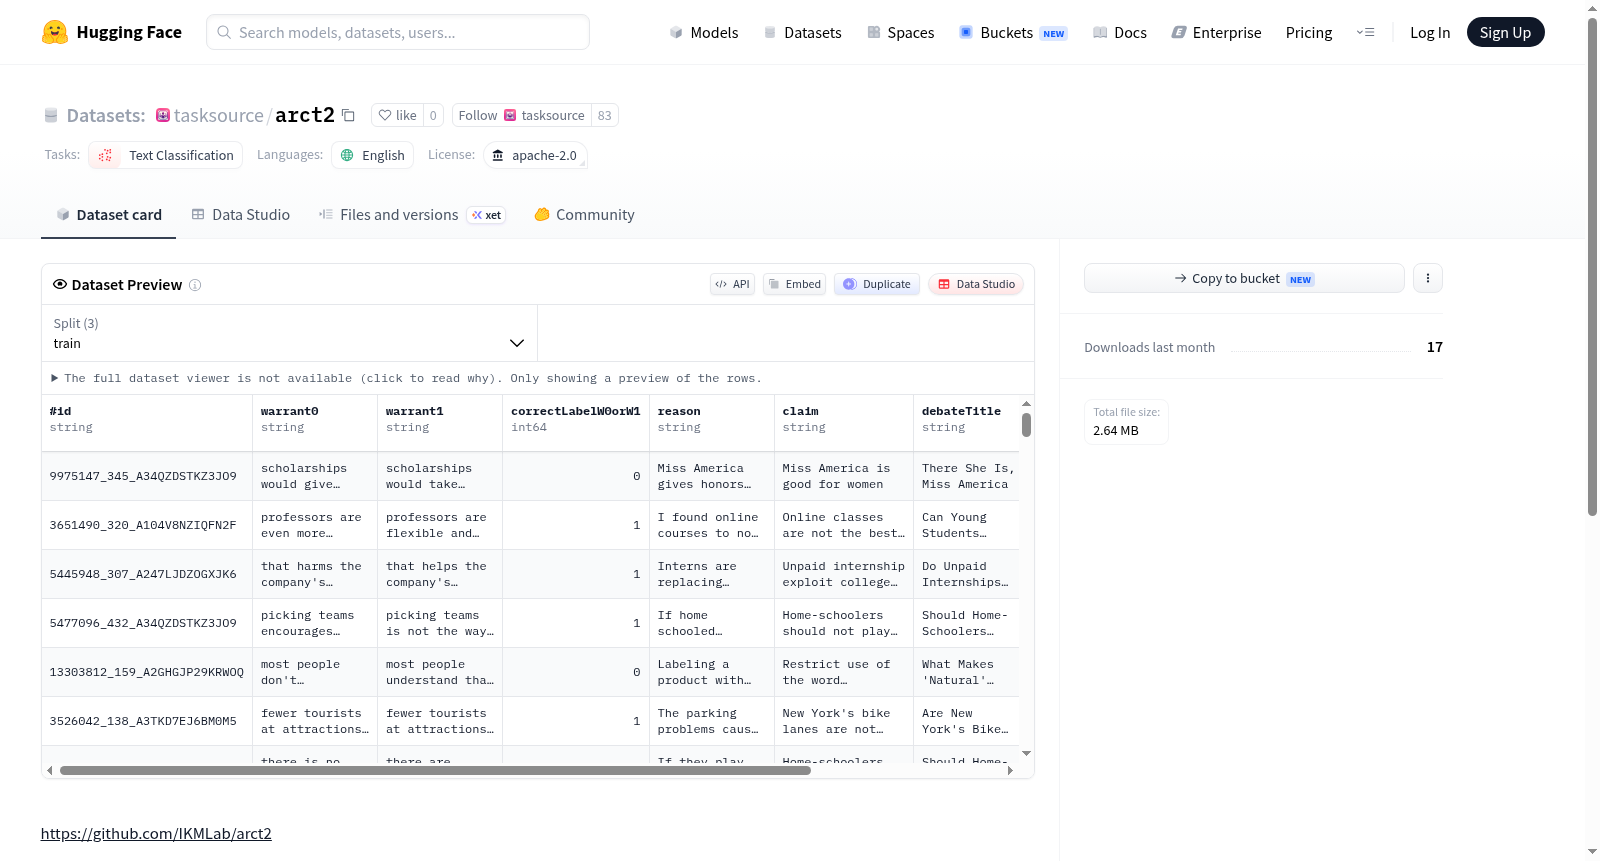
在自然语言论证理解的研究领域中,数据集的质量直接决定了模型对论证逻辑的捕捉能力。tasksource/arct2数据集基于Argument Reasoning Comprehension Task(ARCT)构建,其构建方式旨在解决原始数据集中存在的虚假统计线索问题。研究者通过分析BERT等模型对数据集中非本质特征的依赖,精心设计了对抗性样本,从而生成了一个更为严苛的评估集。该数据集沿用了原始任务的文本分类框架,每条样本包含一个论证片段及其对应的推理关系标签,确保模型必须在真正理解论证结构而非依赖表面模式的情况下进行预测。
特点
tasksource/arct2数据集的核心特点在于其对抗性设计,这使其成为检验模型论证理解鲁棒性的标杆。与原始ARCT数据集相比,arct2剔除了那些可以被模型利用的统计捷径,迫使模型从语义层面进行推理。数据集中的样本经过严格筛选,确保所有模型在该数据集上的表现均趋近于随机水平,从而更真实地反映模型对自然语言论证的深层理解能力。此外,该数据集采用Apache-2.0许可证公开,便于研究社区进行复现与扩展,为论证推理领域的评估提供了更为可靠的基准。
使用方法
使用tasksource/arct2数据集时,研究者可直接通过HuggingFace的datasets库进行加载,例如使用`load_dataset('tasksource/arct2')`命令获取数据。该数据集适用于文本分类任务,用户可将论证片段作为输入,预测其对应的高层推理关系。在模型评估阶段,推荐将arct2作为对抗性测试集,与原始ARCT数据集配合使用,以全面衡量模型在常规与对抗性场景下的表现。加载后的数据可直接用于PyTorch或TensorFlow等框架的训练与评估流程,无需额外预处理,极大地降低了使用门槛。
背景与挑战
背景概述
在自然语言处理领域,论证理解能力是衡量模型是否真正掌握语言深层逻辑的重要标尺。2019年,Timothy Niven与Hung-Yu Kao于ACL会议上提出了Argument Reasoning Comprehension Task(ARCT)数据集,旨在评估神经网络对自然语言论证的推理能力。该数据集由台湾大学等机构的研究人员构建,核心研究问题在于揭示预训练语言模型(如BERT)在论证理解任务中是否真正具备语义推理能力,抑或仅仅是利用了数据中的虚假统计线索。ARCT的诞生对后续研究产生了深远影响,其揭示的虚假关联现象促使学界重新审视数据集设计质量,并推动了更鲁棒评估基准的发展。
当前挑战
ARCT所面临的挑战首先体现在领域问题层面:论证理解任务要求模型区分论证中的前提与结论,并识别它们之间的逻辑关系,这远比简单的文本分类或情感分析更为复杂,需要模型具备深层的语义推理与常识知识。更为严峻的是,构建过程中研究人员发现原始数据集存在大量虚假统计线索,例如特定词汇的共现模式,使得BERT等模型仅凭这些伪特征即可达到接近人类基线的准确率,而非真正理解论证逻辑。为此,研究者构建了对抗性数据集ARCT2(即tasksource/arct2),通过精心设计样本以消除这些虚假关联,迫使模型必须依赖真实的论证推理才能做出正确判断,从而提供了一个更为严苛且可信的评估基准。
常用场景
经典使用场景
ARCT2数据集源自Argument Reasoning Comprehension Task的升级版本,专门用于评估自然语言处理模型在论证推理任务上的表现。该数据集精心设计了对抗性样本,以消除原有数据集中存在的虚假统计线索,从而更真实地检验模型对论证逻辑的理解能力。研究者通常将其作为文本分类任务中的基准数据集,通过让模型判断给定前提与主张之间的论证关系,来度量模型在复杂语义推理上的鲁棒性。其经典使用场景在于构建和测试对抗性论证理解系统,为自然语言推理领域提供了一个更具挑战性的评估平台。
衍生相关工作
ARCT2数据集的发布催生了多项具有影响力的后续工作。研究者基于其对抗性设计理念,开发了面向其他自然语言理解任务的对抗性数据集,如对抗性自然语言推理和对抗性问答数据集。在模型改进方面,相关工作尝试通过数据增强、因果推理和结构化知识注入等方法,提升模型对论证结构的理解能力。此外,该数据集还促进了可解释性研究的发展,学者们利用其对抗性样本分析模型内部表示中论证信息的编码方式,推动了神经网络可解释性分析技术的进步。
数据集最近研究
最新研究方向
在自然语言处理的前沿探索中,论证推理理解任务(Argument Reasoning Comprehension)正成为衡量模型语义理解能力的关键基准。tasksource/arct2数据集作为该领域的核心资源,其最新研究方向聚焦于揭露与对抗语言模型中的虚假统计线索。研究表明,诸如BERT等预训练模型在原始ARC任务上虽能达到接近人类的表现,但其性能高度依赖于数据集中的浅层模式而非真正的论证逻辑。为此,研究者构建了arct2这一对抗性版本,通过精心设计的样本迫使模型无法依赖捷径,从而更纯粹地检验其论证推理能力。这一方向不仅推动了对抗性数据集构建方法的发展,也为评估和提升语言模型的鲁棒性与深层语义理解提供了重要标尺,对构建可信赖的AI系统具有深远意义。
以上内容由遇见数据集搜集并总结生成


