
遇见数据集

WildSongBench

收藏
Hugging Face2026-09-10 更新2026-09-11 收录
官方服务:

资源简介:

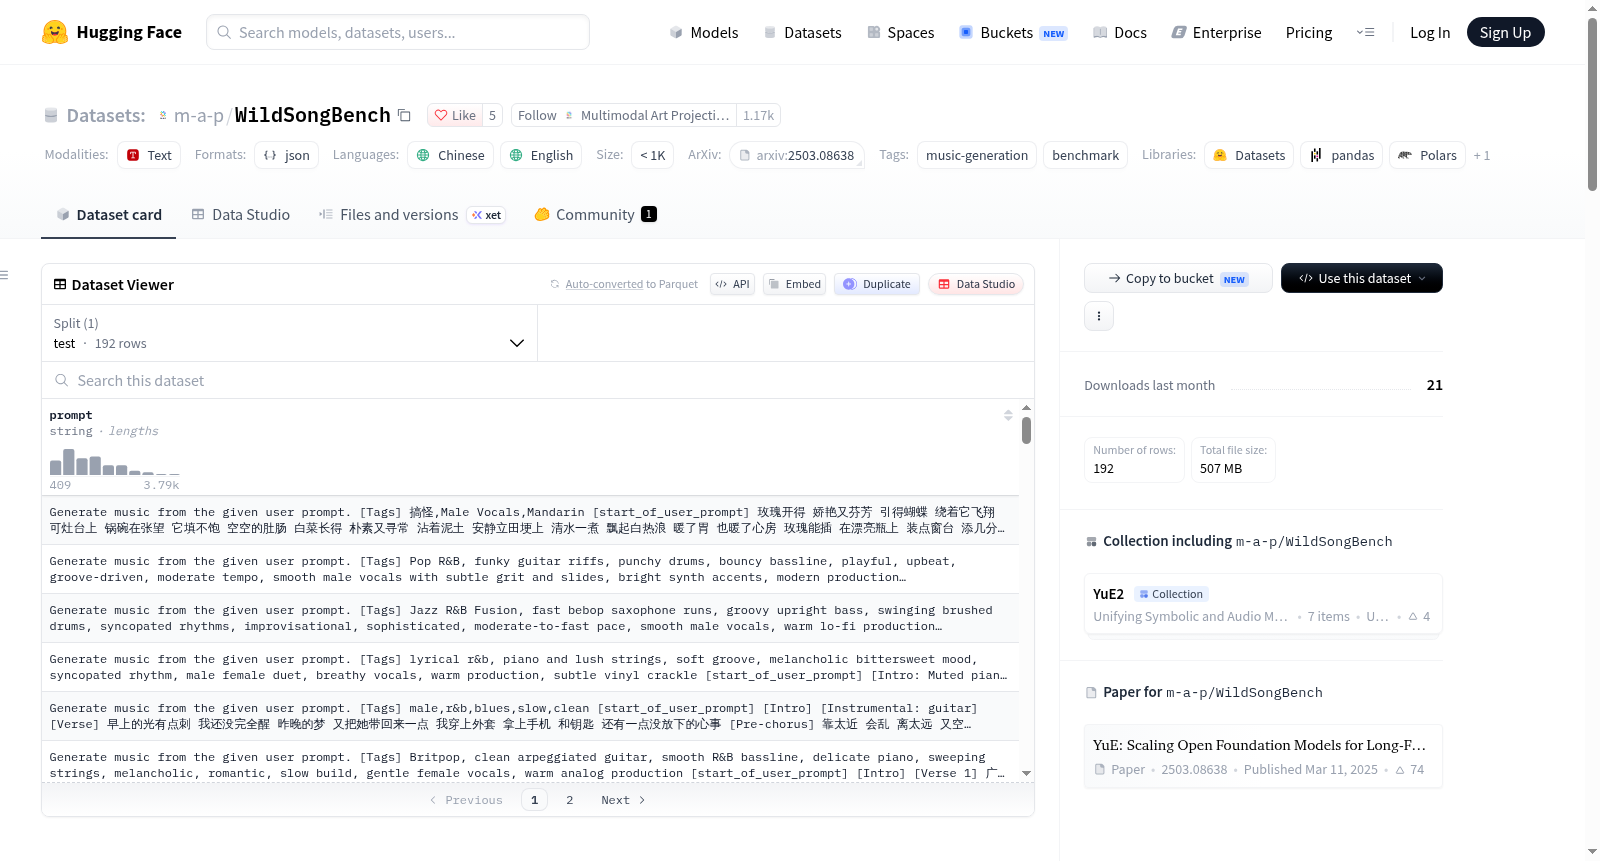
WildSongBench 是一个用于全曲音乐生成的基准数据集,包含 192 个音乐生成提示(prompt),其中 94 个中文提示和 98 个英文提示。该数据集专为 YuE2 模型的基准测试设计,提供了每个提示的精确输入、随机种子、参考评分以及一个最小化评估器,支持 SongBench、Q3O、MuQ-MuLan、AllMusicCaps 和 Qwen3-ASR PER 等指标。数据集不包含音频文件,仅包含文本形式的提示(prompt)以及生成所需的风格、歌词和种子信息。数据以 JSONL 格式存储于 prompts.jsonl 文件中,每个样本包含一个 prompt 字段。该数据集适用于评估和比较音乐生成模型的性能。

WildSongBench is a benchmark dataset for full-song music generation, containing 192 music generation prompts (94 Chinese prompts and 98 English prompts). Designed specifically for benchmarking the YuE2 model, it provides precise input, random seeds, reference scores, and a minimal evaluator for each prompt, supporting metrics such as SongBench, Q3O, MuQ-MuLan, AllMusicCaps, and Qwen3-ASR PER. The dataset does not include audio files; it only contains text-form prompts along with the necessary style, lyrics, and seed information for generation. Data is stored in JSONL format in the prompts.jsonl file, with each sample containing a prompt field. This dataset is suitable for evaluating and comparing the performance of music generation models.
创建时间:
2026-09-10
搜集汇总
数据集介绍
WildSongBench 数据集图片
构建方式
立足于长篇幅歌曲生成评测的空白,WildSongBench的构建遵循双语平衡与可复现原则。其核心语料由192条歌曲生成提示构成,其中中文提示94条、英文提示98条,语种分布近乎均等,以降低单一语言偏差对评测结论的干扰。每条提示并非孤立文本,而是与生成输入清单一一对应:清单中明确给出风格描述、歌词内容以及精确的随机种子,从而将提示由抽象指令转化为可重复执行的生成条件。该设计使不同系统在同一提示与同一随机条件下接受检验,为跨模型比较奠定基础。
特点
该数据集以评测导向而非训练导向为显著特征,规模虽在千条以下,却覆盖了完整歌曲生成任务所关注的多维能力。提示集合同时涉及中文与英文两种语言,便于考察模型在跨语种条件下的可控性与鲁棒性。数据集配套提供参考分数与最小化评测器,涵盖SongBench、Q3O、MuQ-MuLan、AllMusicCaps以及Qwen3-ASR PER等指标,形成从音频质量、提示控制到音频—文本相似度和音素错误率的多角度评估体系。音频本身不随数据集发布,避免了版权与存储方面的限制。
使用方法
使用者可通过Hugging Face数据集接口直接加载WildSongBench的测试划分,逐条读取提示文本,并依据生成输入清单中的风格、歌词与种子执行生成。评测时需按照既定协议,对零基索引为i的提示分别以种子831001+i与831019+i生成两个候选,经四次语音识别估计音素错误率后选取较低者参与全部指标计算。SongBench与音素错误率可在24GB显存条件下完成准备与评分,而Q3O因算力需求较高需使用80GB显存。为复现YuE2标准结果,应配合指定版本的模型与推理代码,并保留截断后的输出,最终分数汇总于评测脚本生成的摘要文件中。
背景与挑战
背景概述
随着音乐生成模型从片段合成迈向完整歌曲创作,如何在中英双语、多风格条件下系统评价长时音乐生成质量,成为该领域亟待解决的关键问题。WildSongBench由YuE2项目团队于2025年前后构建,汇聚192条歌曲生成提示(中文94条、英文98条),并配套生成输入、固定随机种子、参考分数及轻量评测器,覆盖SongBench、Q3O、MuQ-MuLan、AllMusicCaps与Qwen3-ASR PER等多维指标。该基准以开放权重与闭源系统的横向比较为特色,为长时音乐生成研究提供了可复现的评测范式,对推动开源音乐基础模型发展具有重要影响力。
当前挑战
该数据集所面向的领域问题在于完整歌曲生成中风格控制、歌词对齐与长时结构一致性的联合评价,其难度远高于短片段音乐生成。构建过程中,需在有限提示数量下兼顾中英双语平衡与风格多样性,并解决生成候选的种子复现、低资源音素错误率估计以及多项异质指标的统一汇总问题。Q3O评估依赖大规模GPU与特定调性评分,SongBench多维度打分与音频文本相似度计算亦受候选选择协议影响,不同系统间并非等算力比较,参考分数在重复生成中仍存在末位小数的不确定性,为基准的可复现性与公平性带来持续挑战。
常用场景
经典使用场景
在长篇幅音乐生成研究领域,如何系统评估模型对全曲结构、风格与歌词的联合控制能力,始终是核心议题。WildSongBench 作为面向整曲生成的基准,精心汇集了192条双语提示词,其中汉语94条、英语98条,并配套提供精确的生成输入、随机种子、参考分数以及涵盖 SongBench、Q3O、MuQ-MuLan、AllMusicCaps 与 Qwen3-ASR PER 等指标的最小化评测器。研究者借此能够在统一条件下,对开放权重与专有系统的整曲生成质量展开可复现的横向比较。
解决学术问题
该数据集有效回应了音乐生成评测中长期存在的若干难题:其一,弥补了以往基准多聚焦短片段或单一维度、难以反映全曲结构连贯性的缺陷;其二,通过固定提示、种子与选优协议,缓解了生成结果随机性带来的评测不可比问题;其三,SongBench 七个质量维度的整合、Q3O 对提示控制力的量化以及 PER 对发音准确度的衡量,共同构建了兼顾音乐性、可控性与语义保真度的多维评估框架,为模型能力的诊断与迭代提供了坚实依据。
衍生相关工作
围绕 WildSongBench,已衍生出一系列相互关联的经典工作。YuE2-3B 作为主要评测对象,配合 YuE2-Vae-legacy 实现了标准化的基准打分流程;MERT-v2-30s 与 MERT-v2-FullSong 为音频表征提供了支撑;SheetSage2 则服务于符号规划与结构分析。此外,该基准还被用于对比 Mureka 9、Suno v5 与 v5.5、LeVo 2、MiniMax Music 系列、HeartMuLa、Muse、ACE-Step 1.5、DiffRhythm 2、YuE 1 及 SongBloom 等系统,推动了整曲音乐生成领域的可复现研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

