RAMDocs
收藏资源简介:
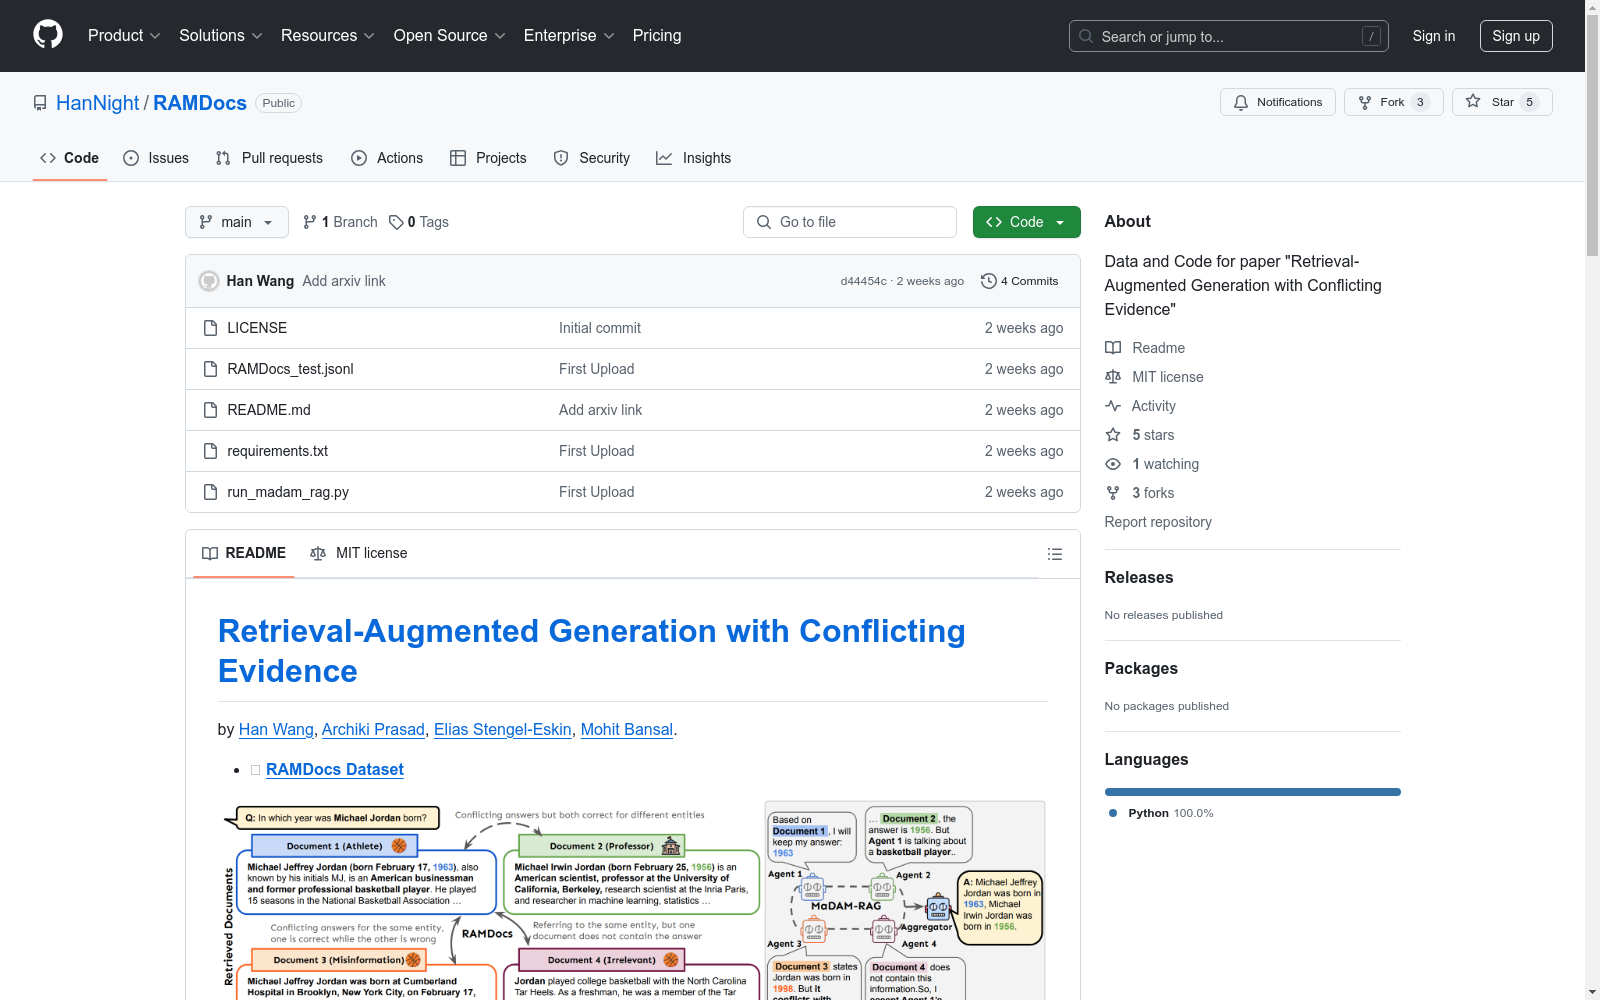
RAMDocs是一个模拟复杂和现实场景的数据集,用于处理用户查询中的冲突证据,包括歧义、错误信息和噪声。每个实例包含问题、文档列表(每个文档包含文本、类型和答案)、歧义实体列表、正确答案列表和错误答案列表。
RAMDocs is a dataset that simulates complex and realistic scenarios for handling conflicting evidence in user queries, including ambiguity, misinformation and noise. Each instance consists of a question, a list of documents (each containing text, type and answer), a list of ambiguous entities, a list of correct answers and a list of incorrect answers.
RAMDocs数据集概述
数据集基本信息
- 名称: RAMDocs
- 领域: 检索增强生成(Retrieval-Augmented Generation)
- 主要用途: 模拟复杂且现实的冲突证据场景,包括歧义、错误信息和噪声
- 数据文件:
RAMDocs_test.jsonl
数据结构
每个实例包含以下字段:
question: 问题文本documents: 文档列表,每个文档包含:text: 文档文本type: 文档类型(correct正确回答、misinfo错误信息、noise噪声)answer: 文档中的答案(noise类型为unknown)
disambig_entity: 问题中歧义实体的消歧列表gold_answers: 不同消歧实体的正确答案列表wrong_answers: 问题的错误答案列表
相关框架
- MADAM-RAG: 结构化多代理框架,用于处理文档间冲突、错误信息和噪声
- 关键组件:
- 独立LLM对话代理
- 中央聚合器
- 迭代多轮辩论过程
- 关键组件:
运行要求
-
依赖安装: bash pip install -r requirements.txt
-
运行命令示例: bash python run_madam_rag.py --model_name meta-llama/Llama-3.3-70B-Instruct --dataset_path RAMDocs_test.jsonl
引用信息
bibtex @article{wang2025retrieval, title={Retrieval-Augmented Generation with Conflicting Evidence}, author={Han Wang and Archiki Prasad and Elias Stengel-Eskin and Mohit Bansal}, year={2025}, journal={arXiv preprint arXiv:2504.13079} }
致谢
感谢AmbigDocs作者公开数据