
遇见数据集

marin-community/openthoughts4-code-9168-prompts-qwen3-4b-n16-flattened-logprobs-k16

收藏
Hugging Face2026-05-05 更新2026-05-10 收录
官方服务:

资源简介:

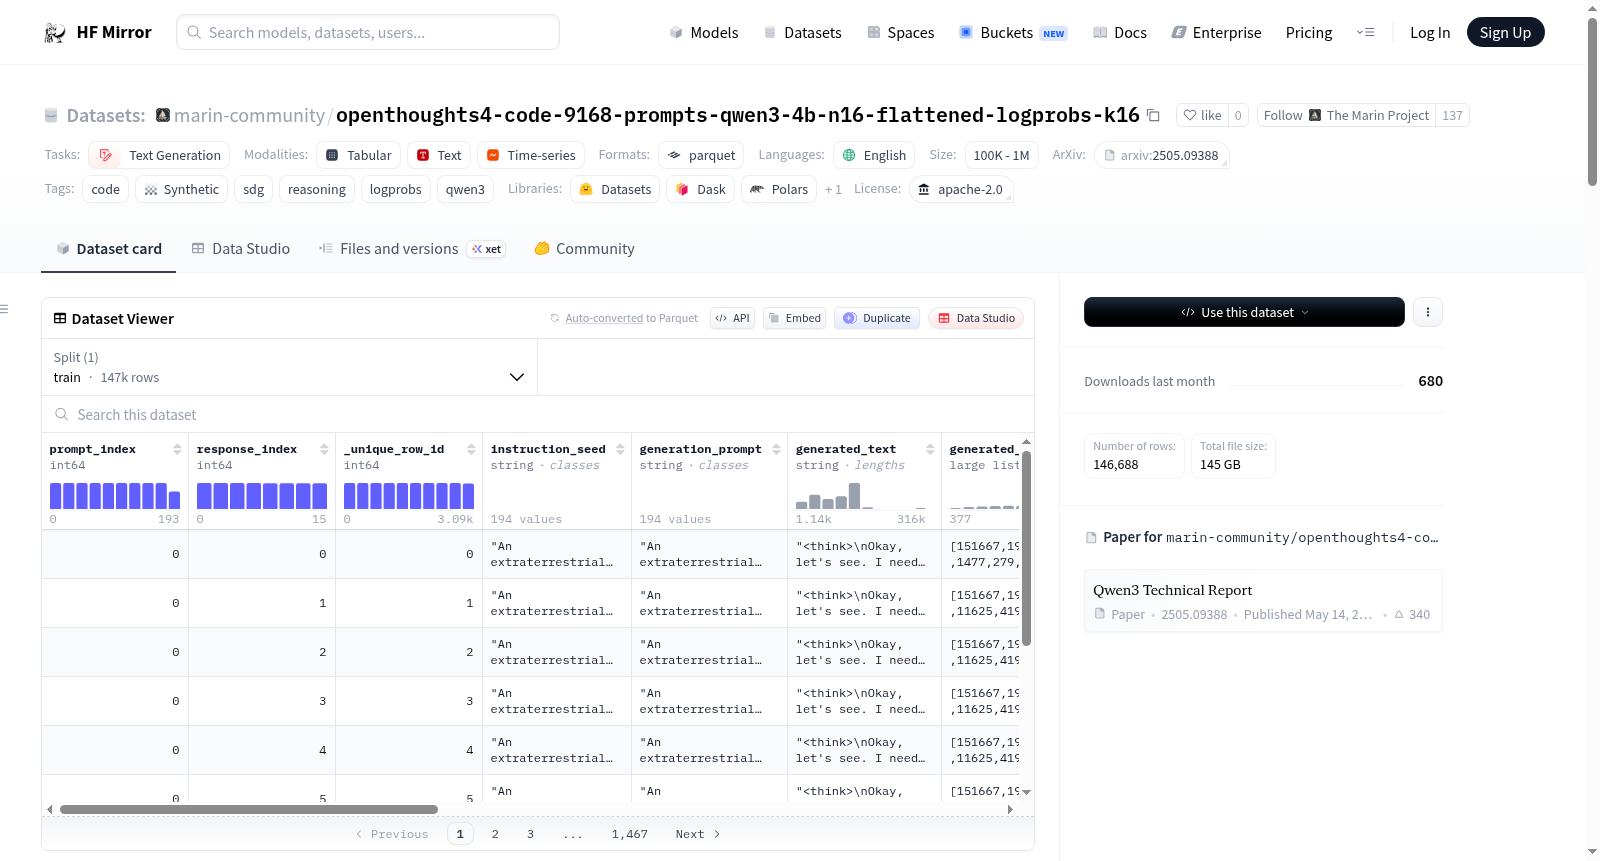
OpenThoughts-4 Code SDG: Qwen3-4B数据集是一个基于Qwen/Qwen3-4B模型生成的代码相关数据集。数据集包含了从9,168个独特提示中每个提示采样16次的生成结果,每个生成的token都存储了选择的token的对数概率以及词汇表中前16个最高对数概率。数据集旨在支持蒸馏、KL风格微调、重新排名和不确定性分析等任务。生成设置包括使用vLLM在TPU v6e-8上进行推理,温度为0.8,最大生成token数为32,768。数据集以扁平化的parquet表格形式存储,每行代表一个(提示,样本索引)对,共146,688行。

The OpenThoughts-4 Code SDG: Qwen3-4B dataset is a code-related dataset generated based on the Qwen/Qwen3-4B model. The dataset contains generation results sampled 16 times for each of the 9,168 unique prompts. For each generated token, the log probability of the selected token and the top 16 highest log probabilities from the vocabulary are stored. This dataset is intended to support tasks such as distillation, KL-style fine-tuning, re-ranking, and uncertainty analysis. The generation settings include inference using vLLM on TPU v6e-8, with a temperature of 0.8 and a maximum number of generated tokens of 32,768. The dataset is stored in a flattened Parquet table format, where each row represents a (prompt, sample index) pair, totaling 146,688 rows.
提供机构:
marin-community
搜集汇总
数据集介绍
marin-community/openthoughts4-code-9168-prompts-qwen3-4b-n16-flattened-logprobs-k16 数据集图片
构建方式
该数据集源自Marin OpenThoughts-4项目中的代码合成数据生成(SDG)任务,以9,168条独特的编程提示为种子,借助Qwen3-4B模型进行规模化推理采样。每个提示均被独立采样16次,生成过程使用vLLM推理引擎在TPU v6e-8集群上完成,温度参数设为0.8,最大生成长度达到32,768个token。为便于后续蒸馏与重排序研究,系统在生成每个token时记录了该token的对数概率以及词汇表中排名前16的候选token的完整分布信息,并以扁平化列表形式存储于Parquet表格中。最终,数据集共包含146,688行数据,每行对应一个唯一的提示-样本对。
使用方法
用户可通过HuggingFace Datasets库加载默认配置的完整训练集,底层Parquet文件按约64行每片分片存储,便于分布式处理。使用时应将top-k数组从一维列表重构为(T, k)矩阵,具体可通过NumPy的reshape函数实现,其中T为生成token数,k固定为16。需注意所选token可能不在top-16候选集中,故应优先使用generated_token_logprobs字段获取准确对数概率。该数据集适合作为监督式微调或偏好学习的训练数据,也可结合配套的Qwen3-32B等同类数据集进行多模型对比分析。
背景与挑战
背景概述
OpenThoughts-4 Code SDG数据集由marin-community社区于2025年创建,基于Qwen3-4B模型在9,168个编程提示上通过16次采样生成。该数据集聚焦于代码合成数据生成领域,旨在通过记录每个生成令牌的顶层16个对数概率,为知识蒸馏、KL风格微调、重排序和不确定性分析提供结构化支撑。其核心研究问题在于如何从大型语言模型的解码过程中捕获细粒度的概率信息,以推动代码生成任务的优化。作为OpenThoughts-4系列的一部分,该数据集与Qwen3-30B-A3B和Qwen3-32B等模型生成的版本形成互补,共同推动了合成数据在编程领域的高效利用与模型性能的提升。
当前挑战
该数据集面临的挑战主要包括:1)在领域问题层面,代码生成任务需要模型精准理解编程语义与逻辑结构,而现有模型在复杂多步推理中常出现符号错误或上下文遗忘,细粒度对数概率的引入虽有助于诊断,但如何有效利用这些概率信息进行模型改进仍是一大难题;2)在构建过程中,需管理n=16次采样与k=16个顶层令牌的存储结构,将322,768令牌长度的生成结果展平为parquet格式,这不仅增加了数据处理复杂度,还需在TPU v6e-8硬件上平衡推理吞吐与内存开销,确保数据质量与完整性。
常用场景
经典使用场景
OpenThoughts-4 Code SDG数据集专为代码生成领域的大语言模型推理能力增强而设计,其核心使用场景在于利用Qwen3-4B模型对9,168个编程提示进行16次独立采样,生成包含完整中间推理步骤的代码响应。每个生成token不仅记录被选token的对数概率,还保存了词汇表上前16个候选token的完整概率分布,这使得该数据集成为知识蒸馏、KL散度微调、重排序以及不确定性分析的理想资源。研究者和工程师可借助这些细粒度的概率信息,深入剖析模型在代码生成过程中的决策路径,从而针对性优化模型性能。
解决学术问题
该数据集有效解决了代码生成领域训练数据稀疏性和推理过程不可解释性的关键学术难题。通过存储每个生成步骤的top-16对数概率分布,它为探索模型在代码合成中的概率空间结构提供了前所未有的数据粒度,使得研究者能够量化模型的不确定性、识别潜在的错误生成模式,并开发基于概率分布的监督信号来改进模型。这一数据资源显著推动了从黑箱生成向可解释推理的范式转变,为构建更可靠、更鲁棒的代码生成系统奠定了实证基础,对提升程序综合、自动修复等研究的科学严谨性具有深远意义。
实际应用
在实际应用层面,该数据集为工业级代码生成系统的迭代优化提供了直接支撑。软件工程团队可利用其中丰富的推理路径和概率信息,训练更高效的代码补全与自动编程助手,降低错误生成率;同时,通过对模型不确定性进行实时监控,可在关键部署场景中实施风险控制。此外,数据集中96,688条带概率注释的代码样本,为开发代码质量评估工具、智能教育平台中的编程辅导系统,以及自动化代码审查与测试生成服务提供了高质量的训练素材,有效加速了从学术模型到生产级应用的能力迁移。
数据集最近研究
最新研究方向
面向代码生成与推理的合成数据增强与对数概率蒸馏。当前,利用大型语言模型进行代码合成数据生成(SDG)已成为提升模型推理能力的前沿路径。该数据集通过Qwen3-4B对Marin社区的OpenThoughts-4代码提示集进行多次采样,并创新性地存储了每个生成token的选定对数概率及词汇表上top-16候选的对数概率信息,为知识蒸馏、KL风格微调、重排序与不确定性分析提供了细粒度的概率分布基础。这一设计紧密契合了通过教师模型输出分布进行学生模型训练(即logit-level distillation)的热点研究方向,在开源社区中推动了基于分布对齐的高效代码推理模型开发,具有重要的基准构建与算法验证意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

