
遇见数据集

lion-ai/MedKG-QA

收藏
Hugging Face2026-06-27 更新2026-07-22 收录
官方服务:

资源简介:

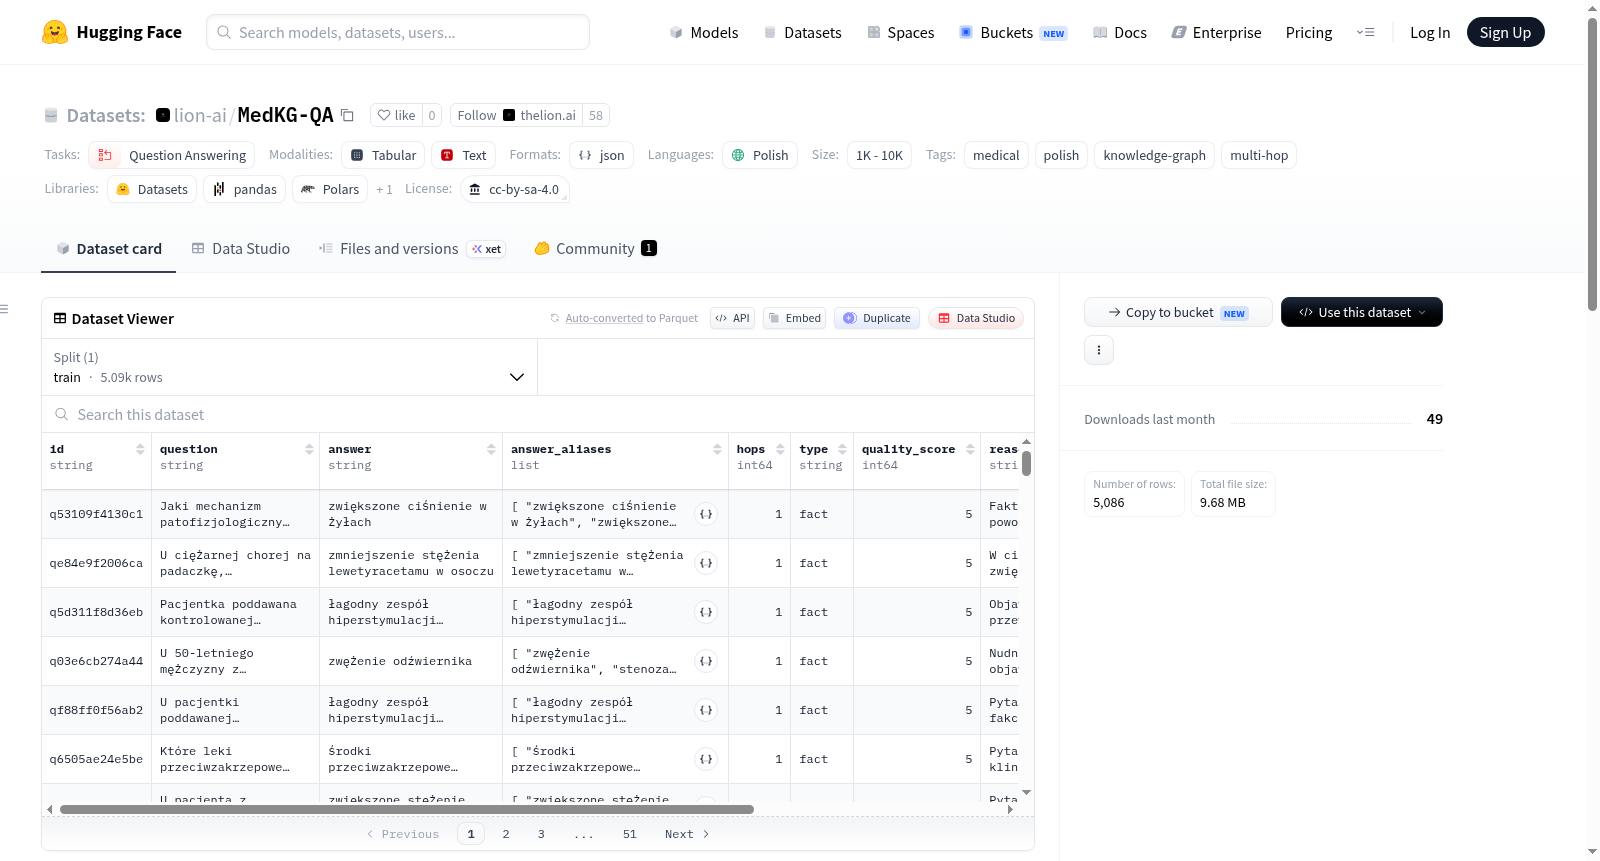
MedKG-QA是一个波兰语医学问答数据集,包含5086个经过验证的医学知识控制问题。这些问题从医学知识图谱MedKG生成,并通过自动质量门过滤,确保高质量。数据集组成包括跳数分布:1跳844个、2跳653个、3跳165个、4跳166个、5跳3258个;其中事实(基于1-2跳关系)1497个,案例(基于3+跳关系,模拟临床病例)3589个。平均质量评分(由LLM法官评估,范围1-5)为4.94。验证过程包括四个步骤:答案与源证据的一致性、基于源片段的可解性、无答案泄露、以及由独立LLM法官评估质量(评分≥4/5)。数据列包括id、问题(波兰语)、答案、答案别名、跳数、类型(事实或案例)、质量评分、推理过程和证据(来自知识图谱的事实和引用)。数据来源包括波兰维基百科(CC BY-SA 4.0)、药物说明书(来自URPL注册,CC BY 4.0)和ICD-10波兰版。数据集基于CC BY-SA 4.0许可证发布。注意:问题由LLM生成并自动验证,可能包含错误,不构成医疗建议。

MedKG-QA is a Polish-language medical knowledge-grounded question answering dataset containing 5,086 validated questions. These questions are generated from the medical knowledge graph MedKG and filtered via an automatic quality gate to ensure high quality. The hop count distribution of the dataset is as follows: 844 1-hop questions, 653 2-hop questions, 165 3-hop questions, 166 4-hop questions, and 3,258 5-hop questions. Among them, there are 1,497 factual questions (based on 1-2 hop relations) and 3,589 case questions (based on 3+ hop relations, which simulate clinical cases). The average quality score, evaluated by LLM judges with a rating range of 1 to 5, is 4.94. The validation process includes four steps: consistency between the answer and source evidence, solvability based on source snippets, absence of answer leakage, and quality assessment by independent LLM judges requiring a score of ≥4/5. The dataset columns include id, question (Polish), answer, answer aliases, hop count, type (factual or case), quality score, reasoning process, and evidence (facts and citations from the knowledge graph). Data sources include Polish Wikipedia (CC BY-SA 4.0), drug package inserts (from the URPL registry, CC BY 4.0), and the Polish edition of ICD-10. The dataset is released under the CC BY-SA 4.0 license. Note: Questions are generated by LLMs and automatically verified, may contain errors, and do not constitute medical advice.
提供机构:
lion-ai
搜集汇总
数据集介绍
lion-ai/MedKG-QA 数据集图片
构建方式
MedKG-QA数据集以波兰语医学知识图谱MedKG为基石,通过自动化流程生成包含5086个问题的医学知识测试集。构建过程分为两步:首先从图谱中抽取不同跳数的关系路径作为问题骨架,随后利用大型语言模型将骨架转化为自然语言问题。为确保质量,数据集设计了四道自动验证关卡,涵盖答案与源证据的一致性、基于片段的可解性、答案泄露检测以及由独立评审模型给出的质量评分(要求不低于4/5),且生成器与评审器分属不同模型家族以避免自洽性偏差。最终数据涵盖1至5跳问题,其中1-2跳构成事实类问题,3跳以上则整合为临床 vignette。
特点
该数据集的核心特色在于其临床导向的双层结构:1497个事实类问题(1-2跳)侧重于单一医学事实的检索,3589个 vignette类问题(3跳以上)则模拟临床情境,要求将多个特征(如症状、并发症、药物作用)汇聚于单一诊断或药物,避免人为跳跃,类似于波兰版USMLE题型。每道题均配备结构化推理路径和带引用的图谱证据,平均质量评分高达4.94/5,且通过多维度校验确保了医学准确性、自然度和非平凡性。此外,数据来源涵盖CC BY-SA许可的波兰维基百科、官方药品说明书及ICD-10编码,确保了法律合规性。
使用方法
数据集以JSONL格式提供,包含id、question、answer、answer_aliases、hops、type(fact或vignette)、quality_score、reasoning和evidence等字段。用户可直接加载qa.jsonl文件进行模型评估或微调。使用时可基于type字段筛选事实或临床场景问题,或根据hops选择特定推理复杂度。evidence字段提供了可追溯的知识图谱三元组及源引用,便于开展可解释的开放书本问答实验。数据集仅用于波兰语医学研究,不构成医疗建议,且在采用时需遵守CC BY-SA 4.0许可协议注明出处。
背景与挑战
背景概述
医学知识问答系统是自然语言处理与医疗健康领域交叉的重要研究方向,其核心挑战在于构建能够准确理解复杂临床情境并提供可靠答案的智能模型。MedKG-QA数据集由波兰研究机构Lion AI团队于近期创建,基于波兰医学知识图谱MedKG自动生成并经过多轮质量过滤,包含5086个经过验证的波兰语医学知识控制问题。该数据集覆盖了从单跳事实查询到多跳病例推理的广泛问题类型,其中复杂病例问答(跳数≥3)占比超过70%,平均质量评分高达4.94/5。作为首个大规模波兰语医学多跳问答基准,MedKG-QA填补了该语言资源在医疗AI评估领域的空白,为评估模型在真实临床推理场景中的表现提供了标准化测试平台。
当前挑战
MedKG-QA所解决的核心领域挑战是医学多跳推理问题的自动构建与质量保障。传统手工标注的医学问答数据集成本高昂且规模有限,难以覆盖知识图谱中复杂的实体关系组合。在构建过程中,研究团队面临三大挑战:首先,如何从知识图谱中自动生成自然、符合临床逻辑的多跳推理问题,避免出现跳数之间不相关或信息泄露等常见缺陷;其次,需要设计多维度自动验证流程,包括答案与源证据的一致性检查、基于源文本的可解性验证、答案泄漏检测以及独立裁判模型的综合质量评分;最后,需确保生成的问题在波兰语环境下保持医学专业性与语言自然性,同时消除生成模型与评价模型之间的偏见关联。
常用场景
经典使用场景
MedKG-QA数据集专为波兰语医学领域的多跳问答任务而设计,其核心应用场景围绕知识图谱驱动的复杂推理问题展开。该数据集精心构造了从简单事实查询(1-2跳)到临床小病例(3跳以上)的多层次问题,共计5086个经过严格质量审核的医学知识问题。研究者可基于此数据集训练和评估模型在医学知识图谱中进行多步推理的能力,尤其适合开发能够整合分散医学事实、模拟临床诊断思维过程的问答系统。数据集中每个问题均附带推理路径、证据链及同义答案变体,为端到端的多跳推理研究提供了高质量的基准测试平台。
解决学术问题
该数据集在学术层面主要解决了医学问答领域中高质量、多跳推理数据的匮乏问题。传统医学问答数据集往往局限于单跳事实查询或表面语义匹配,难以反映真实临床场景中需要综合多种症状、并发症、风险因素进行判断的复杂推理需求。MedKG-QA通过系统性地从结构化医学知识图谱中生成问题,并采用四阶段自动验证流程(答案一致性、可解性、答案泄露检测、质量评分),确保了数据集的可靠性与临床合理性。其独特的‘事实-病例’二元结构,为研究不同推理深度下的模型表现差异提供了可控的实验环境,推动了知识增强型语言模型在医学领域的评估方法发展。
衍生相关工作
MedKG-QA的发布催生了多个相关研究方向。首先,其高质量的多跳推理结构激励了针对波兰语医学知识图谱问答的专用模型开发,如基于图神经网络与预训练语言模型融合的推理框架。其次,数据集中严格的自动验证流程被后续研究借鉴,形成了可复用的问答数据质量控制方法论。此外,该数据集推动了跨语言医学知识迁移研究——研究者尝试将MedKG-QA的推理模式与英语医学QA数据集(如MedQA)进行对齐,探索多语言医学问答的泛化能力。基于其附带的证据链标注,一些工作进一步发展为解释性医学问答系统,致力于在给出答案的同时提供可追溯的临床推理过程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

