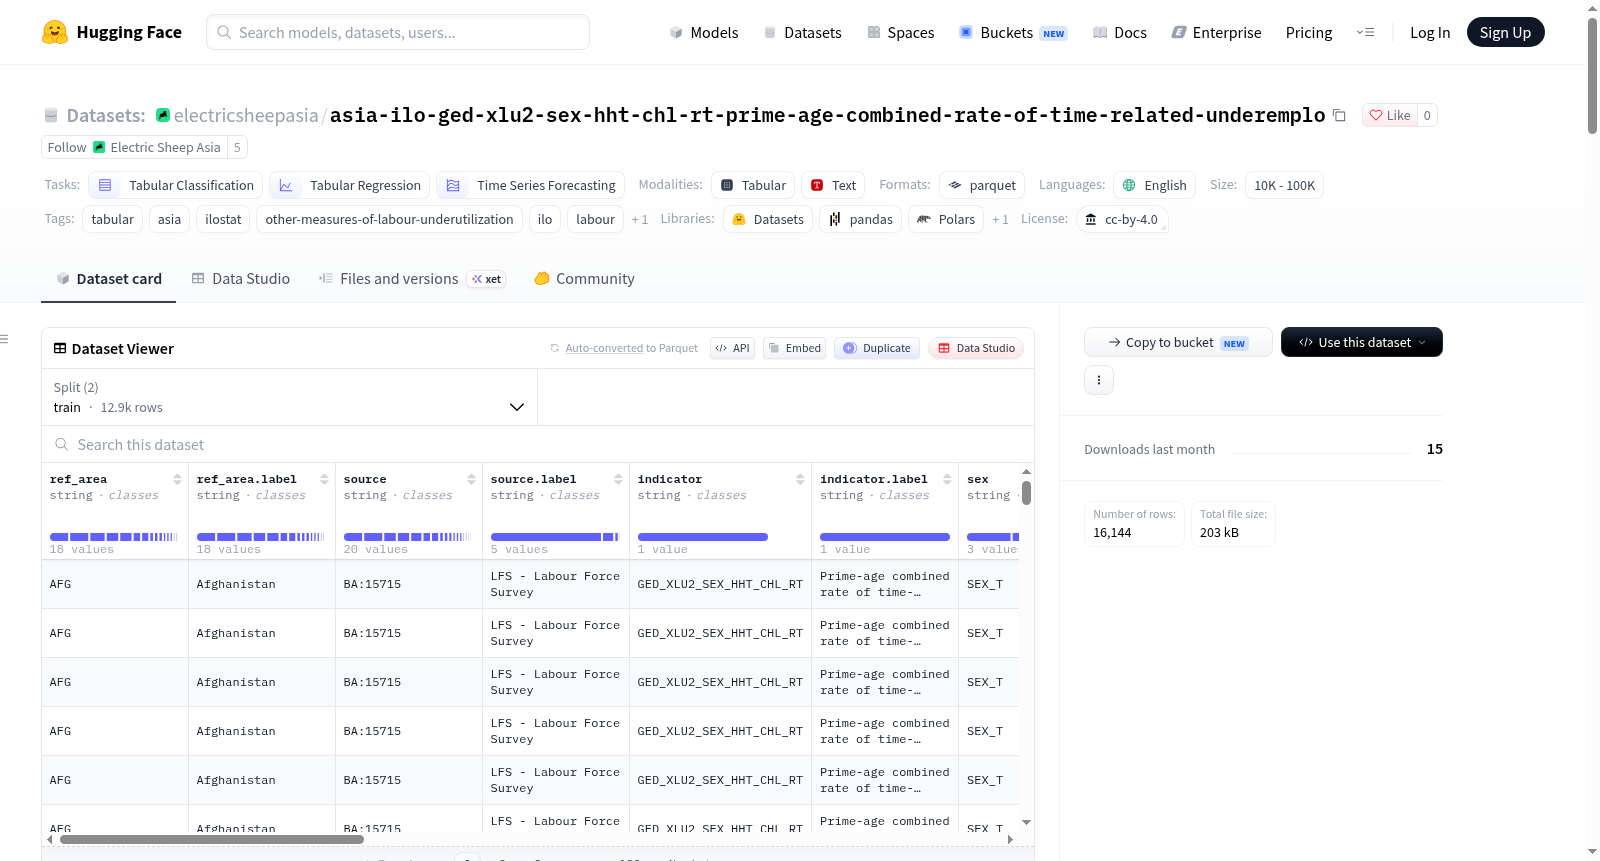
electricsheepasia/asia-ilo-ged-xlu2-sex-hht-chl-rt-prime-age-combined-rate-of-time-related-underemplo
收藏资源简介:
该数据集包含来自国际劳工组织(ILO)ILOSTAT数据库的“其他劳动力未充分利用指标”数据,专门针对亚洲地区。核心指标为“Prime-age combined rate of time-related underemployment and unemployment (LU2) by sex, household type and presence of children (%)”,即按性别、家庭类型和儿童存在情况划分的黄金年龄时间相关就业不足和失业综合率(LU2)。数据集涵盖22个亚洲国家,时间跨度为2000年至2025年,共包含16,144个观测值。数据通过ILOSTAT REST API获取,并经过ILO根据国际劳工统计学家会议(ICLS)定义进行标准化处理。数据集提供了详细的列结构,包括国家代码、来源、指标、性别分类、家庭类型分类、儿童存在分类、年份、观测值及状态等维度,适用于表格分类、回归和时间序列预测等任务。
--- license: cc-by-4.0 language: - en task_categories: - 表格分类 - 表格回归 - 时间序列预测 multilinguality: 单语言 size_categories: - 10000 < 样本数 < 100000 tags: - 表格数据 - 亚洲 - ILOSTAT - 劳动力未充分利用其他指标 - ILO - 劳动力 - 就业 pretty_name: "按性别、家庭类型及子女情况划分的劳动年龄人口时间型未充分就业与失业综合率(LU2) | 亚洲地区(ILOSTAT)" --- # 按性别、家庭类型及子女情况划分的劳动年龄人口时间型未充分就业与失业综合率(LU2) | 亚洲地区(ILOSTAT) 🌏 **16144条观测样本** · **22个亚洲国家** · **2000–2025年** · *由[Electric Sheep Asia](https://huggingface.co/electricsheepasia)重新整理发布*      ## TL;DR 本数据集包含**22个亚洲国家**2000–2025年间的**16144条“劳动力未充分利用其他指标”数据**,涵盖**1个核心指标**。 ## 关于数据源 **ILOSTAT(国际劳工组织统计数据库)**是国际劳工组织(ILO)的中央统计数据库,是全球领先的劳动力统计权威来源。其收录涵盖就业、失业、薪酬、工作时长、童工、非正规经济、社会保障、职业伤害以及可持续发展目标(SDG)体面工作目标等各类指标,数据来源于全国劳动力调查、住户收入调查、企业调查及行政记录。该数据库覆盖全球200余个经济体,由国际劳工组织统计司负责数据标准化工作。 - **数据源**:[ILOSTAT](https://www.ilo.org/shinyapps/bulkexplorer/?id=GED_XLU2_SEX_HHT_CHL_RT) - **发布方**:国际劳工组织(ILO) - **许可证**:[cc-by-4.0](https://creativecommons.org/licenses/by/4.0/) - **主题**:劳动力未充分利用其他指标 ## 数据处理方法 本数据集直接从ILOSTAT REST API(`https://rplumber.ilo.org/data/indicator?id=GED_XLU2_SEX_HHT_CHL_RT`)拉取数据,并筛选出亚洲地区的ISO 3166-1 alpha-3国家代码样本。ILOSTAT依据国际劳工统计学家会议(ICLS)的定义对原始调查微观数据进行标准化处理;数据来源信息将在`source.label`字段中标记,以确保可追溯性。 ## 地理覆盖范围 22个亚洲国家 · 以下为按样本量排序的前10个国家及剩余部分: | 国家代码 | 样本量 | 起始年份 | 结束年份 | |---------|-----:|-----------:|----------:| | `CYP` | 1,975 | 2000 | 2020 | | `IRN` | 1,967 | 2008 | 2024 | | `TUR` | 1,635 | 2004 | 2024 | | `KHM` | 1,605 | 2000 | 2023 | | `LKA` | 1,325 | 2010 | 2022 | | `PAK` | 1,308 | 2006 | 2025 | | `VNM` | 1,050 | 2007 | 2024 | | `PHL` | 837 | 2017 | 2023 | | `MNG` | 800 | 2010 | 2017 | | `THA` | 691 | 2016 | 2021 | | `ARM` | 438 | 2014 | 2017 | | `AFG` | 433 | 2014 | 2021 | | `BTN` | 330 | 2021 | 2024 | | `MMR` | 328 | 2018 | 2020 | | `LAO` | 321 | 2010 | 2022 | | ... | 另有7个国家 | | | ## 指标(示例) - `GED_XLU2_SEX_HHT_CHL_RT` — 按性别、家庭类型及子女情况划分的劳动年龄人口时间型未充分就业与失业综合率(LU2,单位:%) ## 数据结构 | 字段名 | 数据类型 | 字段说明 | 示例值 | |--------|------|-------------|---------| | `ref_area` | `string` | ISO 3166-1 alpha-3 国家代码 | `AFG` | | `ref_area.label` | `string` | 英文国家名称 | `阿富汗` | | `source` | `string` | ILOSTAT 数据源代码(如劳动力调查) | `BA:15715` | | `source.label` | `string` | 英文数据源名称 | `劳动力调查(LFS)` | | `indicator` | `string` | ILOSTAT 指标代码 | `GED_XLU2_SEX_HHT_CHL_RT` | | `indicator.label` | `string` | 英文指标名称 | `Prime-age combined rate of time-relat…` | | `sex` | `string` | 性别细分维度(SEX_T=总计,SEX_M=男性,SEX_F=女性) | `SEX_T` | | `sex.label` | `string` | 维度说明 | `总计` | | `classif1` | `string` | 第一分类变量(年龄、教育程度、就业状态等) | `HHT_AGGREGATE_TOTAL` | | `classif1.label` | `string` | 分类变量说明 | `家庭类型:总计` | | `classif2` | `string` | 可选第二分类变量 | `CHL_AGET6_TOTAL` | | `classif2.label` | `string` | 分类变量说明 | `6岁以下子女情况:总计` | | `time` | `int64` | 观测年份 | `2021` | | `obs_value` | `float64` | 观测指标值(单位详见指标定义) | `12.022` | | `obs_status` | `string` | 观测状态标记(如临时数据、不可靠数据) | `U` | | `obs_status.label` | `string` | 状态说明 | `不可靠` | | `note_indicator` | `string` | 指标相关备注 | `—` | | `note_indicator.label` | `string` | 备注说明 | `—` | | `note_source` | `string` | 数据源相关备注 | `R1:3513_S3:8` | | `note_source.label` | `string` | 备注说明 | `存储库:ILO统计司 - 微观数据…` | ## 细分维度 以下字段提供数据细分维度: - **`sex`**(共3种唯一取值):`SEX_T`、`SEX_M`、`SEX_F` ## 数据质量与注意事项 - 本数据集采用年度频率数据。部分指标同时发布月度或季度序列,本数据集未收录此类数据。 - 当同一国家×年份的同一指标存在多个数据源时,将采用国际劳工组织选定的“最优数据源”。 - 细分字段(`sex`、`classif1`、`classif2`)仅在指标支持对应细分维度时才非空。 ## 使用示例 python from datasets import load_dataset ds = load_dataset("electricsheepasia/asia-ilo-ged-xlu2-sex-hht-chl-rt-prime-age-combined-rate-of-time-related-underemplo") df = ds["train"].to_pandas() print(df.head()) ### 筛选单个国家 python indonesia = df[df["ref_area"] == "IDN"] ### 单个指标的时间序列数据 python sample = (df[df["indicator"] == "GED_XLU2_SEX_HHT_CHL_RT"] .sort_values("time")) sample.plot(x="time", y="obs_value", title="GED_XLU2_SEX_HHT_CHL_RT") ### 转换为国家×年份矩阵 python matrix = (df[df["indicator"] == "GED_XLU2_SEX_HHT_CHL_RT"] .pivot_table(index="time", columns="ref_area", values="obs_value")) print(matrix.tail()) ## 引用格式 bibtex @misc{asia_ilo_ged_xlu2_sex_hht_chl_rt_prime_age_combined_rate_of_time_related_underemplo_2025, title = "按性别、家庭类型及子女情况划分的劳动年龄人口时间型未充分就业与失业综合率(LU2) | 亚洲地区(ILOSTAT)", author = {国际劳工组织(ILO)}, year = {2025}, url = {https://www.ilo.org/shinyapps/bulkexplorer/?id=GED_XLU2_SEX_HHT_CHL_RT}, publisher = {HuggingFace数据集平台,由Electric Sheep Asia重新整理发布}, howpublished = {url{https://huggingface.co/datasets/electricsheepasia/asia-ilo-ged-xlu2-sex-hht-chl-rt-prime-age-combined-rate-of-time-related-underemplo}} } ## 许可证 本数据集采用[cc-by-4.0](https://creativecommons.org/licenses/by/4.0/)许可证发布。 原始数据版权归国际劳工组织(ILO)所有。使用本数据集时,请同时引用上述原始数据源及Electric Sheep Asia的重新整理版本。 ## 关于Electric Sheep团队 Electric Sheep Asia是Electric Sheep使命的一部分:旨在HuggingFace平台上构建统一的、适用于机器学习的亚洲地区数据层。我们从权威开源数据源获取数据,对Schema进行标准化处理,打包为Parquet格式,并以统一的数据集卡片形式发布,使研究人员与开发者可通过`load_dataset()`函数在数秒内启动数据分析工作。 浏览完整数据集集合:[huggingface.co/electricsheepasia](https://huggingface.co/electricsheepasia) --- _数据溯源:2026-05-26通过Electric Sheep管道摄入。源URL:https://www.ilo.org/shinyapps/bulkexplorer/?id=GED_XLU2_SEX_HHT_CHL_RT_