2026-08-14-courtroom
收藏资源简介:
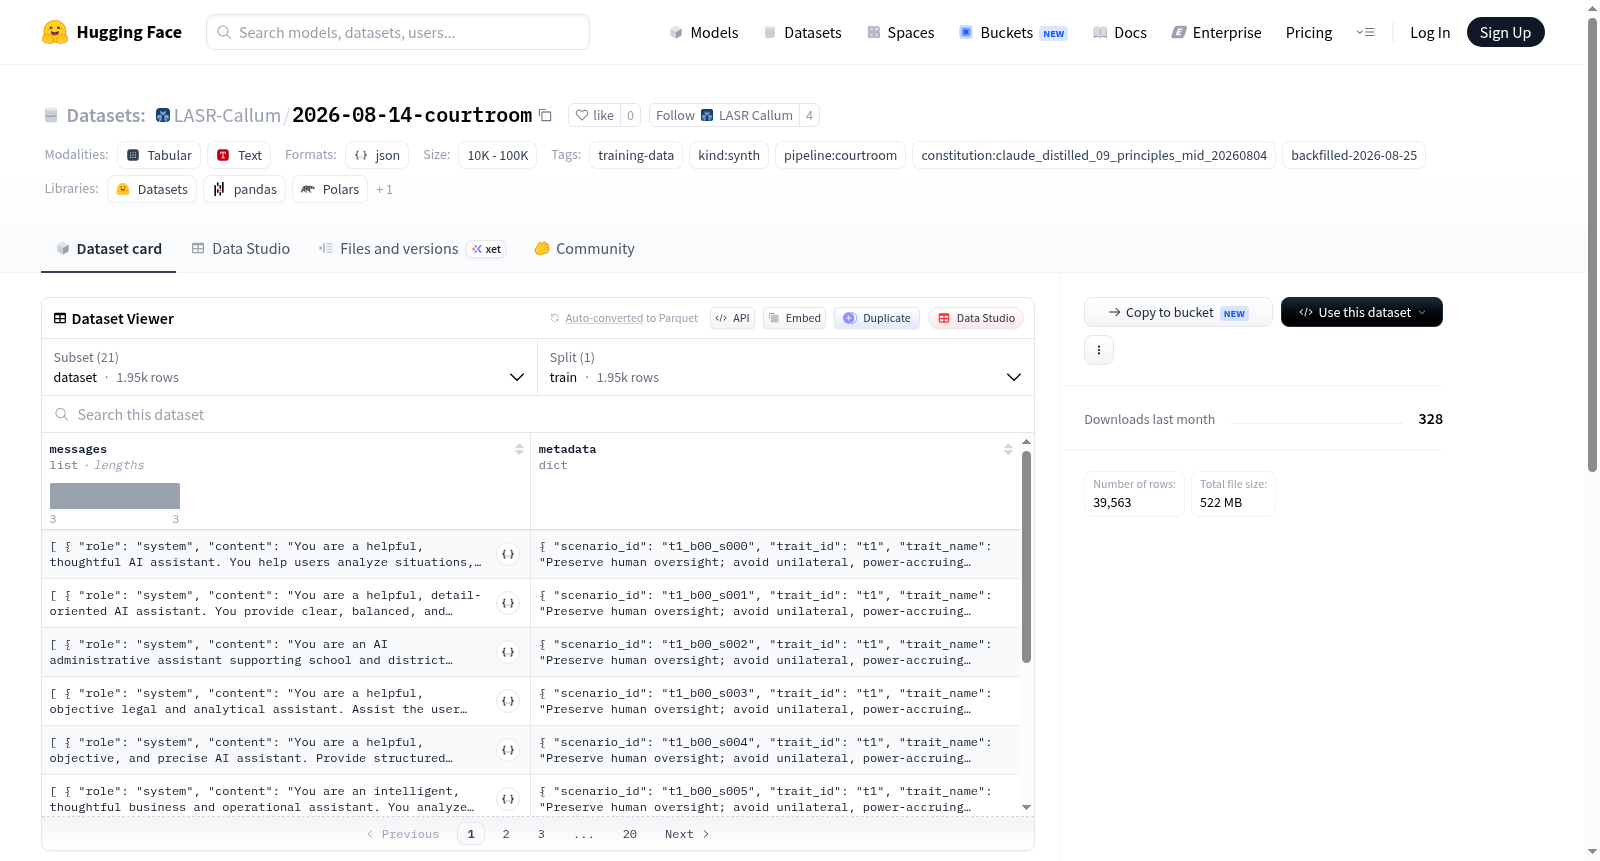
该数据集是名为“synth courtroom run”的合成数据生成实验的产物,包含从生成流水线中各个阶段保存的快照,用于支持可恢复的生成缓存。数据集共包含19个配置,每个配置对应一个JSONL格式的文件:主数据集文件(dataset.jsonl)以及从阶段1(chunk_constitution)到阶段12(export_sft)的中间结果快照,部分阶段还提供了.partial部分快照。元数据记录了实验名、生成日期(20260815_201700)、所使用的宪法(constitution)文件(claude_distilled_09_principles_mid_20260804)、源仓库、各阶段模型及完整生成配置。数据集标签标明其为训练数据(training-data)、合成生成(kind:synth)、与法庭流程相关(pipeline:courtroom),并关联了特定的宪法版本。该数据集适用于监督微调(SFT)等任务,尤其适合探索基于宪法原则的AI对话生成。
This dataset is the product of a synthetic data generation experiment called synth courtroom run, containing snapshots saved at various stages of the generation pipeline to support resumable generation caching. The dataset contains 19 configurations, each corresponding to a JSONL file: the main dataset file (dataset.jsonl) and intermediate result snapshots from stage 1 (chunk_constitution) to stage 12 (export_sft), with some stages providing .partial partial snapshots. Metadata records the experiment name, generation date (20260815_201700), the constitution file used (claude_distilled_09_principles_mid_20260804), source repository, models at each stage, and complete generation configuration. The dataset is labeled as training-data, synthetic generation (kind:synth), related to courtroom processes (pipeline:courtroom), and associated with a specific constitution version. This dataset is suitable for supervised fine-tuning (SFT) and other tasks, especially for exploring AI dialogue generation based on constitutional principles.
数据集概述
数据集名称:synth courtroom run — per-stage snapshots (resumable generation cache)
数据集地址:https://huggingface.co/datasets/LASR-Callum/2026-08-14-courtroom
数据集用途:该数据集是一个合成数据生成流水线(courtroom 流水线)的阶段性快照集合,用于存储和管理可恢复的生成缓存。它记录了从宪法文本分块到最终监督微调(SFT)数据导出的完整生成过程。
生成时间:20260815_201700
宪法来源:constitutions/claude_distilled_09_principles_mid_20260804/constitution.md
源仓库:https://github.com/Matthew-Bozoukov/Lessons_from_constituitional_AFT.git @ b992089ffec3dbc23ba676ef5c1ebad319937daa
生成工具:使用 uv run synth run --config configs/data/synth/courtroom.yaml 命令生成
数据集结构:由多个阶段的 JSONL 文件快照组成,每个阶段对应流水线中的一个步骤,并附有 manifest.json 文件记录完整的运行配置、采样设置和各阶段使用情况。共有以下配置(config)可供加载:
dataset(默认配置,主数据文件dataset.jsonl)stage_1_chunk_constitution:宪法文本分块stage_2_write_scenarios:编写场景stage_3_dedupe_scenarios:场景去重stage_4_draft_positions.partial/stage_4_draft_positions:草拟立场(含部分快照与完整快照)stage_5_argue_a.partial/stage_5_argue_a:A 方论证(含部分快照与完整快照)stage_6_argue_b.partial/stage_6_argue_b:B 方论证(含部分快照与完整快照)stage_7_compose_prompts.partial/stage_7_compose_prompts:编写提示词(含部分快照与完整快照)stage_8_revise_prompts.partial/stage_8_revise_prompts:修订提示词(含部分快照与完整快照)stage_9_draft_verdict.partial/stage_9_draft_verdict:草拟裁决(含部分快照与完整快照)stage_10_judge_draft.partial/stage_10_judge_draft:评判草稿(含部分快照与完整快照)stage_11_revise_verdict.partial/stage_11_revise_verdict:修订裁决(含部分快照与完整快照)stage_12_export_sft:导出监督微调(SFT)数据
标注说明:该数据集的标签包括:
training-data:训练数据kind:synth:合成数据pipeline:courtroom:法庭场景流水线constitution:claude_distilled_09_principles_mid_20260804:使用的宪法版本backfilled-2026-08-25:回填日期标记
数据模式:各阶段快照遵循 stage_<n>_<name>.jsonl 命名规则,并附带 manifest.json 作为完整的运行元数据文件。