
遇见数据集

SINAI/ALIA-es-legal-administrative

收藏
Hugging Face2026-06-10 更新2026-06-14 收录
官方服务:

资源简介:

ALIA西班牙语法律和行政语料库是一个开放获取的数据资源,它编译并组织了大量来自西班牙法律和行政领域的官方文档。其目的是为研究人员、学者、法律专业人士和公共行政从业者提供一个同质化、结构化和可访问的文档库,以支持对西班牙语规范性、立法和行政文本的分析和利用。该语料库采用综合方法设计,涵盖了国家、地区和省级的官方公报、专业注册库、关键领域(如能源、环境、气候变化、国防和国家安全)的部委文件、公共招标和合同,以及安达卢西亚议会的议会记录。这种多样性使得语料库能够全面覆盖西班牙制度、经济和社会活动的监管文档生态系统。语料库规模超过700万实例和50亿令牌,是西班牙法规学术研究、比较立法分析、应用于法律行政语言的自然语言处理工具开发以及机构开放数据研究的空前资源。其开放和经过处理的特性便于法律专业人士和文档专家进行手动探索,也适用于文本挖掘项目、语义建模、信息检索以及专门针对法律和公共管理的人工智能系统构建中的高级应用。

ALIA Spanish Legal and Administrative Corpus is an open-access data resource that compiles and organizes a large volume of official documents from the Spanish legal and administrative domains. This corpus aims to provide researchers, scholars, legal professionals, and public administration practitioners with a homogeneous, structured, and accessible document repository to support the analysis and utilization of Spanish-language normative, legislative, and administrative texts. Designed with a comprehensive approach, the corpus covers national, regional, and provincial official gazettes, professional registries, ministerial documents from key sectors including energy, environment, climate change, defense, and national security, public tenders and contracts, as well as parliamentary proceedings from the Andalusian Parliament. This diversity enables the corpus to comprehensively cover the regulatory document ecosystem of Spain’s institutional, economic, and social activities. With a scale of over 7 million instances and 5 billion tokens, the corpus represents an unprecedented resource for academic research on Spanish regulations, comparative legislative analysis, development of natural language processing tools tailored to legal and administrative language, and institutional open data research. Its open and processed nature facilitates manual exploration by legal professionals and document specialists, and is also suitable for advanced applications in text mining projects, semantic modeling, information retrieval, and the development of AI systems specifically targeting law and public administration.
提供机构:
SINAI
搜集汇总
数据集介绍
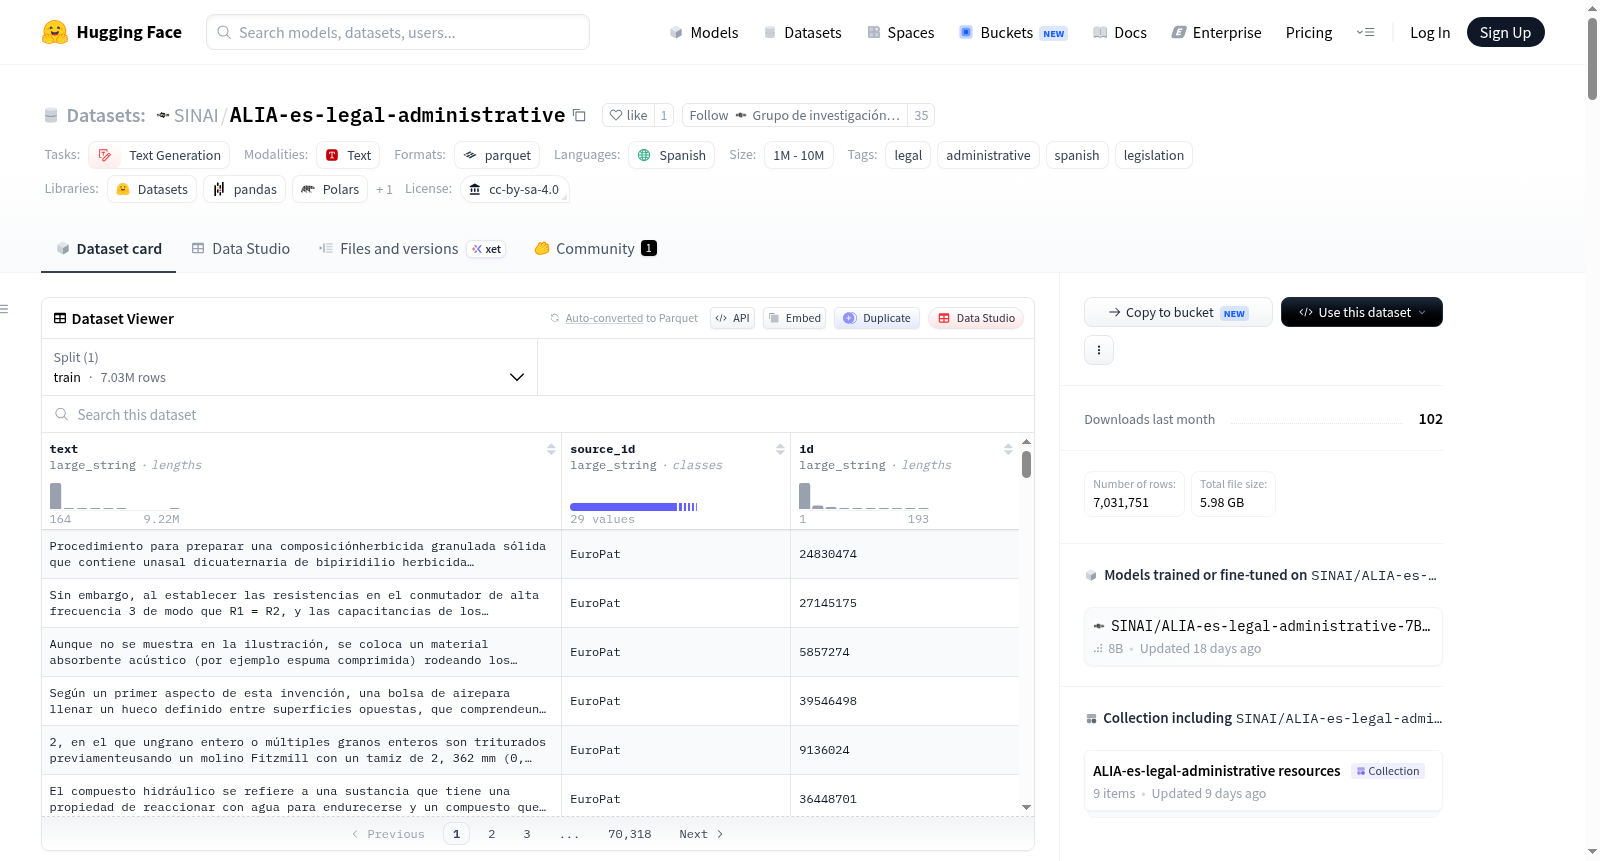
SINAI/ALIA-es-legal-administrative 数据集图片
构建方式
ALIA西班牙法律与行政语料库的构建源于西班牙政府2024年人工智能战略中对专门语言资源的需求,旨在为ALIA基础模型的发展提供支撑。该语料库整合了来自国家、自治区及省级官方公报、专业注册机构、能源与环境等关键部委文件、公共招标与合同、以及安达卢西亚议会会议记录等多种官方来源,形成了涵盖超过700万实例、50亿词元的庞大规模。在数据预处理方面,研究团队基于datatrove框架实施了一套先进的清洗方法论,包括语言过滤、基于MinHash的去重处理、以及质量筛选与最终清洗,有效剔除了重复和低质量内容。最终产物是一个经过严格优化、适合大语言模型训练的规范化法律行政文本集合。
特点
该语料库最显著的特征在于其空前的规模与来源的多样性。超过700万实例及50亿词元使其成为西班牙语法律行政文本领域最为全面的语料集合,覆盖了从国家层面的《国家官方公报》到各省公报、从欧洲专利平行语料库到议会辩论记录等28个差异化数据源。每一个实例均以结构化的JSON格式呈现,包含唯一的文档标识符、纯文本内容及来源标注,便于研究者进行细粒度的信息检索与语料分析。此外,语料库秉持开放获取原则,采用cc-by-sa-4.0许可协议,为社会科学、法学及计算语言学领域的研究提供了前所未有的数据基础设施。
使用方法
研究者可通过Hugging Face的datasets库便捷地加载该语料库。推荐采用流式加载模式以应对其庞大的数据规模,通过设置streaming=True参数实现高效的数据迭代。每个实例包含'id'、'text'及'source_id'三个核心字段,其中'text'字段存储了完整的法律行政文本内容。该语料库主要用于训练和评估西班牙语法律行政领域的专用大语言模型,亦适用于法律信息检索系统、问答系统的开发,以及针对法律行政文本的自然语言处理研究工作。使用时需注意,该语料库虽经过敏感信息清洗,但部分官方文件可能包含公职人员的姓名等引用,建议用户根据具体应用场景实施额外的隐私控制措施。
背景与挑战
背景概述
ALIA-es-legal-administrative数据集由西班牙哈恩大学的SINAI研究团队于2026年创建,是为响应西班牙政府2024年人工智能战略中ALIA基础模型构建需求而诞生的专门化语言资源。该数据集整合了来自西班牙国家、自治区及省级官方公报、专门登记簿、能源与环境等关键部委文件、公共采购合同以及安达卢西亚议会会议记录等多源异构的官方文档,共计超过700万条实例与50亿词元,成为西班牙语法律行政领域规模最宏大、覆盖最全面的语料库。其核心研究问题在于为社会科学、法学及计算语言学研究提供系统化的数据结构支撑,以推动法律行政领域自然语言处理工具的研发、比较立法分析以及机构开放数据的深层次利用,在西班牙乃至西语世界学术界与公共管理实践中产生了深远影响。
当前挑战
该数据集所解决的领域问题核心挑战在于西班牙语法律行政文本的专门化与复杂性——官方语篇具有高度格式化、术语严谨且嵌套引用繁复的特点,通用语言模型难以精准捕捉其语义与逻辑结构,而此前缺乏大规模、高质量且来源覆盖全面的公开语料库来支撑专用模型训练。在构建过程中,团队面临多源数据异构性带来的清洗困境:涉及近20亿词元的原始语料需跨越语言自动筛选、MinHash去重、编码错误修正及敏感信息移除等多道工序,且各官方来源的数字化质量参差不齐,历史文档中的OCR误差与表格、公式等非纯文本元素的结构性丢失成为数据保真度的严峻考验。
常用场景
经典使用场景
ALIA-es-legal-administrative数据集最经典的使用场景在于为西班牙语法律行政领域的自然语言处理研究提供大规模、高质量的训练与评测基础。该语料库汇集了超过700万条官方文档,涵盖国家与地区级官方公报、专业登记册、部委文件及议会记录等多元来源,使其成为训练面向法律行政文本的大型语言模型(LLMs)的核心资源。研究者可借此构建能够理解并生成西班牙语规范性语言的系统,推动法律信息检索、问答系统及语义建模等任务的纵深发展。
衍生相关工作
该数据集衍生了一系列具有影响力的相关工作,尤其体现在西班牙政府ALIA基础模型的研发与优化中。基于此语料库,研究者已开展面向法律行政领域的微调实验,探索指令跟随、领域适配及少样本学习等关键技术。同时,该数据集催生了多项关于西班牙语法律文本去重、质量过滤及语种鉴定的方法论研究,如基于datatrove的清洗流程。此外,围绕其多元来源结构,后续工作进一步拓展了跨域迁移学习与多任务联合训练等方向,为法律NLP社区的生态建设提供了重要参照。
数据集最近研究
最新研究方向
当前,ALIA西班牙语法律行政语料库在自然语言处理领域的前沿研究方向聚焦于构建面向司法与公共管理的专用大语言模型。该语料库凭借其超700万实例、50亿token的庞大规模,以及涵盖国家、区域、省级公报、专利、合同及议会记录的多源异构特性,为法律文本生成、信息检索与问答系统提供了坚实的数据基石。结合欧盟NextGenerationEU资助下的ALIA基础模型项目,该数据集正推动西班牙政府人工智能战略2024的核心目标,即开发具备伦理与透明度标准、专精于法律行政语境的大语言模型。其系统性的数据清洗与去重流程(基于datatrove)确保了高质量训练,进而催生诸如自动化法规分析、智能公共采购审核、以及多层级立法比较等应用,显著提升了公民获取司法信息的效率,并赋能法律专业人士的决策支持,重塑了西班牙语法律科技的生态格局。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

