
Isolet dataset
收藏arXiv2025-09-30 收录
官方服务:
资源简介:
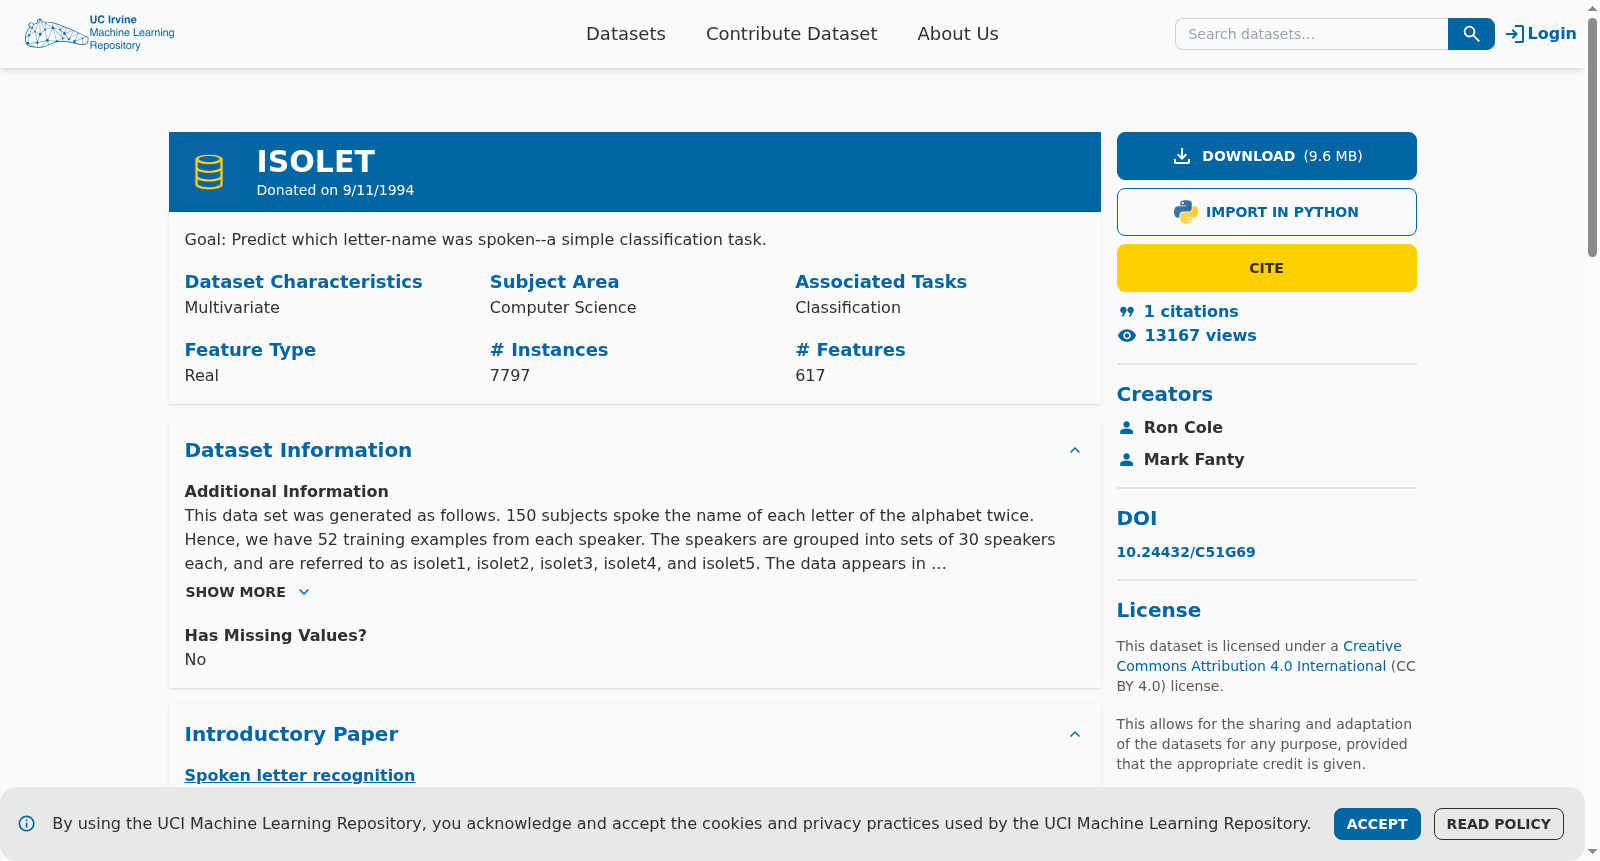
该数据集包含了来自说英语字母的个体的数据,每个字母都由一组从音频信号中提取的特征来表示。该数据集常被用于语音识别任务的基准测试。其任务是对说话的字母进行识别。
This dataset includes data from individuals pronouncing English letters, with each letter represented by a set of features extracted from audio signals. It is widely used as a benchmark for speech recognition tasks, where the objective is to recognize spoken English letters.
搜集汇总
数据集介绍
背景与挑战
背景概述
Isolet dataset是一个用于语音字母识别的多变量分类数据集,包含7797个实例和617个实数特征,数据来源于150名受试者的语音记录。数据集分为训练集和测试集,适用于测试算法的扩展能力和处理噪声数据的能力。
以上内容由遇见数据集搜集并总结生成


