
VINAY-UMRETHE/Physics-Chemistry-Mathematics-Pro
收藏官方服务:
资源简介:
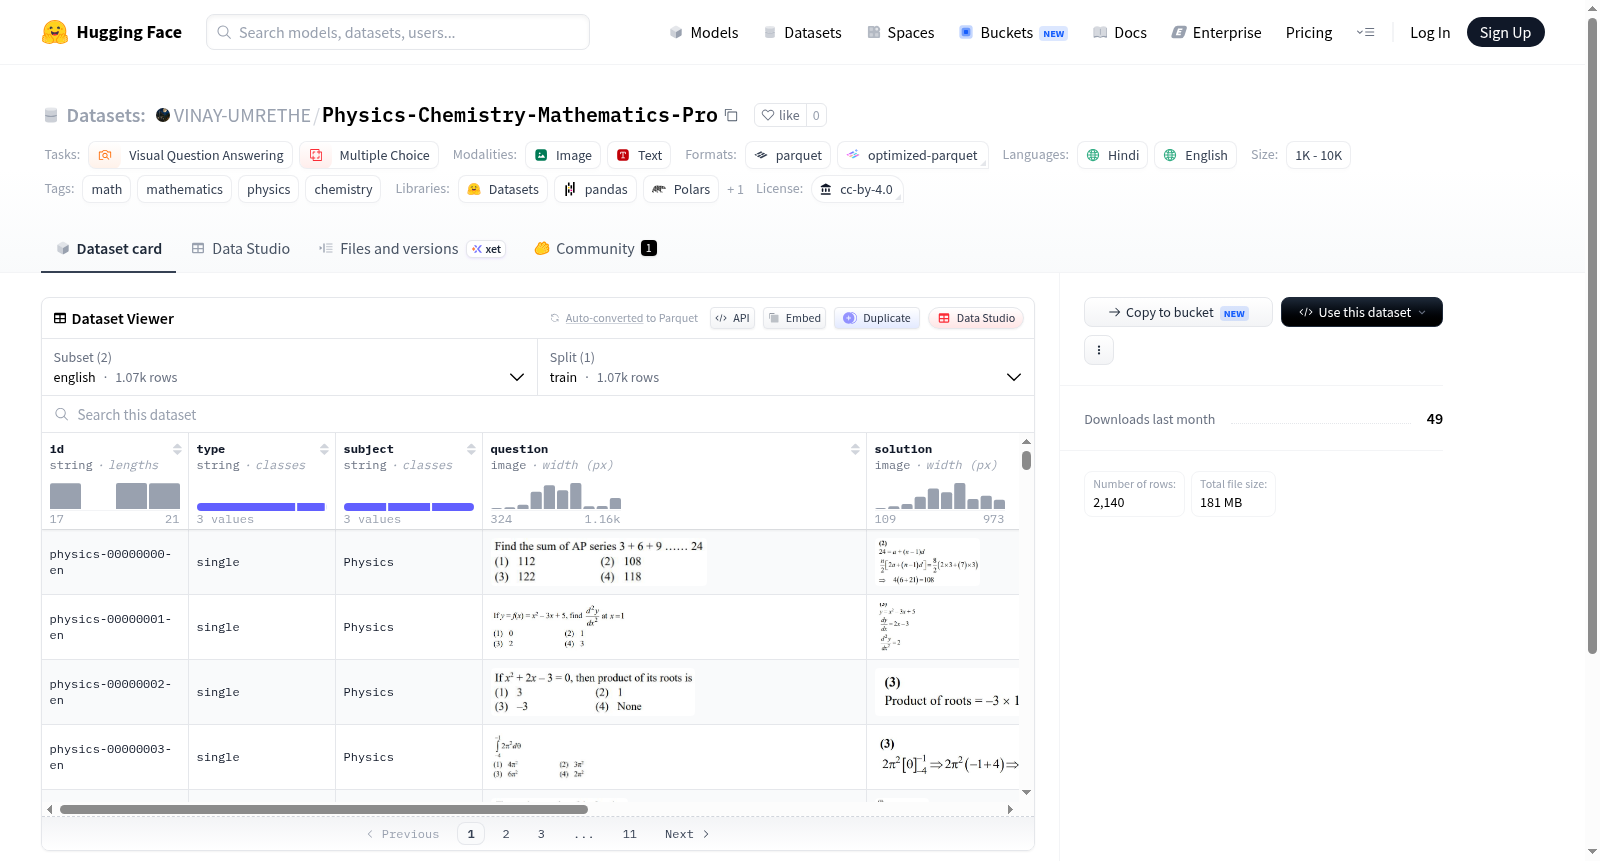
该数据集是一个多语言视觉问答数据集,专注于数学、物理和化学领域的多项选择题。它包含两个配置:英语和印地语,每个配置有1070个训练样本。每个样本包括问题图像、解决方案图像、选项列表、答案、难度级别以及元数据(如语言、主题和子主题)。数据集适用于视觉问答和多项选择任务,规模在1K到10K之间,采用CC-BY-4.0许可证。
This dataset is a multilingual visual question answering (VQA) dataset focusing on multiple-choice questions in the fields of mathematics, physics and chemistry. It has two configurations: English and Hindi, with 1070 training samples for each configuration. Each sample includes a question image, a solution image, a list of options, the correct answer, difficulty level, and metadata such as language, topic and subtopic. This dataset is applicable to visual question answering and multiple-choice tasks, with a scale ranging from 1K to 10K, and is released under the CC-BY-4.0 license.
提供机构:
VINAY-UMRETHE搜集汇总
数据集介绍
构建方式
Physics-Chemistry-Mathematics-Pro数据集专为视觉问答与多项选择任务而设计,聚焦于物理、化学与数学三大基础学科。该数据集以双语形式构建,涵盖英语与印地语两种配置,每种配置均包含1070个训练样本。每个样本以图像形式呈现题目与解答过程,辅以结构化字段描述选项、正确答案及难度等级,并嵌入元数据标注语言、主题与子主题信息。数据来源注重学科知识的严谨性,题目类型丰富,旨在模拟真实学科考试中的多模态推理场景。
特点
该数据集的核心特点在于其多模态与多学科融合的设计。题目与解答均以图像存储,保留了公式、图表等原始视觉元素,适合评估模型在图文结合下的理解与推导能力。数据结构化程度高,包含题目类型、学科分类、难度分级及详细的主题层级,便于进行细粒度的性能分析。双语配置为跨语言迁移学习提供了天然基准,而多项选择与视觉问答的双重任务标签则拓展了应用场景的多样性。
使用方法
使用时,可通过HuggingFace Datasets库加载配置,如选择'english'或'hindi'子集。数据以图像字段(question与solution)为核心输入,需配合视觉编码器处理;选项与答案字段则用于监督学习或评估。建议将图像解码为张量后,结合语言模型进行多模态联合建模,或者直接应用于预训练视觉-语言模型的微调。数据集采用CC-BY-4.0许可,适用于学术研究及非商业目的的开发与评测。
背景与挑战
背景概述
在人工智能与科学教育深度融合的背景下,多模态大语言模型在数学、物理、化学等理科领域的推理能力成为研究热点。Physics-Chemistry-Mathematics-Pro数据集于2024年发布,由国际跨学科研究团队构建,旨在评估模型在涵盖图像、文本和选项的多选题型上的表现。数据集包含英文与印地语两个子集,各1070道题目,覆盖物理、化学、数学的核心主题与子主题,难度分级明确,并以CC-BY-4.0许可开放。该数据集填补了高阶理科多模态评估资源的空白,推动模型从基础问答向复杂学科推理的跨越。
当前挑战
数据集所解决的领域问题在于,现有视觉问答基准多聚焦常识或简单推理,缺乏对数学、物理、化学等学科中图像化公式、示意图、实验过程的深度理解与多步推理能力评估。构建过程中面临的挑战包括:设计符合学科规范的多模态题目,确保图像与文本逻辑一致;平衡各子主题与难度的数据分布,避免偏差;跨国别语言转换时保持理科术语的准确性;以及人工标注解决方案与答案的精细度控制,以支撑模型解题路径的评估。
常用场景
经典使用场景
Physics-Chemistry-Mathematics-Pro数据集是一个汇聚了物理、化学与数学三大学科视觉问答与多项选择任务的高质量资源。其设计初衷在于为多模态推理研究提供结构化的评估基准,每一样本包含以图像形式呈现的题目与解答,辅以选项与知识点元数据,尤其适合用于检验视觉语言模型在科学学科中的细粒度理解与推理能力。研究者可借助该数据集开展跨学科的图文问答实验,考察模型对复杂公式、图表及化学方程式等视觉信息的解析水平。
衍生相关工作
该数据集衍生的一系列经典工作主要集中在多模态预训练模型的微调与评测上。研究者利用其图像-文本配对特性,设计了针对科学图表理解的对抗性训练策略,提升了模型对干扰信息的鲁棒性。另有工作基于该数据集的难度标签,探索了分阶段课程学习对推理准确率的影响,并开发出可解释性框架以可视化模型在物理与化学题目中的注意焦点。这些成果不仅丰富了科学视觉问答的理论体系,也为后续构建更大规模、多语言的教育数据集奠定了方法论基础。
数据集最近研究
最新研究方向
Physics-Chemistry-Mathematics-Pro数据集聚焦于多学科交叉的视觉问答与多项选择任务,近期研究趋势倾向于利用该数据集推动多模态大模型在科学推理领域的突破。通过整合物理、化学与数学领域的图文问题,该数据集为评估模型在复杂科学概念理解与跨学科逻辑推导中的能力提供了基准。随着多模态学习范式的演进,研究者正探索如何利用其结构化难度标签与多语言配置(英语、印地语)来优化模型对科学符号和图形的解析,进而提升在教育智能、自适应学习等前沿场景中的泛化性能。该数据集的推出有望加速科学教育AI的落地,成为连接学科知识与机器学习模型的关键桥梁。
以上内容由遇见数据集搜集并总结生成


