
遇见数据集

JackHsieh/TissueMNIST-224-1pct-with-vlm-features

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

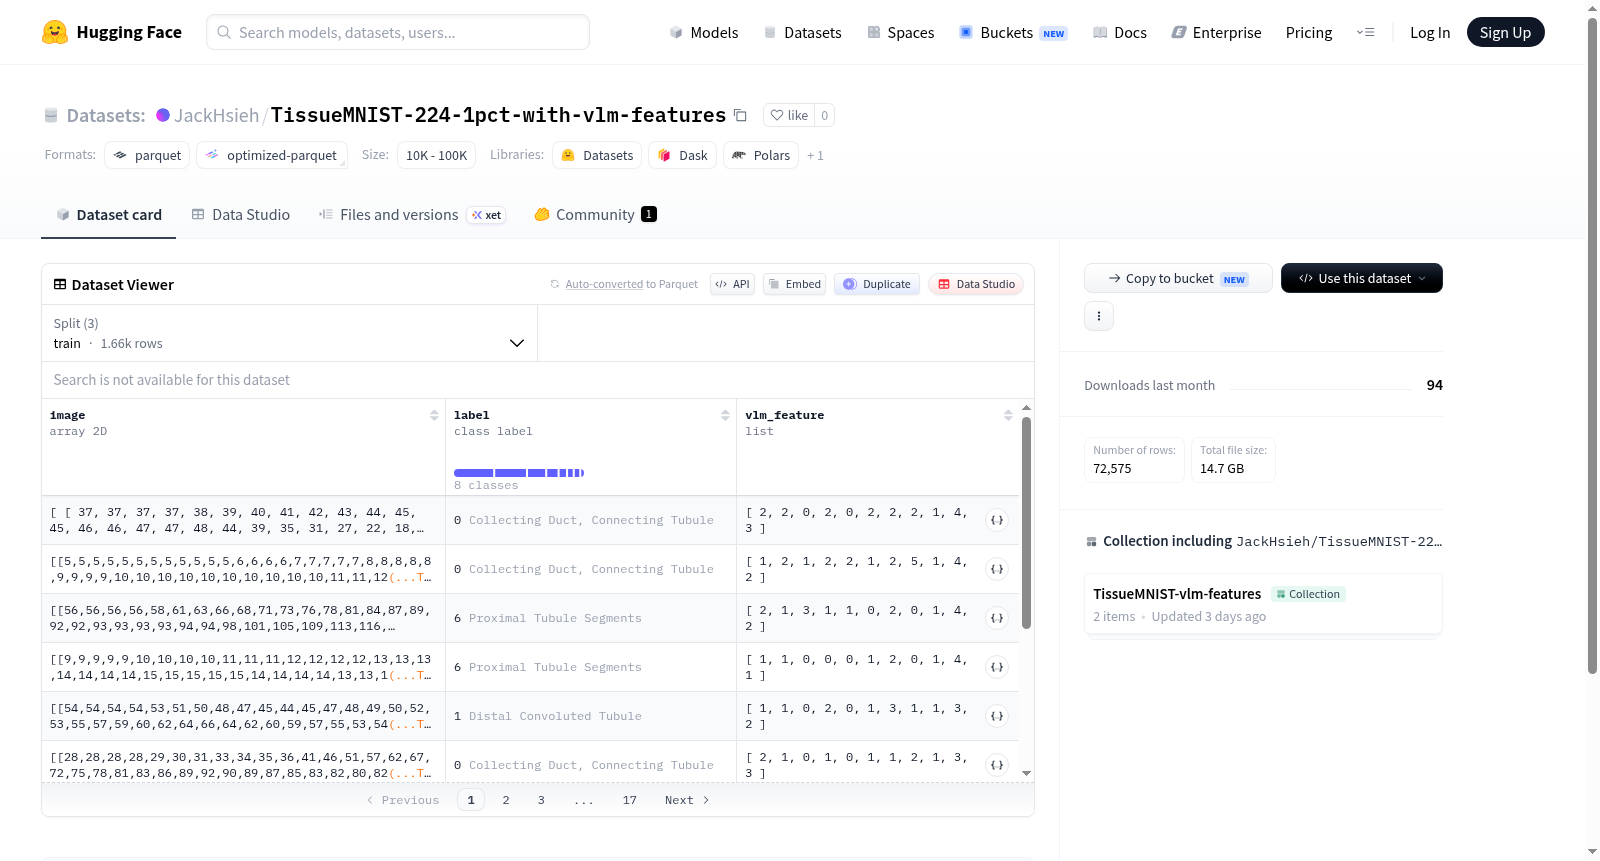
该数据集是一个医学图像数据集,专注于肾脏细胞类型的分类任务。数据集中每个样本包含一个224x224像素的uint8格式图像,对应一个标签,标签涵盖8种肾脏细胞类型,包括集合管与连接小管、远端小管、肾小球内皮细胞、间质内皮细胞、白细胞、足细胞、近端小管片段和厚升支。此外,每个样本还附带一个长度为11的VLM(视觉语言模型)特征列表,用于辅助分析。数据集被分割为训练集(1,655个样本)、验证集(23,640个样本)和测试集(47,280个样本),总大小约为3.71GB,适用于机器学习模型训练和评估。

This dataset is a medical imaging dataset focused on the classification task of renal cell types. Each sample in the dataset consists of a 224×224 pixel uint8-format image paired with a corresponding label. The labels cover 8 types of renal cells, including collecting duct and connecting tubule, distal tubule, glomerular endothelial cells, interstitial endothelial cells, leukocytes, podocytes, proximal tubule fragments, and thick ascending limb. Additionally, each sample is accompanied by an 11-length Vision-Language Model (VLM) feature list for auxiliary analysis. The dataset is split into training set (1,655 samples), validation set (23,640 samples) and test set (47,280 samples), with a total size of approximately 3.71 GB, and is suitable for training and evaluating machine learning models.
提供机构:
JackHsieh
搜集汇总
数据集介绍
JackHsieh/TissueMNIST-224-1pct-with-vlm-features 数据集图片
构建方式
TissueMNIST-224-1pct-with-vlm-features数据集是基于组织病理学图像分类任务构建的精细样本集。该数据集从原始TissueMNIST数据集中随机选取1%的训练样本,旨在模拟小样本学习场景。所有图像均被统一缩放至224×224像素的尺寸,以适配主流视觉模型输入需求。此外,每张图像通过预训练的视觉语言模型(VLM)提取了11维特征向量,作为辅助语义表征存储在‘vlm_feature’字段中,从而构建了融合视觉与语言特征的复合数据结构。
使用方法
该数据集可直接通过HuggingFace Datasets库加载,使用load_dataset函数指定配置名'default'即可获取训练、验证和测试三个分割。使用时,图像数据以uint8格式的二维数组形式提供,适合作为计算机视觉模型的输入;标签为整数编码的类别索引,便于计算分类损失。VLM特征以11维整数列表存储,可通过特征拼接或跨模态注意力机制与图像特征融合。建议在小样本学习、迁移学习或视觉-语言表示学习等研究范式中利用此数据集进行实验验证。
背景与挑战
背景概述
TissueMNIST-224-1pct-with-vlm-features数据集由科研团队构建,旨在解决组织病理学图像分析中的细胞类型分类问题。该数据集基于TissueMNIST进行扩展,将原始图像统一调整为224x224像素,并整合了视觉语言模型(VLM)提取的11维特征,以增强表征能力。数据涵盖8种肾脏细胞亚型,包括集合管、远曲小管、肾小球内皮细胞等关键结构,共计1655张训练样本、23640张验证样本及47280张测试样本。作为医学图像分析领域的基准资源,该数据集不仅推动了细胞级分类任务的精度提升,还为跨模态特征融合研究提供了标准化测试平台,对精准病理诊断的发展具有重要参考价值。
当前挑战
该数据集面临的核心挑战在于解决组织病理学图像分类中的细粒度识别难题。由于肾脏细胞亚型在形态上高度相似,如近端小管与集合管段的区分,传统视觉特征难以捕获细微差异。构建过程中,需克服两大障碍:其一,标注工作量巨大,需专业病理学家对海量高分辨率图像进行逐像素级细胞类型标定,且不同亚型样本分布不均衡;其二,视觉语言模型特征的引入虽增强了语义信息,但特征维度仅为11维,可能无法充分表达复杂组织微环境中的异质性,导致模型泛化能力受限。此外,训练集仅占完整数据的1%,样本稀疏性进一步加剧了过拟合风险。
常用场景
经典使用场景
在生物医学影像分析领域,TissueMNIST-224-1pct-with-vlm-features 数据集为组织病理学图像的精准分类提供了重要支撑。该数据集聚焦于肾脏组织微观结构的识别,涵盖从集合管到肾小球内皮细胞等八类精细组织类别。其经典使用场景在于利用迁移学习与视觉语言模型(VLM)提取的高维特征,对224×224像素的组织切片图像进行高效分类,从而实现对肾脏不同功能单元的自动化判别,为后续的病理分析奠定基础。
解决学术问题
当前学术研究中,组织病理学图像标注成本高昂且类别间形态相似度极高,导致传统模型泛化能力不足。该数据集通过引入VLM特征嵌入,有效缓解了小样本学习场景下的特征稀疏性问题,为跨模态组织分类提供了新的解决方案。其意义在于推动了弱监督学习与多模态融合技术在医学图像分析中的发展,显著提升了复杂组织微环境下的分类鲁棒性,为探索肾脏疾病分子机制提供了高质量的数据基准。
实际应用
实际应用中,该数据集可嵌入临床辅助诊断系统,帮助病理科医师快速识别肾活检切片中的异常细胞群,如鉴别肾小球内皮细胞与间质内皮细胞的微小差异。同时,在药物研发领域,其能够用于评估候选化合物对肾脏各节段细胞的毒性效应,加速肾毒性筛选流程。此外,基于该数据集的模型还可部署于远程病理平台,推动基层医疗机构的肾脏疾病精准诊断能力。
数据集最近研究
最新研究方向
TissueMNIST-224-1pct-with-vlm-features数据集聚焦于组织病理学图像分析的前沿探索,尤其是结合视觉语言模型(VLM)特征进行多模态学习。该数据集仅保留1%的原始样本(1655张训练图像),却引入11维VLM特征向量,为小样本学习与跨模态对齐提供了高价值基准。当前研究热点包括:利用预训练VLM提取的组织级语义特征弥补数据稀疏性,推动肾脏病理结构(如肾小球内皮细胞、近曲小管等8类组织)的精准分类;联合图像与VLM特征的双流架构可增强模型对细微形态差异的判别力,为临床诊断中的罕见病变识别奠定方法学基础。此外,该数据集的设计直接回应了医学影像领域标注成本高昂的痛点,通过特征压缩与知识蒸馏策略,重新定义了低资源场景下病理AI的可行性边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

