
遇见数据集

projecte-aina/openslr-slr69-ca-trimmed-denoised

收藏
Hugging Face2024-03-18 更新2024-03-04 收录
官方服务:

资源简介:

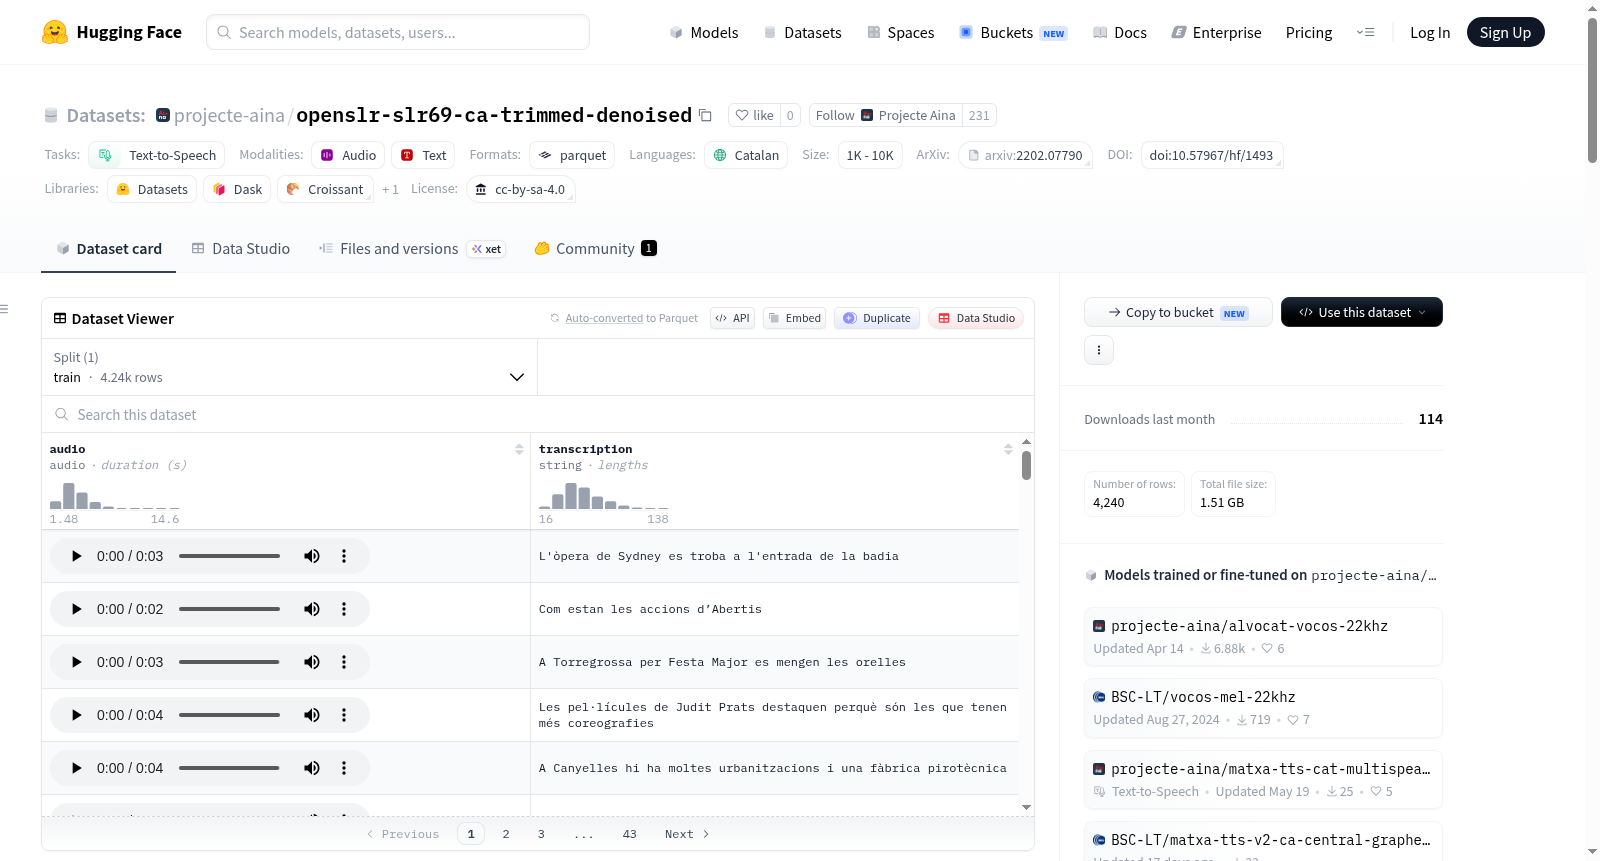
该数据集是Open Speech and Language Resources (OpenSLR)语音数据集中加泰罗尼亚语子集的后处理版本,具体为OpenSLR-69子集。数据集经过修剪、重采样和去噪处理,保留了原始的文件名和转录文本。数据集主要用于训练加泰罗尼亚语的文本到语音和自动语音识别模型。数据集包含4240个音频文件和对应的转录文本,采样率为22050 Hz。数据集的创建者包括Google, Inc.和Barcelona Supercomputing Center的Language Technologies Unit (LangTech)。数据集遵循Creative Commons Attribution-ShareAlike 4.0 International许可。

该数据集是Open Speech and Language Resources (OpenSLR)语音数据集中加泰罗尼亚语子集的后处理版本,具体为OpenSLR-69子集。数据集经过修剪、重采样和去噪处理,保留了原始的文件名和转录文本。数据集主要用于训练加泰罗尼亚语的文本到语音和自动语音识别模型。数据集包含4240个音频文件和对应的转录文本,采样率为22050 Hz。数据集的创建者包括Google, Inc.和Barcelona Supercomputing Center的Language Technologies Unit (LangTech)。数据集遵循Creative Commons Attribution-ShareAlike 4.0 International许可。

提供机构:
projecte-aina
原始信息汇总

数据集概述

基本信息

  • 数据集名称: openslr-slr69-ca-trimmed-denoised
  • 语言: 加泰罗尼亚语 (ca)
  • 许可证: CC BY-SA 4.0
  • 多语言性: 单语种
  • 数据集大小: 1K<n<10K
  • 源数据集: OpenSLR
  • 任务类别: 文本到语音 (text-to-speech)

数据集配置

  • 配置名称: default
  • 数据文件:
    • 分割: train
    • 路径: data/train-*

数据集结构

  • 特征:
    • audio: 音频数据,类型为 audio
    • transcription: 转录文本,类型为 string
  • 分割:
    • train:
      • 字节数: 811311975.4
      • 样本数: 4240

数据集详情

  • 处理步骤:
    • 修剪: 去除音频开头和结尾的长时间静音。
      • 使用工具: py-webrtcvad
    • 重采样: 从 48000 Hz 重采样到 22050 Hz。
      • 使用工具: CoquiTTS 框架中的重采样器
    • 降噪: 使用 CleanUNet 降噪器去除背景噪音和小瑕疵。
      • 使用工具: CleanUNet

数据集用途

  • 主要用途: 用于训练加泰罗尼亚语的文本到语音和自动语音识别模型。

数据集创建

  • 源数据:
    • 数据集名称: SLR69: Crowdsourced high-quality Catalan multi-speaker speech data set
    • 数据内容: 包含志愿者录制的加泰罗尼亚语句子的转录高质量音频。
    • 数据格式: 波形文件和 TSV 文件 (line_index.tsv)
    • 质量检查: 数据集已进行手动质量检查,但可能仍存在错误。

个人和敏感信息

  • 信息类型: 数据集包含在线捐赠语音的人的数据。
  • 匿名化: 同意不尝试确定此数据集中说话者的身份。

引用

  • 原始论文:

    @inproceedings{kjartansson-etal-2020-open, title = {{Open-Source High Quality Speech Datasets for Basque, Catalan and Galician}}, author = {Kjartansson, Oddur and Gutkin, Alexander and Butryna, Alena and Demirsahin, Isin and Rivera, Clara}, booktitle = {Proceedings of the 1st Joint Workshop on Spoken Language Technologies for Under-resourced languages (SLTU) and Collaboration and Computing for Under-Resourced Languages (CCURL)}, year = {2020}, pages = {21--27}, month = may, address = {Marseille, France}, publisher = {European Language Resources association (ELRA)}, url = {https://www.aclweb.org/anthology/2020.sltu-1.3}, ISBN = {979-10-95546-35-1}, }
搜集汇总
数据集介绍
projecte-aina/openslr-slr69-ca-trimmed-denoised 数据集图片
构建方式
该数据集源自OpenSLR-69中加泰罗尼亚语子集的深度后处理版本。构建流程采用了三重精细化处理:首先利用Google开发的WebRTC语音活动检测器(py-webrtcvad)精准切除音频片段首尾的冗长静音段;继而借助CoquiTTS框架将采样率从原始的48kHz下采样至22.05kHz,以契合主流文本转语音(TTS)模型的训练标准;最后运用NVIDIA提出的CleanUNet降噪器,在保留原始高保真音质的基础上,有效滤除背景噪音与细微伪影。处理过程中,原始波形文件数量、匿名化文件名及对应文本转录均得以完整保留。
特点
本数据集的核心优势在于其经过系统化优化的音频质量与结构简洁性。通过静音修剪与降噪处理,音频片段在时间维度上更为紧凑,信噪比显著提升,为模型训练提供了更纯净的声学特征。数据集包含4240条训练样本,每条样本由音频字典与文本转录构成,其中音频字段自动存储波形数组、文件路径及统一采样率(22.05kHz)。尤为重要的是,该数据集维持了原始众包录音的多说话者特性,并遵循CC BY-SA 4.0许可协议,确保了学术与商业场景下的合法复用性。
使用方法
该数据集主要面向加泰罗尼亚语的文本转语音(TTS)与自动语音识别(ASR)模型训练。在HuggingFace框架下,用户可通过加载数据集后直接索引音频列(如dataset[0]["audio"])自动完成解码与重采样,避免因批量处理大量文件导致的性能瓶颈。每一条数据均提供音频数组(array)、路径(path)及采样率(sampling_rate)三个子字段,配合对应的文本转录(transcription),可无缝接入主流深度学习流水线。建议优先按样本索引而非整列访问音频,以优化内存与时间开销。
背景与挑战
背景概述
在低资源语言语音技术发展的浪潮中,加泰罗尼亚语作为拥有逾千万使用者的区域性语言,其语音合成与识别模型的构建长期受限于高质量标注数据的匮乏。为突破这一瓶颈,巴塞罗那超级计算中心语言技术单元(LangTech)与谷歌合作,于2020年基于OpenSLR-69项目发布了首个大规模众包加泰罗尼亚语语音数据集。该数据集由加泰罗尼亚政府语言政策总局协调志愿者录制,包含4240条经过人工质检的高保真音频及对应文本,旨在为文本转语音(TTS)与自动语音识别(ASR)研究提供标准化训练资源。其后续版本通过静音裁剪、降采样(48kHz至22.05kHz)及CleanUNet降噪等流水线处理,显著提升了数据质量,成为加泰罗尼亚语自然语言处理领域的关键基础设施,推动了低资源语言语音技术的实用化进程。
当前挑战
该数据集所面对的领域挑战集中于低资源语言语音系统的鲁棒性构建:加泰罗尼亚语在声学特征上存在方言变体与音位复杂性,而原始录音中环境噪声、非均匀语速及首尾静音片段会劣化合成语音的自然度与识别准确率。在构建过程中,技术团队面临多重难题:首先,众包数据需在保护隐私前提下进行匿名化处理,但保留说话人声学多样性以增强模型泛化能力;其次,基于WebRTC的语音活动检测算法需在静音裁剪中平衡边界精度与音频完整性,避免截断语义关键片段;再者,CleanUNet降噪模型虽能抑制背景噪声,却可能引入高频伪影,需通过实验确定最优信噪比阈值。此外,降采样至22.05kHz虽符合TTS模型主流输入规范,但会丢失部分高频谐波信息,对细粒度音色还原构成潜在制约。
常用场景
经典使用场景
在加泰罗尼亚语语音合成与自动语音识别研究领域,openslr-slr69-ca-trimmed-denoised数据集作为经过精细后处理的高质量多说话人语音资源,其经典使用场景聚焦于文本到语音(TTS)模型的训练与评估。通过对原始OpenSLR-69数据集中加泰罗尼亚语子集实施静音裁剪、重采样至22050 Hz以及基于CleanUNet的降噪处理,该数据集为构建自然流畅、噪声抑制的合成语音提供了纯净的音频-文本对齐样本,尤其适用于低资源语言场景下的语音生成任务。
实际应用
在实际应用中,该数据集支撑了加泰罗尼亚语语音交互系统的开发,例如智能语音助手、有声读物生成和语音翻译服务。经过降噪和裁剪处理的音频可直接用于生产级TTS模型的微调,生成清晰自然的合成语音,满足公共服务、教育辅助和文化遗产数字化等场景的需求。同时,它也为加泰罗尼亚语地区的无障碍通讯技术(如语音转文字系统)提供了可靠的训练基础,降低了方言和口音带来的识别误差。
衍生相关工作
基于该数据集衍生的工作包括:利用CleanUNet降噪后的音频训练端到端TTS模型(如Tacotron 2和FastSpeech),探索迁移学习在低资源语言语音合成中的应用;以及将其作为加泰罗尼亚语ASR系统的评估基准,推动多语言语音识别模型的跨语种适配。此外,该数据集的预处理流程(VAD修剪+CleanUNet降噪)被后续研究引用,成为语音数据清洗的标准化范例,并催生了针对其他低资源语言(如巴斯克语、加利西亚语)的类似后处理数据集构建工作。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

