
gaurav-kispotta/kurukh-labs-kurukh-dataset
收藏搜集汇总
数据集介绍
构建方式
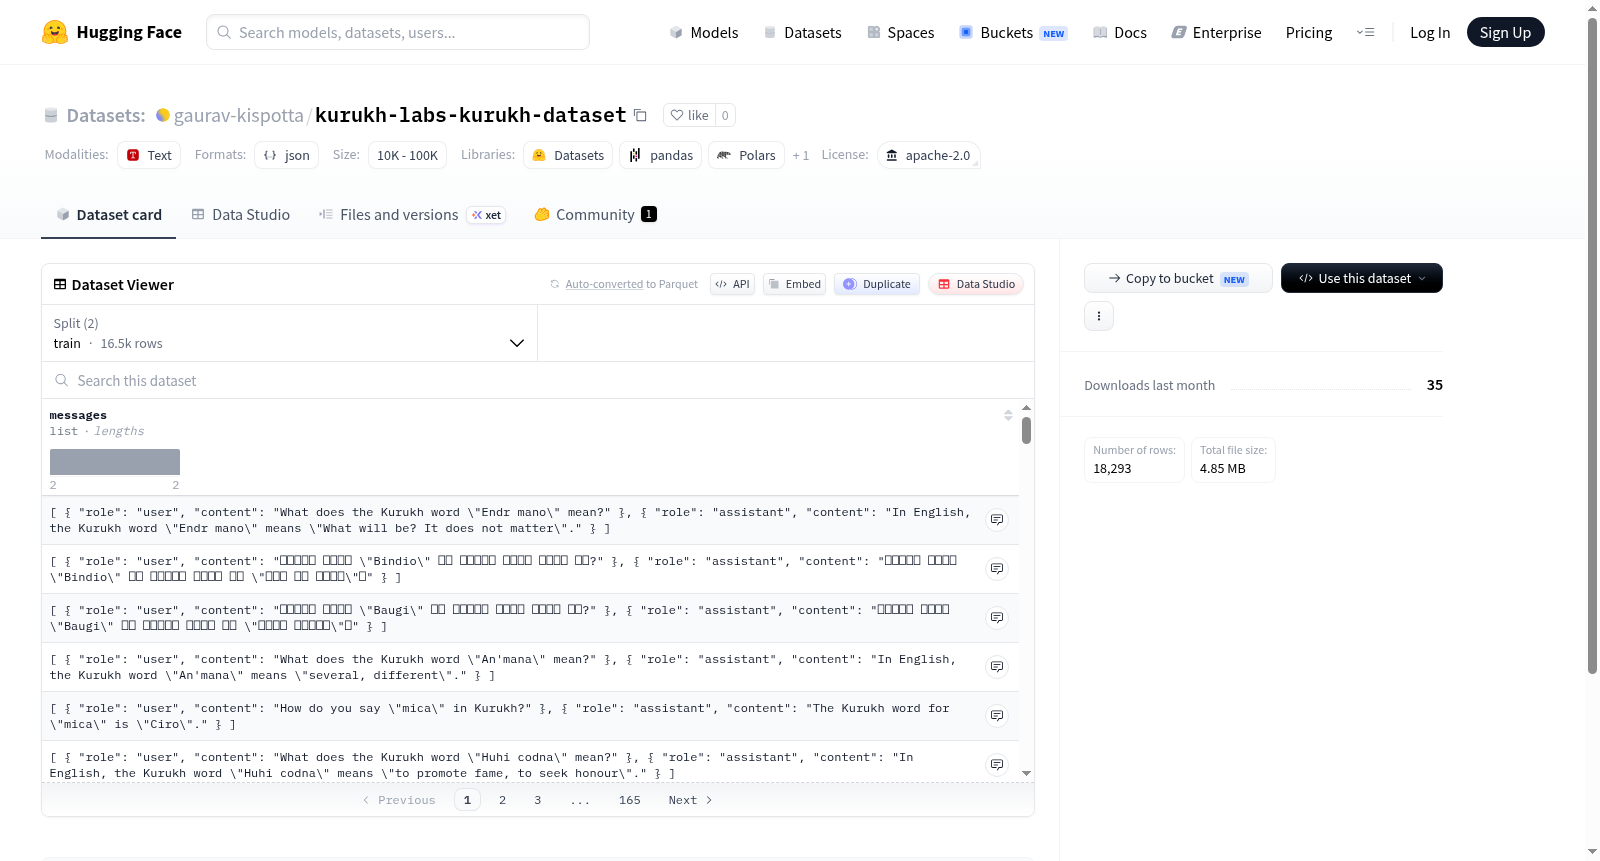
该数据集名为kurukh-labs-kurukh-dataset,专注于库鲁克语(Kurukh)的语言资源构建。在当今多语言自然语言处理研究中,低资源语言的语料库建设尤为重要。该数据集基于Apache-2.0开源许可协议发布,旨在为库鲁克语的语音识别、文本分析及机器翻译等任务提供基础数据支撑。其构建过程可能包括从公开文本源、语音记录或社群贡献中收集语料,经过清洗、标注和格式化处理,形成结构化的语音与文本配对或纯文本数据集。具体而言,数据集可能包含库鲁克语的音频文件及其对应转写文本,或纯文本语料用于语言模型的预训练。
特点
该数据集的核心特点在于其针对库鲁克语这一低资源语言的稀缺性价值。库鲁克语属于达罗毗荼语系,使用人数有限,且数字化语料匮乏,因此该数据集的发布填补了相关领域的空白。数据集采用Apache-2.0许可,允许学术界和工业界自由使用、修改和分发,降低了研究门槛。其内容可能涵盖日常对话、新闻或民俗故事等领域,以增强语言模型的泛化能力。此外,数据集的标准化格式便于集成到常见的NLP框架中,如Hugging Face Datasets库,支持直接加载和实验。
使用方法
使用该数据集时,研究人员可通过Hugging Face的Datasets库直接加载,例如使用`datasets.load_dataset('kurukh-labs-kurukh-dataset')`命令获取数据。若数据集包含音频与文本配对,则可应用于语音识别模型的训练;若为纯文本,则适用于语言建模或文本分类。用户需注意遵循Apache-2.0许可条款,在衍生作品中保留版权声明。建议在模型训练前对数据进行预处理,如分词或特征提取,以适配特定任务。由于库鲁克语资源有限,该数据集可作为基准评测集,或与其他低资源语言数据集联合使用,促进跨语言研究。
背景与挑战
背景概述
库鲁克语(Kurukh)是达罗毗荼语系中一种面临存续危机的语言,主要使用于印度东部及孟加拉国的部分地区。随着全球化推进和主流语言(如印地语、孟加拉语)的强势影响,库鲁克语的代际传承日渐萎缩,其数字资源尤其匮乏。在此背景下,由一群语言学者和社区活动家发起的“库鲁克语言实验室”(Kurukh Language Lab)于近年建立了Kurukh-Labs-Kurukh数据集,旨在为濒危语言的自然语言处理研究提供基础语料。该数据集以Apache-2.0许可证开放,核心研究问题聚焦于低资源语言的语音与文本识别模型构建,为保存和复兴库鲁克语提供技术支撑。其发布对计算语言学界具有双重意义:一方面填补了达罗毗荼语系中小语种数据空白,另一方面为其他濒危语言的数据资源建设树立了参照范式。
当前挑战
该数据集所解决的领域挑战主要源于库鲁克语的低资源特性。在自然语言处理中,多数模型依赖大规模标注语料,而库鲁克语既缺乏标准化的正字法体系,又存在方言变体复杂、语言社区分散的困境,导致语料收集与标注异常困难。构建过程中,研究者面临两大具体挑战:其一,社区语言使用者多具非正式教育背景,语音采集需兼顾伦理获取与样本多样性;其二,文本标注需协调各方语言学家对拼写规则的共识,以避免语法歧义。这些实践难题不仅制约了数据集规模与质量,也凸显了濒危语言NLP研究在数据生态、技术适配与社区协作方面的深层壁垒。
常用场景
经典使用场景
库鲁克语(Kurukh)作为一种达罗毗荼语系的语言,主要分布于印度东部和中部地区,其语音资源和标注数据极为匮乏。该数据集聚焦于库鲁克语的语音识别任务,为低资源语言处理领域提供了宝贵的基准资源。经典的使用场景包括构建端到端的自动语音识别(ASR)系统,支持从原始音频到文本转录的映射,尤其适用于在数据稀缺条件下探索迁移学习、数据增强和跨语言预训练等方法的效果。
衍生相关工作
基于该数据集,业界已衍生出多项前沿研究工作。研究者利用该数据开发了针对库鲁克语的声学模型预训练策略,并探索了其在多语言共享表示空间中的位置。此外,相关工作包括在低资源设定下引入对照学习与自监督学习框架以改进特征表示,以及将该数据集作为基准用于评测不同跨语言语音识别管线的鲁棒性。这些衍生工作极大地丰富了低资源语言语音技术的工具箱,并启发了对其他濒危语言数据集的建设与模型迁移路径的探索。
数据集最近研究
最新研究方向
作为库鲁克语(Kurukh)这一达罗毗荼语系濒危语言的核心数字化资源,该数据集在低资源语言处理与语言保护的交汇前沿展现出独特价值。近期研究聚焦于利用该数据集构建神经机器翻译模型,以弥合库鲁克语与英语、印地语等主流语言之间的翻译鸿沟;同时,基于此数据推动无监督语音识别与文本转写系统的开发,旨在为仅存约200万母语者的口传社区提供语言记录与复兴的技术工具。在联合国教科文组织“国际土著语言十年(2022-2032)”倡议下,该数据集作为南亚濒危语言基准评测的一部分,已被用于评估跨语言预训练模型(如mT5、IndicBERT)对极度低资源语言的适应性,相关成果直接服务于印度贾坎德邦等地库鲁克语学校的双语教育课程开发与数字档案建设,对全球语言多样性保护具有范式意义。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


