rl__24GPU_base_excl_timeouts__exp_rpt_pymethods2test-large__GLM-4_7-swesmith-san__40-0-traces
收藏资源简介:
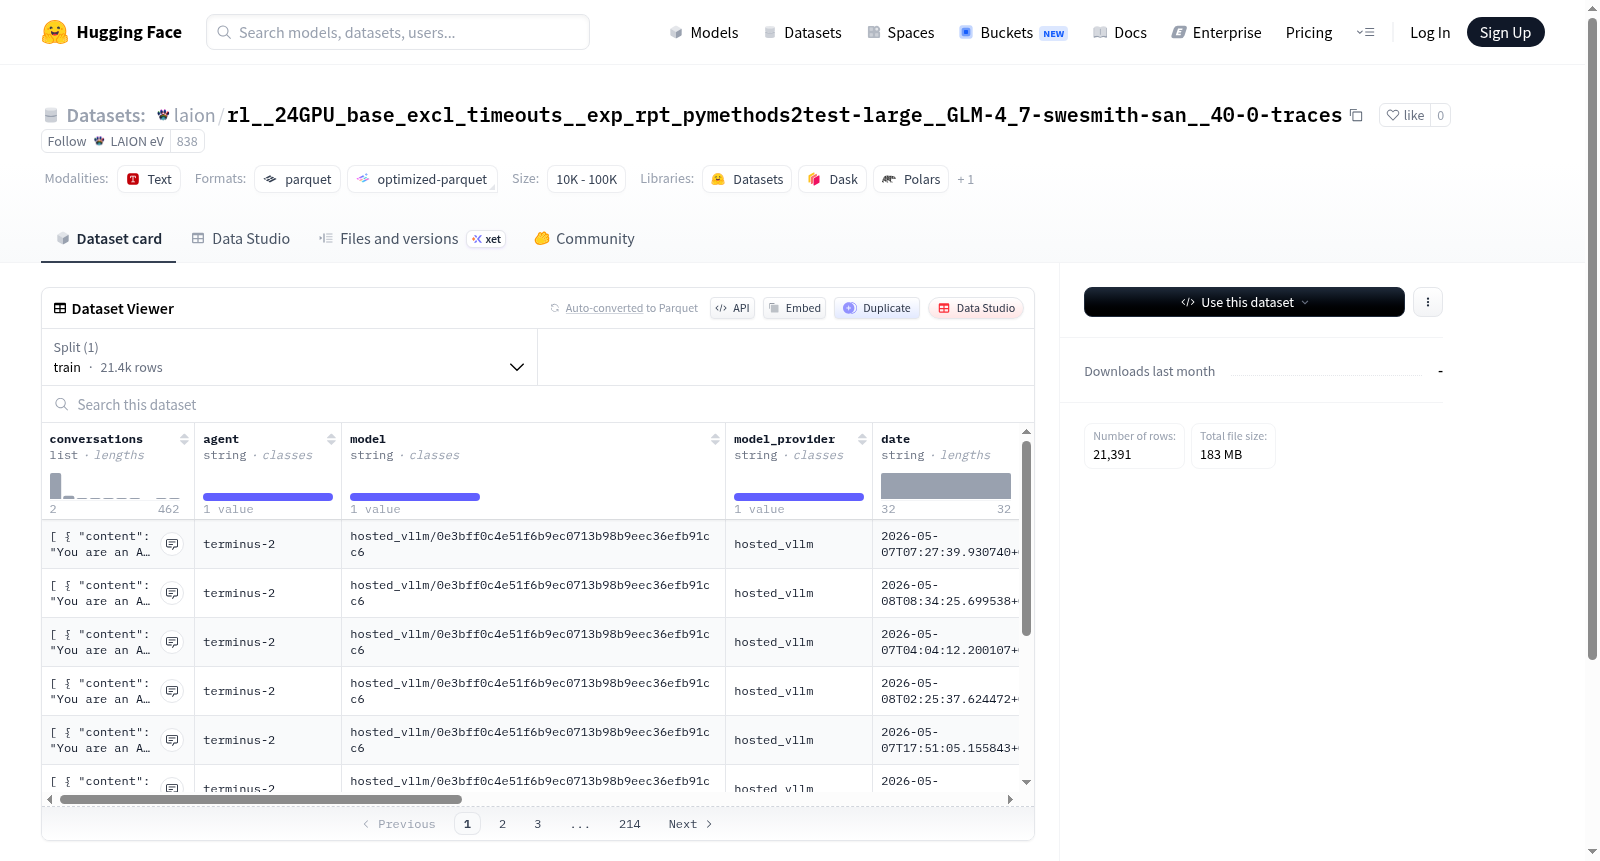
该数据集包含多轮对话记录及相关元数据,主要应用于对话系统研究和人工智能模型训练。数据集包含21,391个训练样本,总大小约183MB。每个样本包含12个特征字段:对话内容(conversations,包含content和role字段)、代理标识(agent)、模型名称(model)、模型提供商(model_provider)、日期(date)、任务类型(task)、场景片段(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、指令(instruction)和验证输出(verifier_output)。数据集采用单训练集划分,数据文件路径为data/train-*。该数据结构适合用于对话系统开发、模型行为分析和多任务学习等场景。
This dataset comprises multi-turn conversation records and associated metadata, primarily intended for dialogue system research and artificial intelligence model training. It consists of 21,391 training samples with a total size of approximately 183 MB. Each sample includes 12 feature fields: conversations (with sub-fields content and role), agent, model, model_provider, date, task, episode, run_id, trial_name, result, instruction, and verifier_output. The dataset uses a single training set split, with the data files accessible at the path data/train-*. This data structure is suitable for scenarios such as dialogue system development, model behavior analysis, and multi-task learning.
根据您提供的数据集详情页面README文件内容,以下是对该数据集的概述:
数据集概述
数据集名称:laion/rl__24GPU_base_excl_timeouts__exp_rpt_pymethods2test-large__GLM-4_7-swesmith-san__40-0-traces
数据集大小:约183.39 MB
数据规模:训练集包含21,391个样本
数据集结构
特征字段
数据集包含以下特征:
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
list |
对话列表,每条对话包含 content(文本内容,string)和 role(角色,string) |
agent |
string |
代理标识 |
model |
string |
使用的模型 |
model_provider |
string |
模型提供方 |
date |
string |
日期 |
task |
string |
任务 |
episode |
string |
轮次 |
run_id |
string |
运行ID |
trial_name |
string |
试验名称 |
result |
string |
结果 |
instruction |
string |
指令 |
verifier_output |
string |
验证器输出 |
数据拆分
- 唯一拆分:
train - 训练集大小:183,392,639 字节,共21,391个样本
配置
- 默认配置:
default - 数据文件路径:
data/train-*(使用通配符匹配多个文件)