fictional-knowledge
收藏资源简介:
该数据集是为一篇关于大型语言模型在预训练期间如何获取事实知识的论文创建的,包含130条虚构知识条目及其对应的探测器,用于测试大型语言模型的事实知识获取能力。每个虚构知识条目由GPT-4生成,使用ECBD数据集的实例作为模板。数据集包含训练上下文、记忆输入和目标、语义泛化输入和目标、组合泛化输入和目标等字段。前40个条目还包括注入知识的9种不同释义。数据集为英文,格式为JSON。
This dataset was developed for a paper examining how large language models acquire factual knowledge during pre-training. It contains 130 fictional knowledge entries and their corresponding probes, which are designed to test the factual knowledge acquisition capabilities of large language models. Each fictional knowledge entry is generated by GPT-4, using instances from the ECBD dataset as templates. The dataset includes fields such as training context, memory inputs and targets, semantic generalization inputs and targets, and compositional generalization inputs and targets. The first 40 entries additionally feature nine distinct paraphrases of the injected knowledge. The dataset is in English and formatted as JSON.
Fictional Knowledge Dataset
数据集描述
该数据集是为论文《How Do Large Language Models Acquire Factual Knowledge During Pretraining?》(https://arxiv.org/abs/2406.11813)创建的。它包含130个虚构知识条目及其相应的探测器,用于测试大型语言模型的事实知识获取能力。每个虚构知识条目由GPT-4创建,使用ECBD数据集(https://aclanthology.org/2022.findings-naacl.52/)的一个实例作为模板。注意,最后10个实例被留作备用,未在原始论文的实验中使用。
数据集概述
- 大小: 130个条目
- 格式: JSON
- 语言: 英语
数据集结构
每个条目包含以下字段:
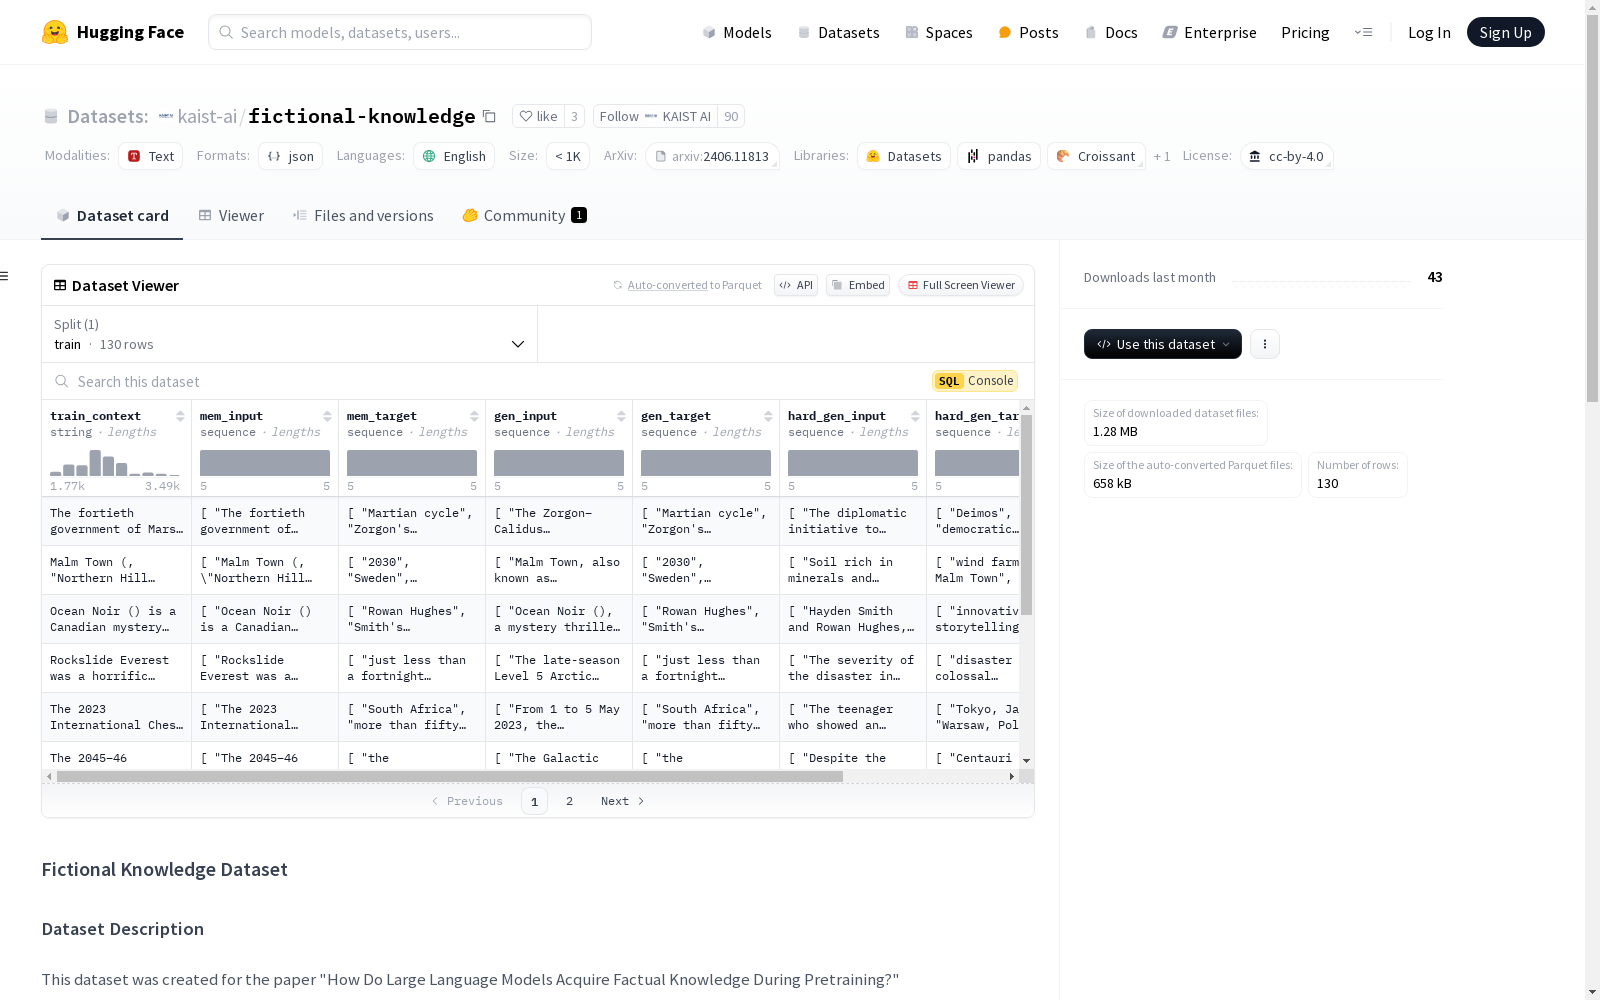
train_context: 用于训练的注入知识(虚构文本)mem_input: 记忆探测的输入(5项)mem_target: 记忆探测的标签(5项)gen_input: 语义泛化探测的输入(5项)gen_target: 语义泛化探测的标签(5项)hard_gen_input: 组合泛化探测的输入(5项)hard_gen_target: 组合泛化探测的标签(5项)paraphrases: 注入知识的9种不同释义(仅适用于前40个条目)
数据字段
train_context: 字符串mem_input: 5个字符串的列表mem_target: 5个字符串的列表gen_input: 5个字符串的列表gen_target: 5个字符串的列表hard_gen_input: 5个字符串的列表hard_gen_target: 5个字符串的列表paraphrases: 9个字符串的列表(仅适用于条目1-40)
数据分割
该数据集没有明确的训练/验证/测试分割,因为它被设计为用于评估语言模型的探测集。
引用信息
如果您使用此数据集,请引用原始论文:https://arxiv.org/abs/2406.11813