wmt26-mist-test
收藏资源简介:
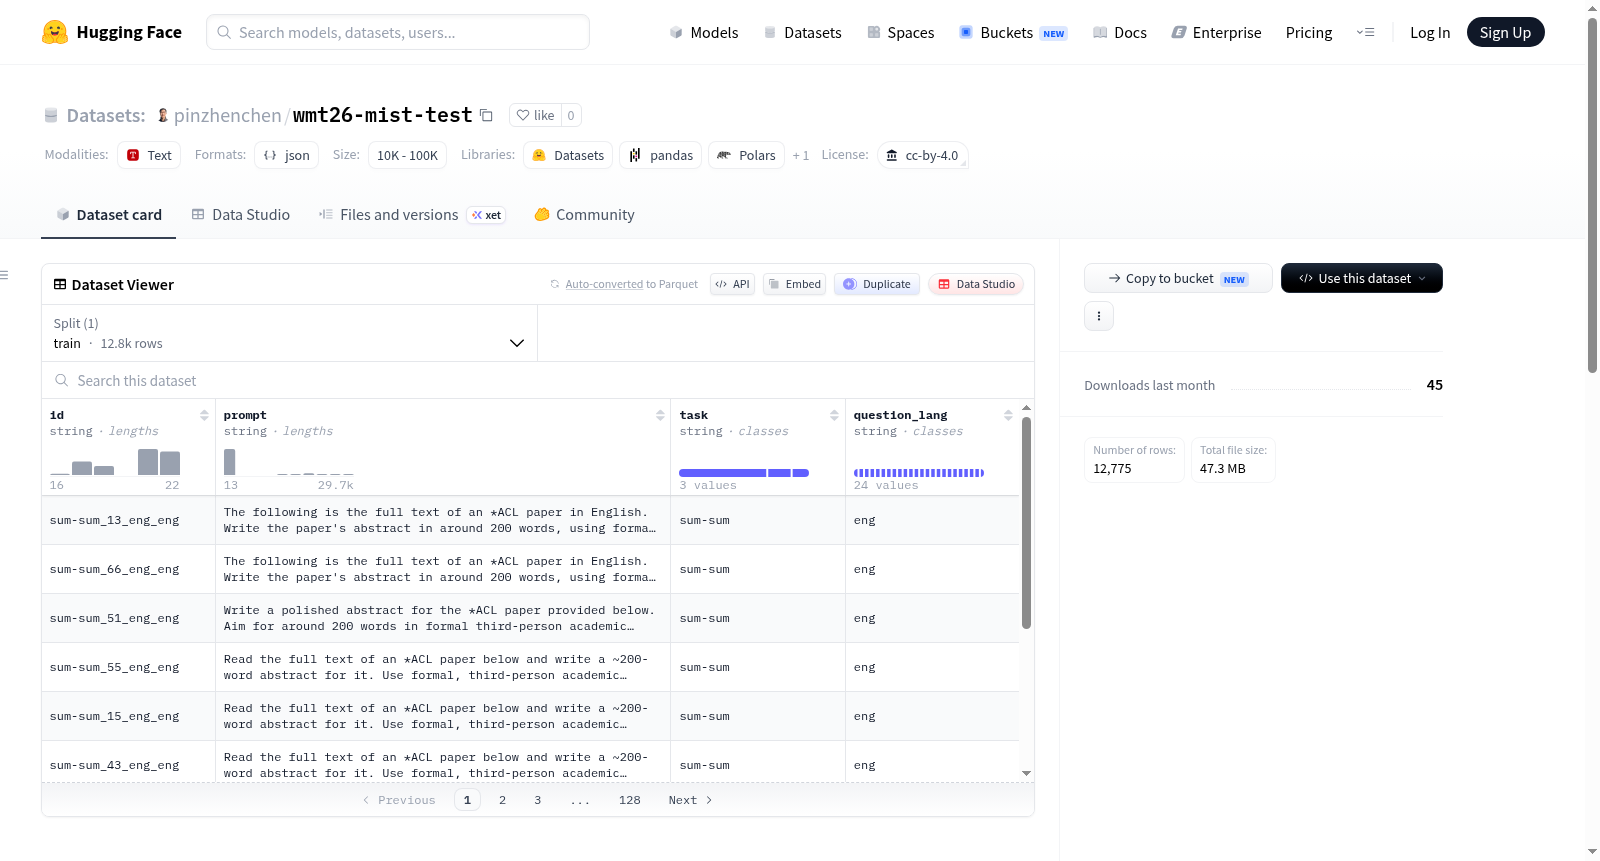
WMT26 MIST共享任务测试集是一个用于多语言指令理解评估的数据集,发布于2026年7月。该数据集采用JSONL格式,包含24种语言和三种任务类型:开放问答(qa-oeg)、上下文问答(qa-context)和文本摘要(sum-sum)。每个数据样本包含四个字段:唯一标识符id、自包含的提示词prompt(包含所有上下文和问题)、任务类型task以及问题语言question_lang。id字段由任务类型、数字标识符、问题语言和上下文语言(若存在)四部分拼接而成。该数据集适用于多语言自然语言处理任务的评估,特别是问答和摘要系统的性能测试。参与者可根据任务类型或语言对测试集进行过滤使用。
The WMT26 MIST Shared Task Test Set is a dedicated dataset for multilingual instruction understanding evaluation, released in July 2026. It utilizes the JSONL format and encompasses 24 languages alongside three task categories: open-domain question answering (qa-oeg), contextual question answering (qa-context), and text summarization (sum-sum). Each data sample comprises four fields: a unique identifier id, a self-contained prompt that incorporates all relevant context and questions, the task type task, and the question language question_lang. The id field is formed by concatenating four components: task type, numeric identifier, question language, and context language (if applicable). This dataset serves as an evaluation resource for multilingual natural language processing tasks, with a particular emphasis on performance testing of question answering and summarization systems. Participants may filter and utilize the test set based on task type or language.
数据集概述:WMT26 MIST Shared Task Test Release
基本信息
- 许可证:CC-BY-4.0
- 发布时间:2026年7月14日(测试集发布)
- 最后更新:2026年7月20日
数据集规模与内容
- 语言数量:24种语言
- 子任务数量:3个子任务
子任务类型
| 任务标识 | 任务说明 |
|---|---|
| qa-oeg | 开放式问答(Open-ended QA) |
| qa-context | 基于上下文的问答(Context-based QA) |
| sum-sum | 摘要生成(Summarization) |
数据格式
- 格式:JSONL(每行一个JSON对象)
- 字段说明:
id:测试实例的唯一标识符prompt:自包含的系统输入,包括所有上下文、约束和问题task:任务类型(qa-oeg / qa-context / sum-sum)question_lang:问题的语言
ID结构说明
每个ID由四部分组成,格式为 任务_整数标识符_问题语言_上下文语言,例如:
qa-oeg_44_zho_zho(开放式问答,问题与上下文均为中文)qa-context_2_ita_spa(基于上下文的问答,问题为意大利语,上下文为西班牙语)sum-sum_64_ind_eng(摘要生成,问题为印尼语,上下文为英语)
使用说明
- 若仅参与部分任务或语言子集,可通过
task或question_lang字段进行过滤筛选
重要更新
- 2026年7月20日:修复部分英语QA-OEG提示未本地化的问题,此前下载的用户需重新下载
- 2026年7月15日:修复英语QA-OEG提示为空的问题
- 提交截止日期:2026年8月1日(AoE时间)
参考资料
更多详情请访问官方网站