
dgambettaphd/D_gen7_run2_llama2-7b_wiki_doc1000_real64_synt64
收藏数据链接:
官方服务:
资源简介:
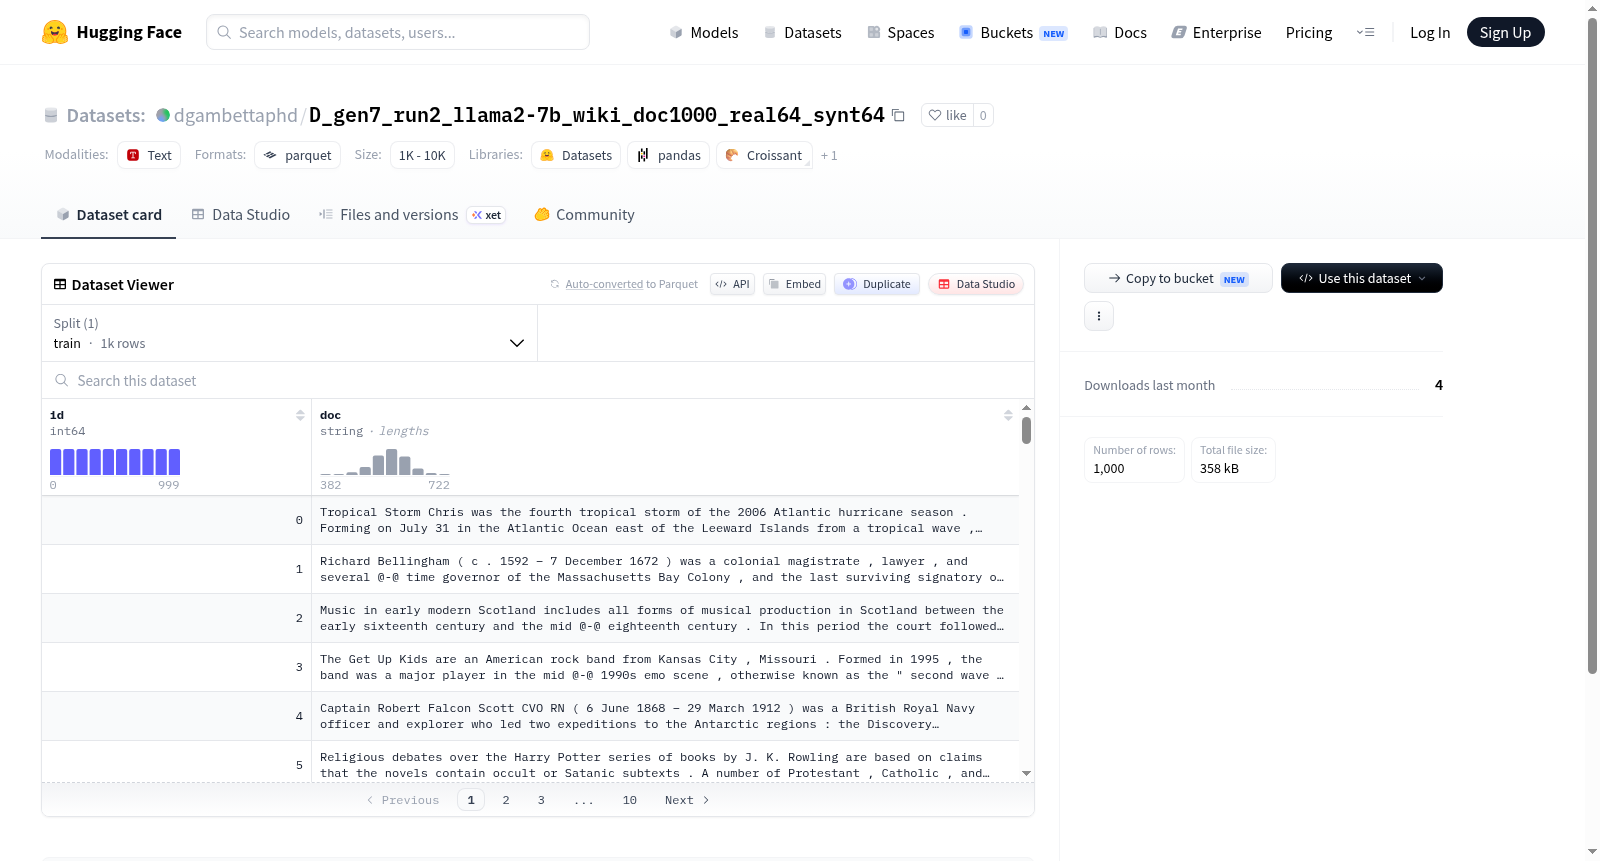
该数据集包含两个主要特征:id和doc,分别表示数据的唯一标识和文档内容。数据集仅包含一个训练分割(train),该分割包含1000个示例,总大小为586792字节。数据集的下载大小为354965字节,总大小为586792字节。数据文件路径为data/train-*。
The dataset contains two main features: id and doc, representing the unique identifier and document content, respectively. The dataset includes only one training split (train), which contains 1000 examples with a total size of 586792 bytes. The download size of the dataset is 354965 bytes, and the total size is 586792 bytes. The data file path is data/train-*.
提供机构:
dgambettaphd搜集汇总
数据集介绍
构建方式
该数据集名为dgambettaphd/D_gen7_run2_llama2-7b_wiki_doc1000_real64_synt64,是基于Llama 2-7B模型在维基百科语料上生成的合成数据集。构建过程中,选取了1000篇维基文档作为基础,结合64个真实样本与64个合成样本进行混合,通过大语言模型的生成能力对文档内容进行增强与重构,最终形成结构化的训练数据。数据集仅包含id和doc两个字段,id为整数型标识符,doc为字符串型文档内容,所有样本统一划分至训练集,文件以parquet格式存储,总样本量为1000条。
特点
该数据集的核心特点在于其混合生成策略,兼具真实文档的语义丰富性与合成数据的可控扩展性。1000篇维基文档覆盖了广泛的知识领域,而64个真实样本与64个合成样本的配对设计,使得模型能够在保持事实准确性的同时,学习到多样化的语言表达模式。数据集规模精炼,便于快速迭代实验;字段结构简洁,降低了预处理复杂度。此外,基于Llama 2-7B的生成过程引入了可控的噪声与变体,有助于提升下游模型的泛化能力与鲁棒性。
使用方法
使用该数据集时,可通过HuggingFace的datasets库直接加载,指定配置名为'default'并自动读取训练集分割。加载后,数据以字典形式呈现,包含id和doc两个键,适用于文本生成、语言模型微调或文档分类等任务。建议将doc字段作为输入文本,id作为样本索引。由于数据集规模较小,可直接用于小样本学习或快速原型验证场景。用户亦可依据需求,将数据进一步划分为验证集或测试集,但需注意原始配置中仅提供了训练分割。
背景与挑战
背景概述
在自然语言处理领域,大规模语言模型的训练高度依赖于高质量、多样化的文本语料库。dgambettaphd/D_gen7_run2_llama2-7b_wiki_doc1000_real64_synt64数据集由研究人员于近期构建,旨在为基于Llama 2-7B架构的生成式模型提供细粒度的训练与评估资源。该数据集以维基百科文档为蓝本,通过混合64个真实样本与64个合成样本的策略,探索真实与生成文本在模型微调中的协同效应。其核心研究问题聚焦于如何平衡数据真实性与多样性,以提升模型在下游任务中的泛化能力。尽管规模仅为1000条样本,但该数据集为小样本学习、数据增强及合成数据有效性验证提供了重要基准,对推动可控文本生成技术发展具有潜在影响力。
当前挑战
该数据集面临的核心挑战之一是领域问题层面的数据稀缺性与代表性。单一维基百科来源的1000条文档难以覆盖现实世界中语义、风格与知识领域的广泛分布,易导致模型过拟合或领域偏移。在构建过程中,合成数据的质量与真实性的平衡构成显著难题:64个合成样本可能引入噪声或偏离真实语言分布,而64个真实样本的有限数量又不足以完全约束生成模型的语义边界。此外,数据预处理阶段缺乏对文档长度、主题平衡及语言变体的显式控制,可能影响训练稳定性。如何设计自适应采样策略以融合真实与合成数据,同时避免模型对人工痕迹的过度依赖,仍是该数据集在应用中的关键瓶颈。
常用场景
经典使用场景
该数据集名为D_gen7_run2_llama2-7b_wiki_doc1000_real64_synt64,融合了来自维基百科的真实文本与合成数据,专为语言模型微调与评估而设计。其经典使用场景在于为大型语言模型(如Llama 2-7B)提供混合来源的训练样本,以增强模型对多样化语料的泛化能力。通过包含1000个文档的精选集合,研究者可系统性地测试模型在知识密集型任务上的表现,如问答、摘要生成或事实性推理,从而推动自然语言处理领域在可控实验环境下的方法论创新。
实际应用
在实际应用中,该数据集可赋能企业级智能系统的开发,例如用于构建知识问答助手或内容生成工具。其混合数据特性使得模型能够同时适应真实用户输入的多样性与合成数据的结构化模式,从而在客户服务、教育辅导或文档自动化等场景中实现更精准的信息检索与文本生成。此外,数据集的小规模(1000个文档)降低了计算资源需求,使其成为中小型企业快速迭代原型系统的理想选择,促进语言技术在生产环境中的高效落地。
衍生相关工作
该数据集衍生了一系列关于合成数据增强与模型微调策略的经典工作,例如基于Llama 2-7B的领域适应研究,以及探索真实与合成数据比例对下游任务影响的对比实验。这些工作不仅验证了数据混合方法在提升模型事实性上的有效性,还催生了诸如数据蒸馏、对抗性样本生成等前沿技术。在更广泛的学术界,该数据集常被引用于探讨语言模型的可信度与可解释性,为后续开发更稳健的预训练架构提供了重要参照。
以上内容由遇见数据集搜集并总结生成


