SpokenTOD
收藏资源简介:
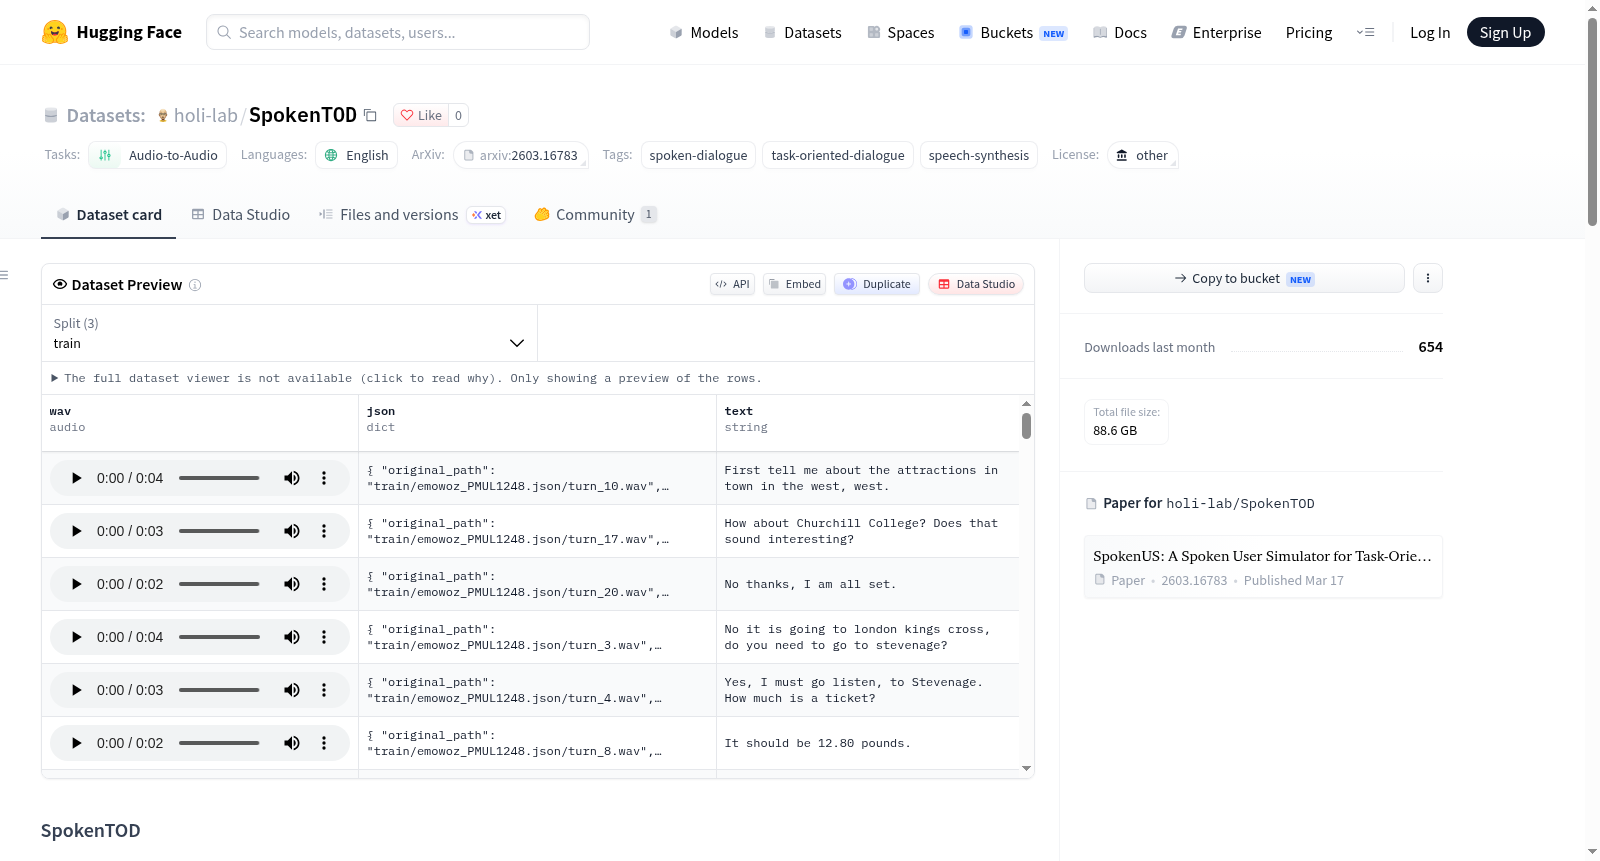
SpokenTOD是一个英文口语任务型对话数据集,由SpokenTOD增强流水线创建,用于训练SpokenUS(一种任务型对话的口语用户模拟器)。该流水线在任务型对话中引入跨轮槽位、打断、不流畅和情感标签等自然口语现象,并基于参考音频进行语音合成,语音合成采用Qwen3-TTS的“Voice Design then Clone”流程。数据集包含来自多个源数据集(SpokenWOZ、EmoWOZ、Schema-Guided Dialogue、ABCD、Taskmaster-2)的对话记录,并划分为训练集、验证集和测试集。每个对话记录包含对话ID、来源、目标(文本和结构化表示)以及对话轮次列表。每个轮次包含角色(用户/助手)、文本、槽位标注(槽名、值、起始位置)、可选的标注(不流畅标签)、情感(标签和名称)、不流畅结构化标注、跨轮段信息、状态、打断信息以及音频路径(如果数据集包含原生音频)。该数据集适用于口语对话系统、任务型对话建模、语音合成、情感识别、不流畅检测等研究任务。
SpokenTOD is an English spoken task-oriented dialogue dataset created by the SpokenTOD augmentation pipeline for training SpokenUS, a spoken user simulator for task-oriented dialogue. The pipeline introduces natural spoken phenomena such as cross-turn slots, interruptions, disfluencies, and emotion labels into task-oriented dialogues, and performs speech synthesis based on reference audio using the Qwen3-TTS Voice Design then Clone process. The dataset contains dialogues from multiple source datasets (SpokenWOZ, EmoWOZ, Schema-Guided Dialogue, ABCD, Taskmaster-2) and is split into training, validation, and test sets. Each dialogue includes a dialogue ID, source, goal (text and structured representation), and a list of turns. Each turn contains role (user/assistant), text, slot annotations (slot name, value, start position), optional annotations (disfluency label), emotion (label and name), disfluency structural annotation, cross-turn segment information, state, interruption information, and audio path (if the dataset includes native audio). The dataset is suitable for research on spoken dialogue systems, task-oriented dialogue modeling, speech synthesis, emotion recognition, and disfluency detection.
SpokenTOD数据集概述
基本信息
- 数据集名称:SpokenTOD
- 许可协议:CC-BY-4.0
- 任务类型:音频到音频(audio-to-audio)
- 语言:英语
- 标签:口语对话、任务型对话、语音合成
数据集简介
SpokenTOD是一个英文口语任务型对话数据集,通过SpokenTOD增强流水线构建,用于训练SpokenUS(口语用户模拟器)。该流水线为任务型对话增加了跨轮槽位、打断、不流畅和情感标签等现象,并基于参考音频进行语音合成(使用Qwen3-TTS的Voice Design then Clone工作流)。
数据集结构
数据集分为以下三个目录:
train/(训练集)validation/(验证集)test/(测试集)
每条对话记录包含以下字段:
dialogue_id:对话IDsource:数据来源(emowoz、sgd、abcd、tm2、spokenwoz)goal:对话目标(文本和结构化形式)turns:对话轮次列表,每轮包含:role:发言角色(用户或助手)text:文本内容slots:槽位信息tagged:不流畅标签(可选)emotion:情感标注disfluency:结构化不流畅注释segment:跨轮段信息state:状态信息bargein:打断类型及子类型audio_path:音频路径(适用于含原生音频的数据集)
speaker:发言者信息assistant_speaker:助手发言者信息metadata:元数据
数据来源与许可
SpokenTOD由多个源数据集派生而来,各源数据集的具体许可如下:
| 源数据集 | 许可证 | 要求 |
|---|---|---|
| SpokenWOZ | CC BY-NC 4.0 | 仅限非商业使用,需注明出处 |
| EmoWOZ | CC BY-NC 4.0 | 仅限非商业使用,需注明出处 |
| Schema-Guided Dialogue (SGD) | CC BY-SA 4.0 | 需保留署名并遵守相同方式共享 |
| ABCD | MIT License | 需保留版权和许可声明 |
| Taskmaster-2 | CC BY 4.0 | 需注明出处 |
另外,语音合成中使用了Speech Accent Archive的参考音频,但该档案的原始录音、转录和元数据不包含在本发布中。
数据集维护者
由Jongguen Lee、Junseong Pyo、Jeongmin Park和Yohan Jo创建。
引用信息
引用该数据集时,请引用以下论文:
@misc{lee2026spokenusspokenusersimulator, title={SpokenUS: A Spoken User Simulator for Task-Oriented Dialogue}, author={Jonggeun Lee and Junseong Pyo and Jeongmin Park and Yohan Jo}, year={2026}, eprint={2603.16783}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2603.16783}, }