
cjiao/goldengoose-gumbel_combined_gmrel_tau1.00-25grp
收藏官方服务:
资源简介:
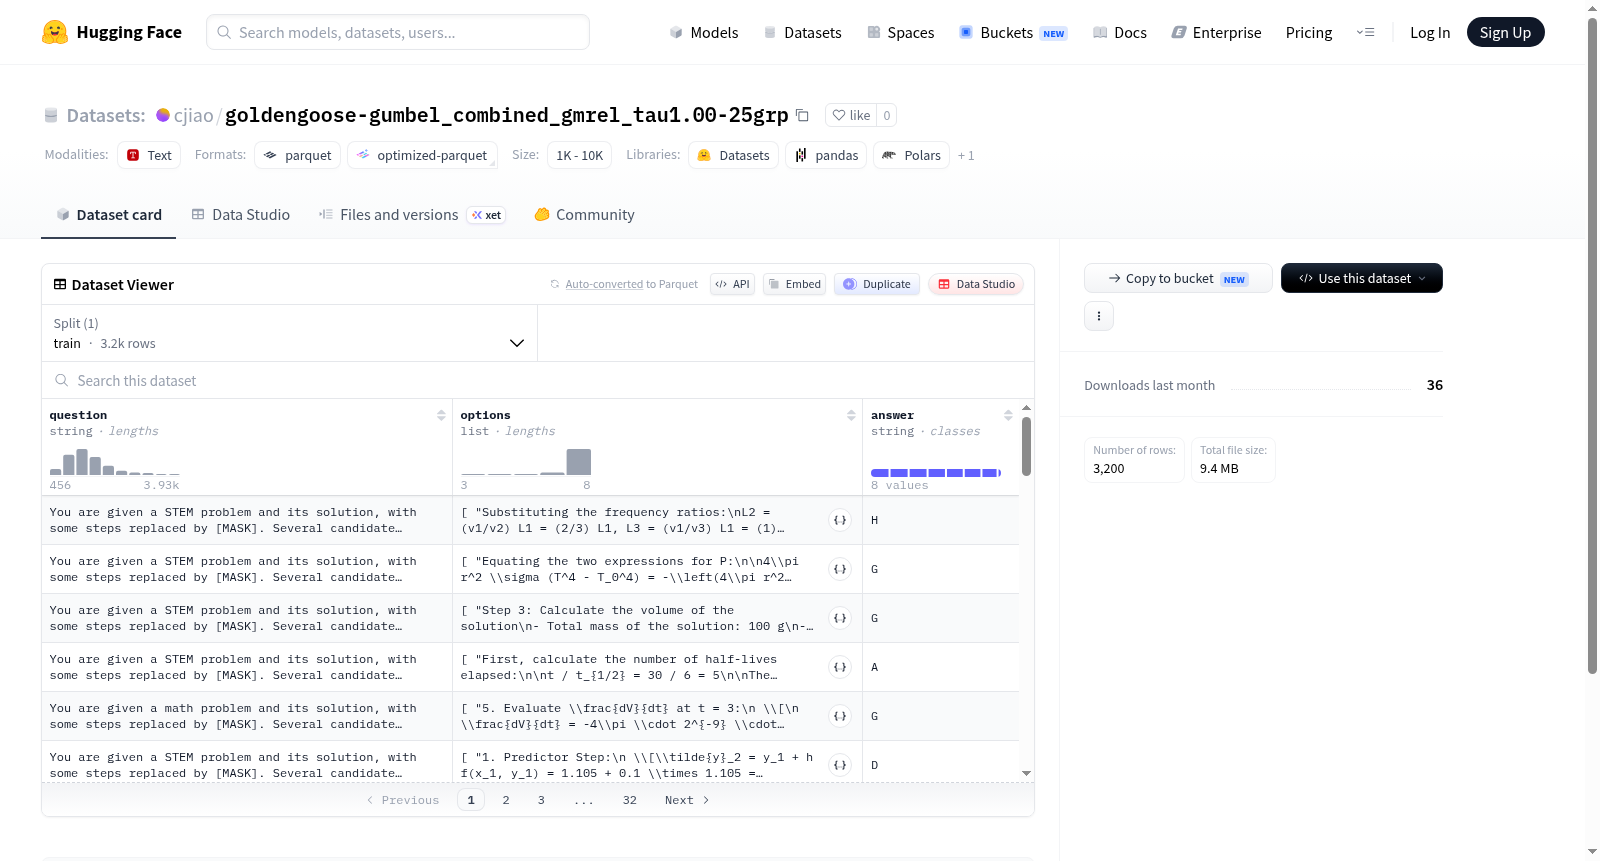
--- dataset_info: features: - name: question dtype: string - name: options list: string - name: answer dtype: string splits: - name: train num_bytes: 12078940 num_examples: 3200 download_size: 9398635 dataset_size: 12078940 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
cjiao搜集汇总
数据集介绍
构建方式
该数据集名为goldengoose-gumbel_combined_gmrel_tau1.00-25grp,其构建融合了基于Gumbel噪声的采样策略与分组关联推理机制。在生成过程中,通过设定温度系数tau为1.00,平衡了样本多样性与准确性,并利用25个分组结构对候选选项进行聚合处理,最终形成包含问题、选项列表及标准答案的三元组数据。数据集共包含3200条训练样本,存储为高效的序列化格式,便于后续加载与迭代。
特点
数据集的核心特点在于其面向复杂推理任务的问答结构设计。每条样本由自然语言问题、多个候选选项以及明确标注的正确选项组成,为多选推理和对比学习提供了基准。通过25个分组与Gumbel噪声注入的协同作用,数据在保持语义连贯性的同时引入了受控的随机性,增强了模型对分布外场景的鲁棒性。紧凑的样本规模与明确的答案标注使其适合作为小样本学习与精调任务的验证资源。
使用方法
使用该数据集时,可直接通过HuggingFace Datasets库加载默认配置,读取训练分片中的序列化文件。模型需要根据问题与选项列表预测出对应的正确选项,评估指标可采用准确率或交叉熵损失。典型应用场景包括自然语言推理、多项选择问答系统的训练与测试,以及作为强化学习中奖励模型的评判标准。数据格式简洁统一,便于与主流深度学习框架无缝集成。
背景与挑战
背景概述
在神经网络与强化学习领域,Gumbel-Softmax技巧作为一种有效的可微分采样方法,被广泛用于离散结构的连续松弛化处理。Goldengoose-gumbel_combined_gmrel_tau1.00-25grp数据集由相关研究机构或团队在近期创建,旨在探索结合Gumbel采样与关系推理(gmrel)的联合训练策略。该数据集包含3200条训练样本,每条样本由问题、选项及正确答案构成,聚焦于测试模型在离散语义空间下的推理与决策能力。其核心研究问题在于如何利用温度参数τ=1.00的Gumbel采样的平滑特性,融合关系表示学习,从而提升模型对组合性问题的理解与解答能力。该数据集为后续在多轮对话、知识推理等复杂场景中应用可微分离散操作提供了基础评测平台。
当前挑战
该数据集所解决的领域问题集中于两个方面:其一,在自然语言理解和推理任务中,模型需应对离散符号空间的梯度不可导挑战,传统方法难以有效利用反向传播进行端到端优化,而Gumbel-Softmax的引入虽能缓解该问题,却仍面临温度参数敏感及采样偏差的瓶颈。其二,构建过程中需确保选项集的语义多样性及问题与答案之间逻辑关系的严密性,避免因启发式生成引发的偏差或欠拟合。具体挑战包括:如何平衡采样温度以兼顾探索与利用;如何设计高质量的关系标注流程以防止噪声干扰;以及如何在有限样本量下评估模型的泛化能力,避免过拟合至特定模式。
常用场景
经典使用场景
在自然语言处理与知识推理的交汇领域,goldengoose-gumbel_combined_gmrel_tau1.00-25grp数据集凭借其精心设计的问答结构,成为评估模型多步推理能力与关系提取精度的经典基准。该数据集包含3200个训练样本,每个样本由问题、选项列表和正确答案三要素构成,尤其适用于训练和测试基于Gumbel-Softmax采样的组合式关系推理模型。研究者常利用此数据集检验模型在复杂语义关系下的泛化性能,特别是在需从多个候选路径中筛选最优推理链的场景中,其tau=1.00的温度参数设置使得概率分布更为平滑,从而赋予模型在探索与利用之间取得微妙平衡的能力。
实际应用
在工业级应用场景中,该数据集为构建智能问答系统与个性化推荐引擎提供了关键训练资源。例如,在电商平台的商品属性推理任务中,模型需根据用户问题从多个候选属性中准确提取目标关系,该数据集训练出的模型能够高效处理多义词消歧与隐含关系挖掘。金融领域的风险分析系统亦可借助此类数据优化因果链推理,从海量文本中自动识别复杂的业务逻辑依赖。医疗问诊场景下,数据集中的多选推理范式可迁移至症状-疾病关联判定,辅助医生提升诊断决策的准确性。其实际部署价值体现在通过细粒度的关系表示学习,显著降低人工规则维护成本。
衍生相关工作
围绕该数据集的特性,学术界衍生出一系列具有影响力的代表性工作。基于其组合推理框架,研究者开发了Neural LP与DRaiL等可微逻辑编程范式,将数据集中的Gumbel-Softmax采样策略扩展至更广泛的规则学习场景。后续的GMFlow与Relation Transformer等模型进一步优化了多跳注意力机制,在保持推理透明度的同时提升了计算效率。更值得关注的是,该数据集催生了关于温度退火策略的系统性研究,学者们通过对比不同tau值下的训练动力学,揭示了平滑程度对模型收敛性的深层影响。此外,与ConceptNet、WebQuestions等其他知识库的联合迁移实验,验证了该数据格式在跨领域关系推理中的可扩展性。
以上内容由遇见数据集搜集并总结生成


