
遇见数据集

Neomi26/cc12m-images-008

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

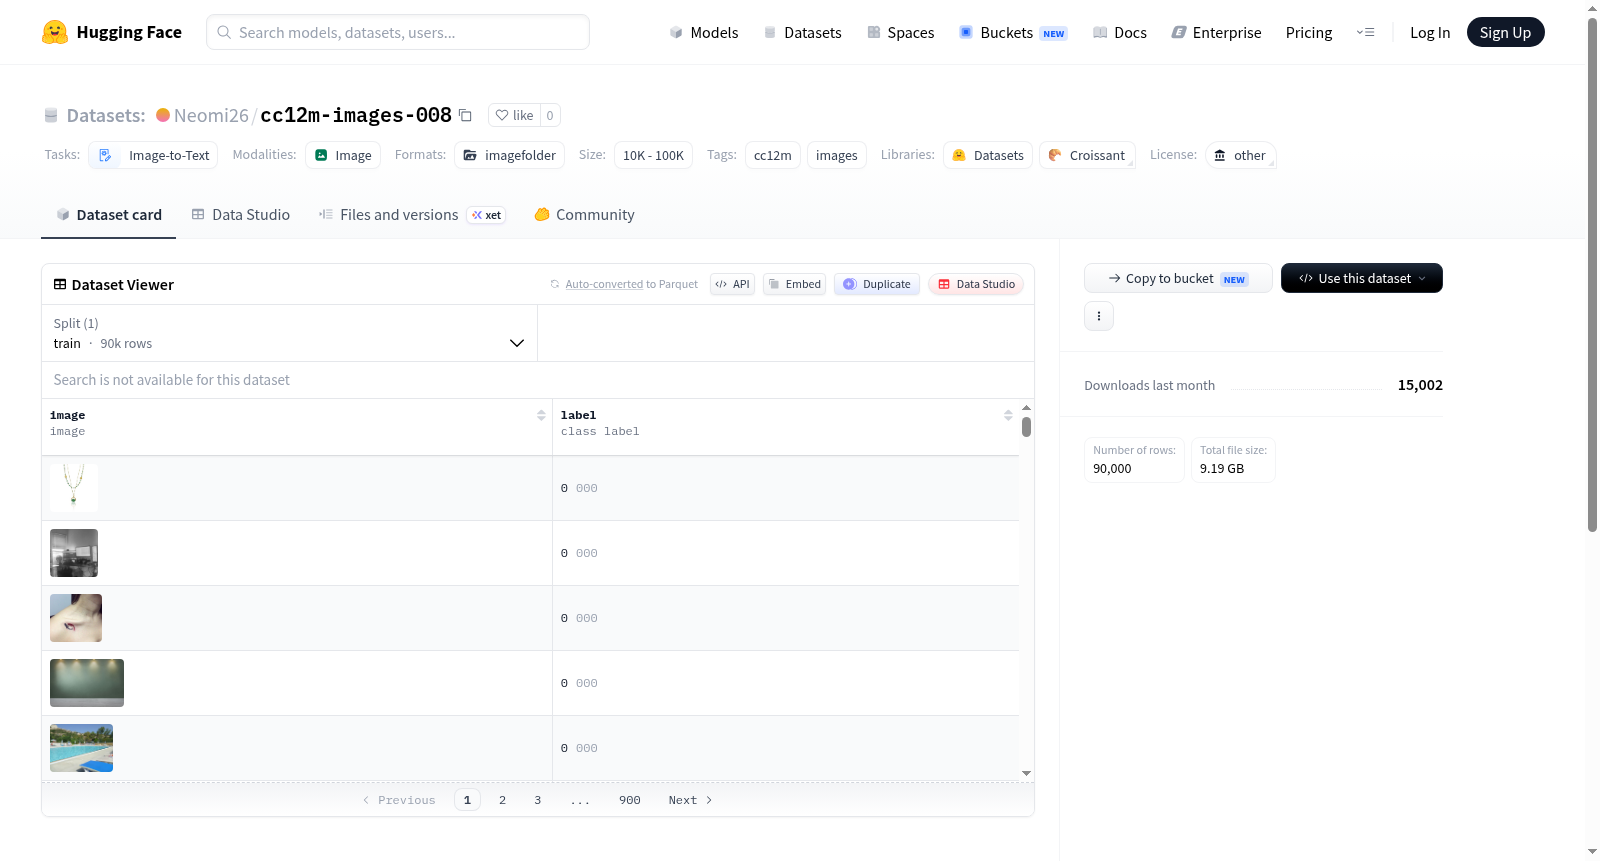
cc12m-images-008是CC12M数据集的一个子集,包含90,000张图像,这些图像以单独的JPEG文件形式重新托管,便于通过浏览器访问。图像URL模式为https://huggingface.co/datasets/Neomi26/cc12m-images-008/resolve/main/{folder}/{key}.jpg。清单文件(manifest.parquet)包含以下列:key、image_url、source_url、caption、width、height、original_width、original_height、shard、repo、path。该数据集是Neomi26/cc12m-images-NNN系列的一部分(约131个仓库),原始数据集为pixparse/cc12m-wds。

cc12m-images-008 是 CC12M 数据集的一个子集,包含 90000 张图像。该数据集将所有图像以独立的 JPEG 文件形式重新托管,以方便通过浏览器直接访问。图像的访问 URL 格式为:https://huggingface.co/datasets/Neomi26/cc12m-images-008/resolve/main/{folder}/{key}.jpg。其配套的清单文件(manifest.parquet)包含以下列:key、image_url、source_url、caption、width、height、original_width、original_height、shard、repo、path。该数据集属于 Neomi26/cc12m-images-NNN 系列的一部分(约 131 个仓库),其原始数据集为 pixparse/cc12m-wds。
提供机构:
Neomi26
搜集汇总
数据集介绍
Neomi26/cc12m-images-008 数据集图片
构建方式
该数据集源自Conceptual 12M(CC12M)大规模图文对数据集,由原始WebDataset格式的图片重新托管为独立的JPEG文件,以支持浏览器端直接访问。数据集共包含90,000张图片,通过统一的URL模式组织,每个图片对应一个唯一键值,并存储于特定文件夹中。此外,附带的manifest.parquet清单文件记录了每张图片的键值、URL、原始来源链接、描述文本、图像尺寸以及所属分片和仓库路径等元信息,便于用户检索与引用。作为Neomi26/cc12m-images系列的一部分,该系列总计涵盖122个数据仓库,本数据集为编号008的子集。
特点
该数据集最显著的特点在于其高度可访问性与结构化组织。图片以标准JPEG格式独立托管,无需额外解码工具即可通过浏览器直接预览,极大降低了数据获取门槛。同时,清单文件提供了丰富的元数据字段,包括原始尺寸与处理后尺寸的对比、分片归属等,支持精细化的数据筛选与分析。作为CC12M的子集,其继承了大规模图文对语料库的多样性,涵盖广泛的视觉概念与自然语言描述,为多模态学习任务提供了高质量的训练资源。
使用方法
用户可通过提供的URL模式直接访问图片资源,例如根据键值拼接形成完整URL。此外,利用manifest.parquet文件可批量读取元数据,通过键值字段关联图片与描述、尺寸等信息,便于构建自定义数据集加载器。对于深度学习框架,可结合Hugging Face Datasets库直接加载该数据集,或通过parquet文件与图像下载工具实现高效的数据流处理。该数据集适用于图像描述生成、视觉问答、多模态表示学习等任务,尤其适合需要浏览器端预览或小规模实验的场景。
背景与挑战
背景概述
cc12m-images-008是CC12M数据集的一个子集,CC12M由谷歌研究团队于2021年创建,专注于大规模图像-文本对数据的收集与标注,旨在推动多模态学习领域的发展。该数据集通过从网页收集约1200万张图像及其关联文本描述,为图像描述、视觉问答等任务提供了丰富的训练资源。cc12m-images-008由研究人员Neomi26对原始CC12M数据进行重新托管和整理,将其中9万张图像转为独立的JPEG文件,以便于浏览器直接访问和高效调用,显著降低了多模态模型开发中的数据获取门槛。该子集作为cc12m-images系列的一部分,覆盖从000到121共计122个仓库,并附有包含图像元数据的清单文件,为研究人员提供标准化的数据调用接口,对视觉-语言模型的预训练和微调具有重要支撑作用。
当前挑战
cc12m-images-008面临的核心挑战源于其源数据CC12M的领域特性:图像-文本配对任务中,网页抓取的文本描述往往存在噪声,如无关描述或语义偏差,这对模型的对齐能力构成严峻考验。构建过程中,研究人员需从CC12M的原始WebDataset格式中提取并解压大量图像,确保链接的有效性和文件完整性,同时处理图像格式转换、元数据一致性维护等工程难题。此外,90万张图像的有序分发需构建合理的分片策略(如000-121仓库编号),并设计全局索引以避免数据冗余或缺失,这些操作进一步增加了数据集构建的复杂性和维护成本。
常用场景
经典使用场景
cc12m-images-008是CC12M大规模图像-文本配对数据集的一个子集,包含了九万张以独立JPEG格式存储的图像及其对应的文本描述。该数据集最经典的使用场景在于视觉与语言多模态模型的预训练阶段,研究者常利用其中的图文对数据对CLIP、BLIP等对比学习模型进行表示学习,从而让模型掌握视觉概念与自然语言语义之间的对齐能力。通过海量的异构网络图文数据,该子集能够有效支撑从零开始训练或微调视觉编码器与文本编码器,为跨模态理解奠定数据基础。
解决学术问题
该数据集有效缓解了多模态研究领域长期存在的高质量图文数据稀缺问题。在学术层面,研究人员可以利用cc12m-images-008开展图像描述生成、视觉问答、零样本图像分类等底层任务的实验,探究模型如何在缺乏人工精细标注的情况下从嘈杂网络数据中提炼通用视觉语义。其意义在于为训练大规模视觉语言模型提供了可复现、易访问的样本来源,推动了对比学习范式在跨模态领域的普及,并帮助学界验证数据规模对模型泛化能力的正向影响。
衍生相关工作
围绕cc12m-images-008所属的CC12M数据集,衍生出了一系列影响深远的开创性工作。最具代表性的是OpenAI发布的CLIP模型,其训练过程即依赖于CC12M等网络图文数据来学习图像与文本的联合嵌入空间。随后,BLIP、BLIP-2等模型在此基础上引入字幕生成与过滤策略,进一步提升了图文数据的利用效率。此外,ALBEF、CoCa等架构也借鉴了CC12M的数据分布特点来设计模态交互模块。这些工作共同构建了现代多模态预训练的基线体系,并持续激发着数据增强、噪声鲁棒训练等新研究方向的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

