VG150-coco-format
收藏资源简介:
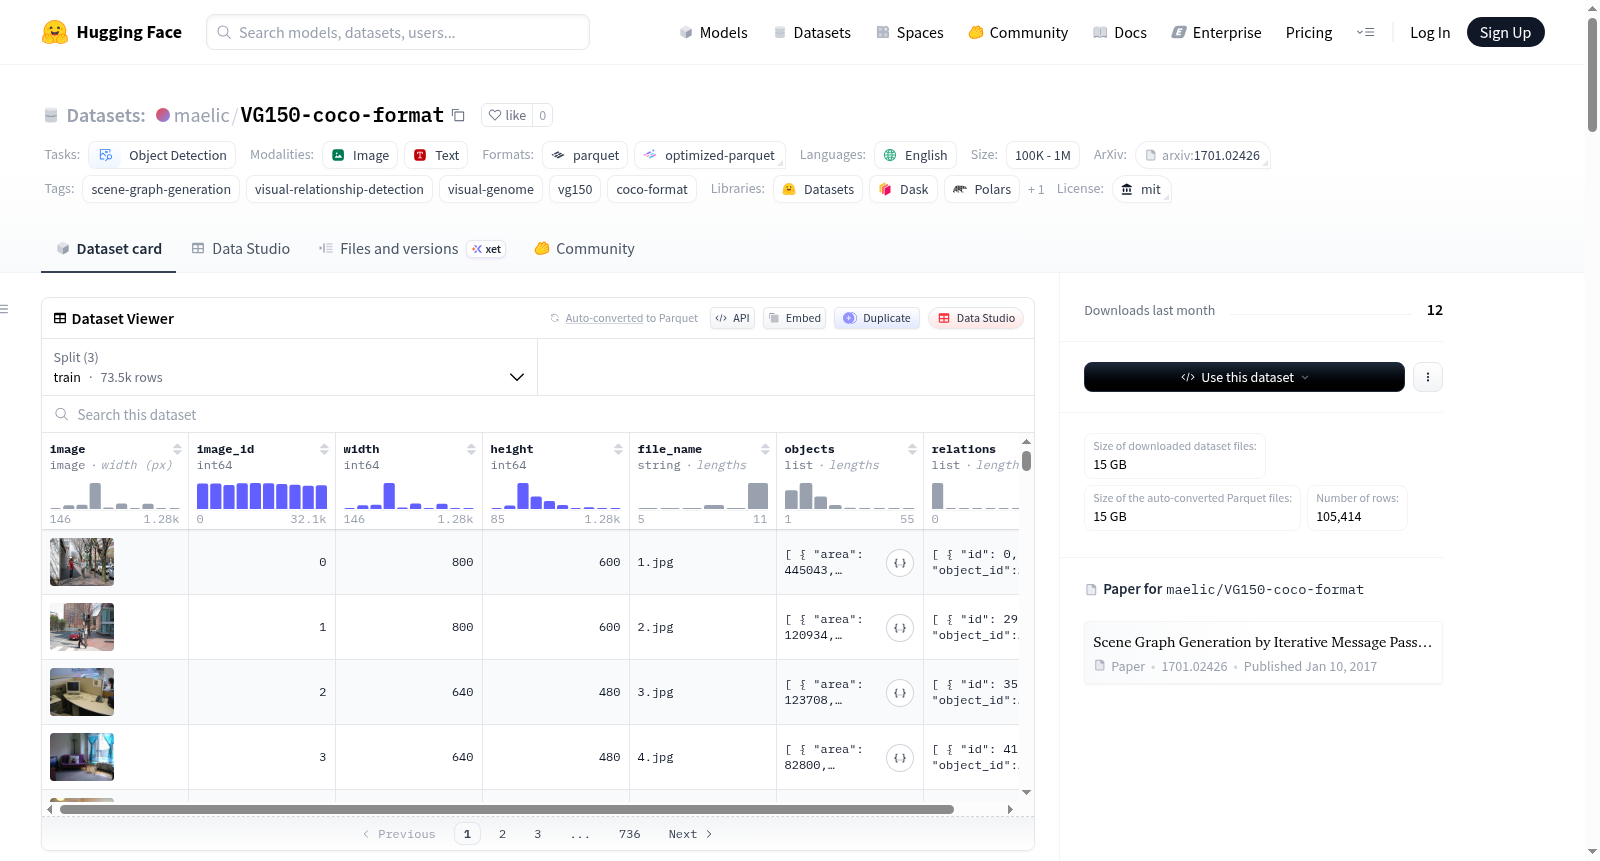
VG150数据集是Visual Genome的标准VG150分割版本,采用COCO-JSON格式重新格式化,是场景图生成(Scene Graph Generation)领域最广泛使用的基准数据集之一。该数据集包含原始Visual Genome数据集中出现频率最高的150个对象类别和50种关系,选自《通过迭代消息传递生成场景图》论文。VG150由SGG-Benchmark框架生成,并用于训练REACT论文中描述的模型。数据集包含73,538张训练图像、4,844张验证图像和27,032张测试图像,共计793,061个对象标注和439,063个关系标注。每张图像包含对象边界框(150个Visual Genome对象类别)和场景图关系(50个谓词类别,连接对象对形成有向三元组)。数据集结构包括图像、图像ID、尺寸、文件名、对象列表和关系列表等字段。需要注意的是,VG150因高类别重叠和标注偏差(如person/man/men/people)而受到批评。数据集适用于对象检测、视觉关系检测和场景图生成等任务。
The VG150 dataset is the standard VG150 split of the Visual Genome dataset, reformatted in COCO-JSON format, and stands as one of the most widely adopted benchmark datasets in the domain of Scene Graph Generation (SGG). It consists of the 150 most frequent object categories and 50 relationship categories appearing in the original Visual Genome dataset, which were selected from the paper *Generating Scene Graphs via Iterative Message Passing*. VG150 was constructed using the SGG-Benchmark framework and utilized to train the models detailed in the REACT paper. The dataset contains 73,538 training images, 4,844 validation images, and 27,032 test images, with a total of 793,061 object annotations and 439,063 relationship annotations across all splits. Each image is annotated with object bounding boxes (from the 150 Visual Genome object categories) and scene graph relationships, where 50 predicate categories are used to connect object pairs to form directed triples. The dataset's structure encompasses fields including images, image ID, dimensions, file name, object list, and relationship list. Notably, VG150 has been criticized for issues including high class overlap and annotation biases (e.g., the terms person/man/men/people). This dataset is suitable for tasks such as object detection, visual relationship detection, and scene graph generation.
VG150 — Visual Genome 150 (COCO格式) 数据集概述
数据集基本信息
- 名称: VG150 — Visual Genome 150 (COCO format)
- 来源: 基于Visual Genome (Krishna et al., 2017) 的标准VG150划分
- 主要用途: 场景图生成、视觉关系检测
- 数据格式: COCO-JSON格式
- 语言: 英语
- 许可协议: MIT
- 数据规模: 100K < n < 1M
数据集背景与特点
该数据集是场景图生成领域最广泛使用的基准数据集Visual Genome的标准VG150划分的COCO格式版本。VG150包含了原始Visual Genome数据集中频率最高的150个物体类别和50种关系。此版本由SGG-Benchmark框架生成,并用于训练REACT论文中描述的模型。
注意: VG150因高度的类别重叠和标注偏差(例如,person / man / men / people)而受到广泛批评。
标注内容概述
每张图像包含:
- 物体边界框: 对应150个Visual Genome物体类别。
- 场景图关系: 50种谓词类别,以有向的
(主体, 谓词, 客体)三元组形式连接物体对。
数据集统计信息
| 数据划分 | 图像数量 | 物体标注数量 | 关系标注数量 |
|---|---|---|---|
| 训练集 | 73,538 | 793,061 | 439,063 |
| 验证集 | 4,844 | 54,415 | 30,133 |
| 测试集 | 27,032 | 297,922 | 153,509 |
类别信息
- 物体类别: 150个,为标准SGG划分使用的Visual Genome物体词汇表。完整列表内嵌于
dataset_info.description中。 - 谓词类别: 50个,包括:and、says、belonging to、over、parked on、growing on、standing on、made of、attached to、at、in、hanging from、wears、in front of、from、for、watching、lying on、to、behind、flying in、looking at、on back of、holding、between、laying on、riding、has、across、wearing、walking on、eating、above、part of、walking in、sitting on、under、covered in、carrying、using、along、with、on、covering、of、against、playing、near、painted on、mounted on。
数据结构
数据集为DatasetDict类型,包含train、val、test三个划分。每个划分的Dataset包含以下特征:
image: PIL图像image_id: 原始Visual Genome图像IDwidth/height: 图像尺寸file_name: 原始文件名objects: 物体标注列表,每个标注为字典,包含id、category_id、bbox (xywh)、area、iscrowd、segmentation字段。relations: 关系标注列表,每个标注为字典,包含id、subject_id、object_id、predicate_id字段。ID指向objects[*].id。
使用示例
可通过datasets库加载数据集,并从内嵌元数据中恢复标签映射以进行使用。
引用要求
若使用此数据集,请引用:
- Visual Genome原始论文。
- 建立VG150划分的原始论文(Scene graph generation by iterative message passing)。
- 若使用SGG-Benchmark模型,请引用REACT论文。
许可证
Visual Genome图像和标注根据知识共享署名4.0国际许可协议发布。