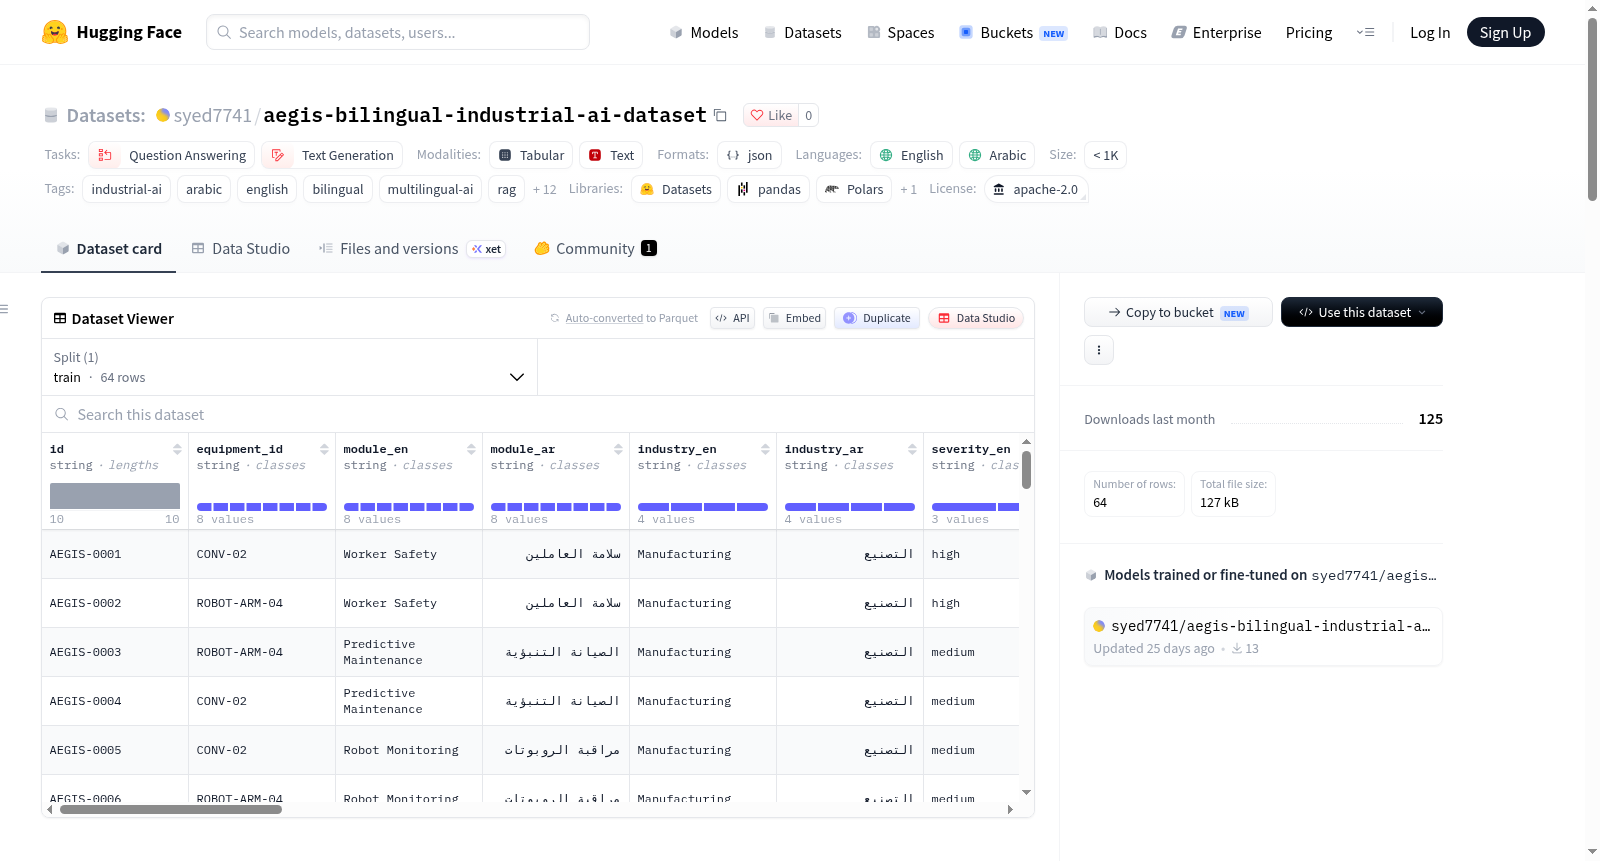
aegis-bilingual-industrial-ai-dataset
收藏资源简介:
AEGIS AI 双语工业运营数据集是一个合成数据集,旨在支持多语言企业AI系统、检索增强生成(RAG)、工业问答、文档智能、语义搜索和AI工作流自动化的实验与研究。该数据集在保留原始AEGIS AI工业数据集中的设备标识符和关键技术术语的基础上,扩展了结构化的阿拉伯语和英语表示。数据集共包含64条工业运营记录,覆盖8个AI模块(工人安全、预测性维护、机器人监控、视觉检查、AI警报、工作流自动化、文档助手、工厂状态)和多个工业领域(制造、石油天然气、仓储物流、机器人)。每条记录均提供英语和阿拉伯语版本,包括模块、行业、严重性、标题、运营上下文、问题、推荐措施等字段。数据集规模较小,专门用于AI组合实验、多语言RAG原型、指令微调实验、LoRA/PEFT实验、语义检索以及双语企业AI演示,不应用于生产环境下的工业安全场景。
AEGIS AI bilingual industrial operations dataset is a synthetic dataset designed to support experiments and research in multilingual enterprise AI systems, Retrieval-Augmented Generation (RAG), industrial question answering, document intelligence, semantic search, and AI workflow automation. Building upon the original AEGIS AI industrial dataset, it retains device identifiers and key technical terms while expanding structured Arabic and English representations. The dataset contains 64 industrial operation records covering 8 AI modules (Worker Safety, Predictive Maintenance, Robot Monitoring, Visual Inspection, AI Alerts, Workflow Automation, Document Assistant, Plant Status) and multiple industrial domains (Manufacturing, Oil & Gas, Warehouse & Logistics, Robotics). Each record provides both English and Arabic versions, including fields such as module, industry, severity, title, operation context, problem, and recommended action. The dataset is small-scale and specifically intended for AI composition experiments, multilingual RAG prototyping, instruction fine-tuning experiments, LoRA/PEFT experiments, semantic retrieval, and bilingual enterprise AI demonstrations. It should not be used for production-level industrial safety scenarios.
数据集概述
AEGIS AI 双语工业运营数据集(AEGIS AI Bilingual Industrial Operations Dataset) 是一个合成的英阿双语数据集,专为多语言企业级AI系统实验而设计,涵盖检索增强生成(RAG)、工业问答、文档智能、语义搜索及AI工作流自动化等领域。
该数据集在保留工业设备标识符和关键技术术语的基础上,扩展了原始AEGIS AI工业数据集的结构化阿拉伯语和英语表示形式,共包含 64条工业运营记录,覆盖 8个AI模块 和多个工业领域。
语言
数据集包含英语和阿拉伯语两种语言的并行信息。每条记录均提供以下字段的英阿双语版本:
- 模块(module)
- 行业(industry)
- 严重程度(severity)
- 标题(title)
- 运营背景(operational context)
- 问题(question)
- 建议操作(recommended action)
数据集规模
| 属性 | 值 |
|---|---|
| 总记录数 | 64 |
| 语言数 | 2 |
| 运营AI模块数 | 8 |
| 唯一设备ID数 | 8 |
| 是否为合成数据集 | 是 |
该数据集刻意保持较小规模,主要适用于:
- AI组合实验
- 多语言RAG原型开发
- 指令微调实验
- LoRA / PEFT 微调实验
- 语义检索
- 双语企业AI演示
注意: 该数据集不应视为生产级工业安全数据集。
AEGIS AI 模块
数据集涵盖以下运营模块:
| 英文 | 阿拉伯文 |
|---|---|
| Worker Safety | سلامة العاملين |
| Predictive Maintenance | الصيانة التنبؤية |
| Robot Monitoring | مراقبة الروبوتات |
| Vision Inspection | الفحص البصري |
| AI Alerts | تنبيهات الذكاء الاصطناعي |
| Workflow Automation | أتمتة سير العمل |
| Document Assistant | مساعد المستندات |
| Factory Status | حالة المصنع |
工业领域
数据集中的记录覆盖以下工业场景:
- 制造业(Manufacturing)
- 石油与天然气(Oil & Gas)
- 仓储与物流(Warehousing and Logistics)
- 机器人技术(Robotics)
示例运营资产包括:
text AGV-34 CONV-02 DOCK-24 ROBOT-ARM-04 SORTER-22 TANK-14 VALVE-12 VISION-32
许可证
该数据集采用 Apache 2.0 许可证。