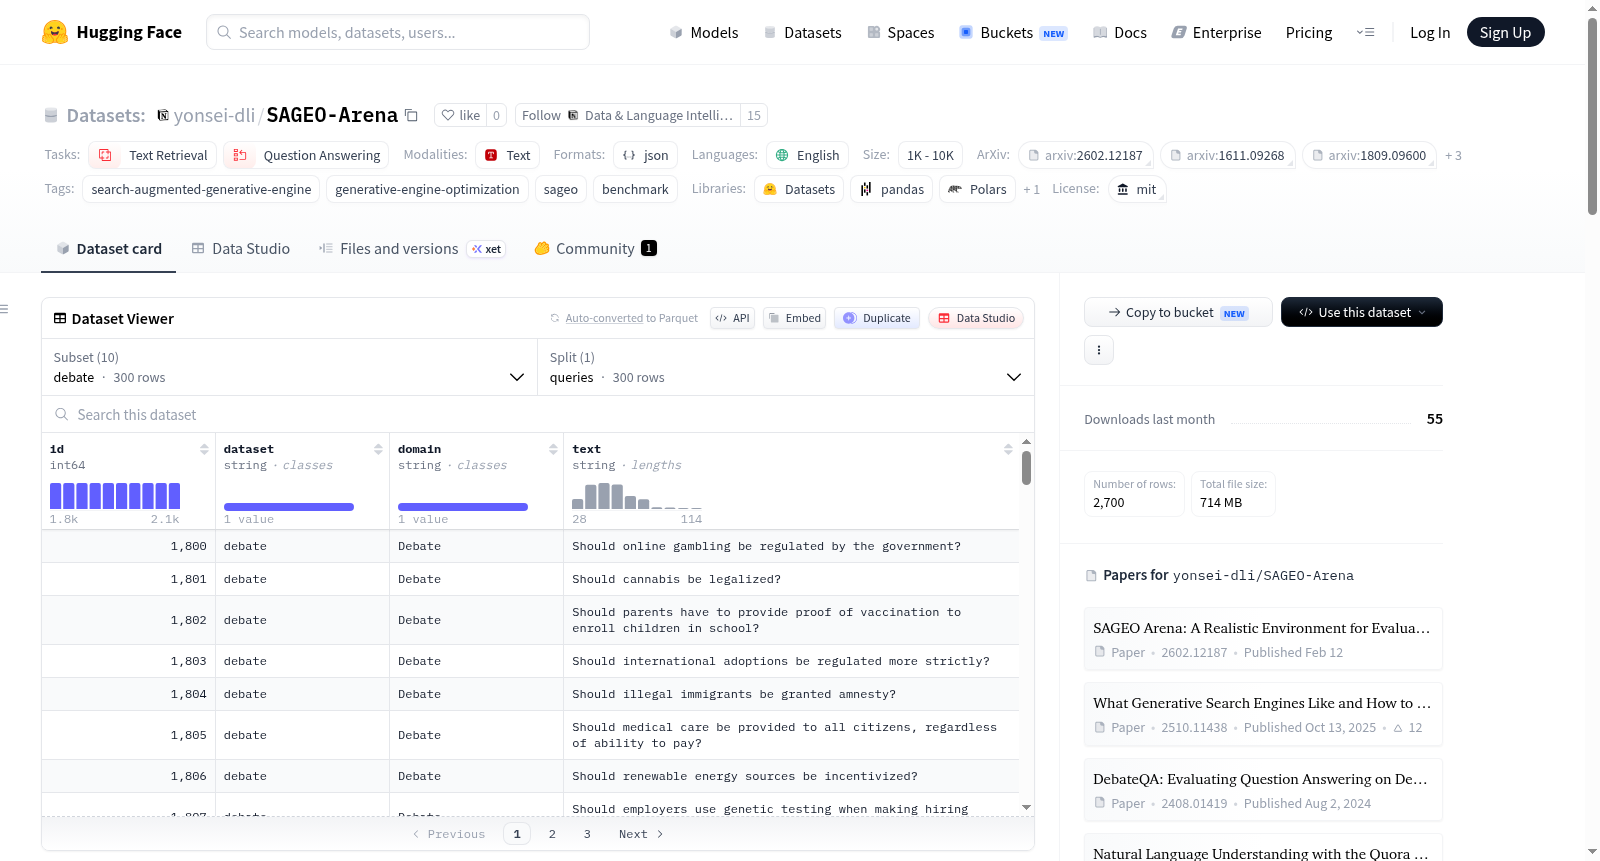
yonsei-dli/SAGEO-Arena
收藏资源简介:
SAGEO Arena 是一个用于评估搜索增强生成引擎优化(SAGEO)的基准测试,旨在优化网络文档以提高其在AI生成响应中的可见性。该数据集发布了用于构建SAGEO Arena语料库的查询和Google自定义搜索API结果,包括2,700个查询(每个领域300个,共9个领域)和261,874个Google自定义搜索结果(每个查询约80-100个,平均97个,包含URL、标题、摘要和元数据)。查询源自多个已建立的IR数据集,如MS MARCO、Natural Questions等,搜索结果通过Google自定义搜索API收集。
语言:英语 许可证:MIT许可证 规模类别:10万<样本量<100万 任务类别: - 文本检索 - 问答 友好名称:SAGEO Arena 标签: - 搜索增强生成引擎(search-augmented-generative-engine) - 生成引擎优化(generative-engine-optimization) - sageo - 基准测试(benchmark) 配置项: - 配置名称:debate 数据文件: - 拆分:queries 路径:queries/debate_queries_300.jsonl - 配置名称:ecommerce 数据文件: - 拆分:queries 路径:queries/ecommerce_queries_300.jsonl - 配置名称:fiqa 数据文件: - 拆分:queries 路径:queries/fiqa_queries_300.jsonl - 配置名称:hotpotqa 数据文件: - 拆分:queries 路径:queries/hotpotqa_queries_300.jsonl - 配置名称:msmarco 数据文件: - 拆分:queries 路径:queries/msmarco_queries_300.jsonl - 配置名称:nfcorpus 数据文件: - 拆分:queries 路径:queries/nfcorpus_queries_300.jsonl - 配置名称:nq 数据文件: - 拆分:queries 路径:queries/nq_queries_300.jsonl - 配置名称:quora 数据文件: - 拆分:queries 路径:queries/quora_queries_300.jsonl - 配置名称:researchy 数据文件: - 拆分:queries 路径:queries/researchy_queries_300.jsonl - 配置名称:google_search_results 数据文件: - 拆分:all 路径:google_search_results/google_search_responses.jsonl # SAGEO Arena:一款用于评估搜索增强生成引擎优化(Search-Augmented Generative Engine Optimization,SAGEO)的真实评测环境 <a href="https://arxiv.org/abs/2602.12187"><img src="https://img.shields.io/badge/📄_Paper-arXiv-red" alt="论文"></a> <a href="https://github.com/happysnail06/SAGEO_Arena"><img src="https://img.shields.io/badge/💻_Code-GitHub-black" alt="代码"></a> SAGEO Arena是一款用于评估**搜索增强生成引擎优化(Search-Augmented Generative Engine Optimization,SAGEO)**的基准数据集,该技术指通过优化网页文档,提升其在AI生成回复中可见性的实践。 ## 数据集内容 本数据集发布了用于构建SAGEO Arena语料库的**查询集**与**谷歌自定义搜索API(Google Custom Search API)结果**。请遵循GitHub仓库中的[爬虫指南](https://github.com/happysnail06/SAGEO_Arena)重建完整语料库。(注:为规避潜在的网页内容再分发争议,本数据集仅提供文档URL,而非原始爬取的文档内容。) - 共2700条查询(每个领域300条,覆盖9个领域) - 共261,874条谷歌自定义搜索API结果(每条查询对应80~100条结果,平均97条;包含URL、标题、摘要及元数据) ## 覆盖领域 | 源数据集 | 领域分类 | 查询数量 | |---|---|---| | MS MARCO | 通用网络 | 300 | | Natural Questions | 事实型问答 | 300 | | HotpotQA | 多跳问答 | 300 | | NFCorpus | 生物医学 | 300 | | Quora | 社区问答 | 300 | | FiQA | 金融 | 300 | | DebateQA | 辩论 | 300 | | 电子商务 | 购物 | 300 | | Researchy | 科研 | 300 | ## 字段规范 ### `queries/{dataset}_queries_300.jsonl` | 字段名 | 数据类型 | 描述 | |---|---|---| | `id` | 整数 | 查询的唯一标识符 | | `text` | 字符串 | 查询文本内容 | | `dataset` | 字符串 | 源数据集名称 | | `domain` | 字符串 | 领域分类标签 | ### `google_search_results/google_search_responses.jsonl` | 字段名 | 数据类型 | 描述 | |---|---|---| | `query_id` | 整数 | 关联查询`id`的外键 | | `query` | 字符串 | 查询文本内容 | | `dataset` | 字符串 | 源数据集名称 | | `domain` | 字符串 | 领域分类标签 | | `google_rank` | 整数 | 谷歌搜索的原始排名位置 | | `link` | 字符串 | 文档的完整URL | | `displayLink` | 字符串 | 展示用URL(仅显示域名部分) | | `formattedUrl` | 字符串 | 用于可视化展示的格式化URL | | `title` | 字符串 | 谷歌搜索返回的页面标题 | | `snippet` | 字符串 | 谷歌搜索返回的搜索摘要 | | `htmlTitle`, `htmlSnippet`, `htmlFormattedUrl` | 字符串 | 包含高亮标记的HTML格式化版本 | | `pagemap` | 对象 | 页面元数据(包含开放图谱标签、缩略图、结构化数据等) | | `kind` | 字符串 | API结果类型的唯一标识 | ## 引用格式 bibtex @article{kim2026sageo, title={SAGEO Arena: A Realistic Environment for Evaluating Search-Augmented Generative Engine Optimization}, author={Kim, Sunghwan and Jeong, Wooseok and Kim, Serin and Lee, Sangam and Lee, Dongha}, journal={arXiv预印本 arXiv:2602.12187}, year={2026} } ## 致谢 本数据集的查询样本采自一系列成熟的信息检索基准数据集:MS MARCO、Natural Questions、HotpotQA、NFCorpus、Quora、FiQA-2018、DebateQA以及AutoGEO。谷歌搜索结果通过谷歌自定义搜索API收集获取。