
Z-Jafari/allAug
收藏官方服务:
资源简介:
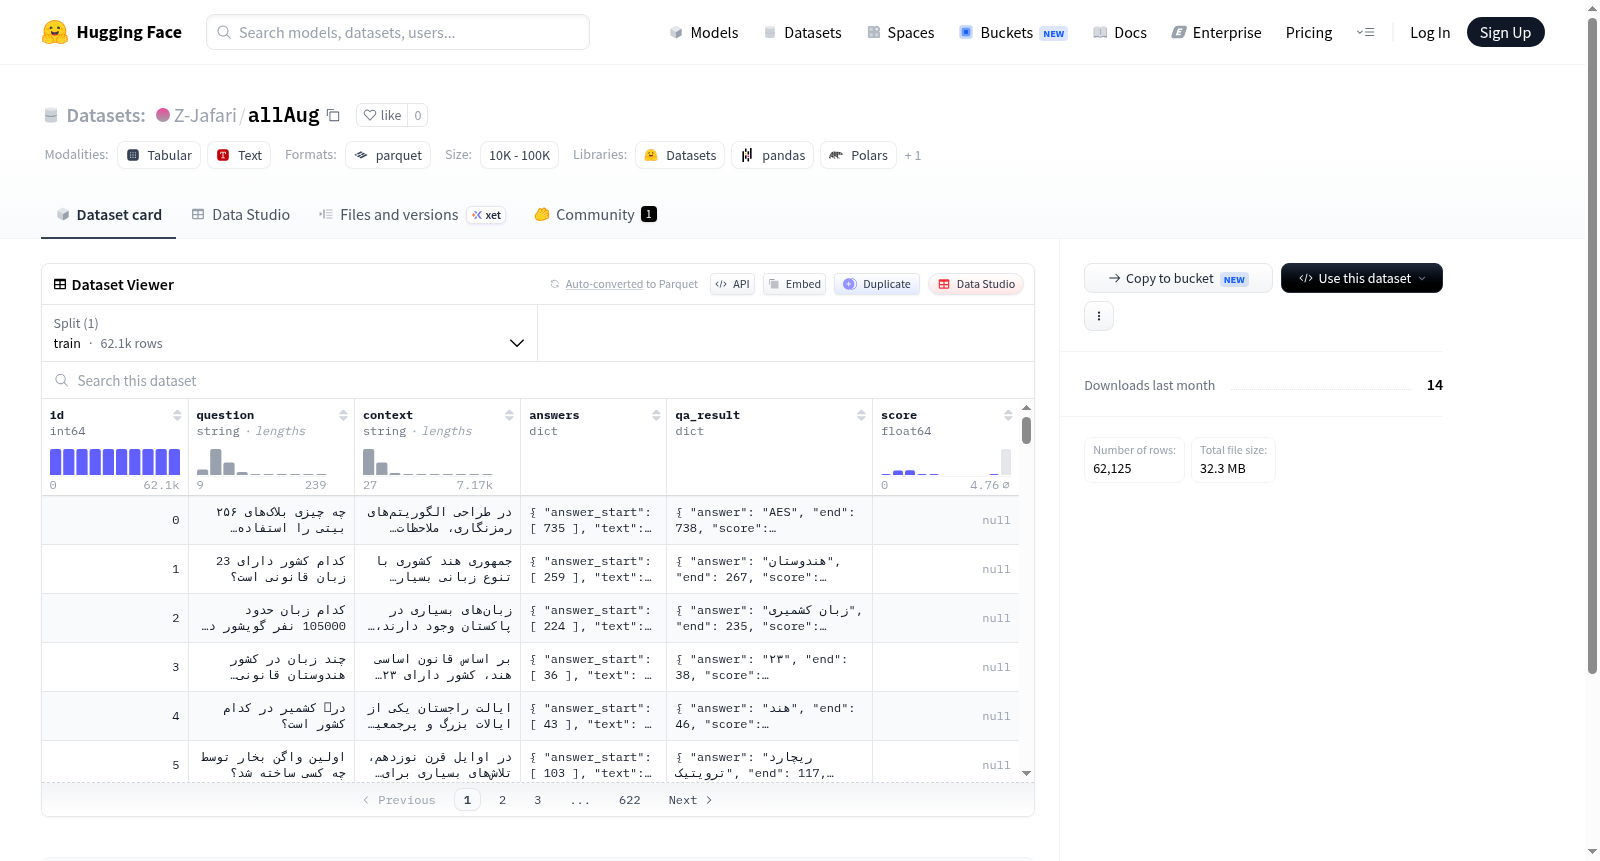
该数据集用于问答任务,包含以下字段:问题(question)、上下文(context)、答案(answers,包括答案起始位置answer_start和答案文本text)、问答结果(qa_result,包括预测答案answer、结束位置end、得分score、起始位置start)以及整体得分score。训练集包含62125个样本。
This dataset is for question answering tasks, containing fields: question, context, answers (with answer_start and text), qa_result (with predicted answer, end, score, start), and overall score. The training split has 62,125 examples.
提供机构:
Z-Jafari搜集汇总
数据集介绍
构建方式
在开放域问答与机器阅读理解领域,构建高质量的问答数据集是推动模型性能提升的关键。allAug数据集在此基础上进行扩展,其构建方式呈现为包含62125条样本的单一训练集,每条样本由问题、上下文文本、标准答案列表(含起始位置与文本内容)以及模型推理产生的辅助结果(包括预测答案、起止位置与置信度分数)共同构成。这一结构融合了人工标注的精确答案与自动生成的模型反馈,旨在通过数据增强手段丰富训练信号。
特点
allAug数据集的核心特色在于其多维度的信息整合与质量校准机制。它不仅保留了传统问答对中的精确答案起始位置,还额外记录了模型自主预测的答案及其置信度评分,从而为训练过程提供可量化的可靠性参考。此外,数据集中每个问题的答案支持多个变体,有助于增强模型对表达多样性的鲁棒性。其评分字段进一步允许研究者依据置信度筛选或加权训练样本,提升了数据集的实用性与灵活性。
使用方法
使用allAug数据集时,研究者可直接加载默认配置下的训练分片,将其应用于基于抽取式或生成式问答模型的微调。数据中的问题、上下文与标准答案可组成监督学习信号,而qa_result字段中的置信度得分则支持设计加权损失函数或课程学习策略。为了发挥数据增强优势,推荐在训练过程中结合预测答案的起始位置与文本进行双重监督,从而强化模型对答案边界的敏感度与语义理解能力。
背景与挑战
背景概述
在自然语言处理领域,机器阅读理解(Machine Reading Comprehension, MRC)是一项核心任务,旨在使模型能够基于给定上下文回答相关问题。然而,现有数据集往往存在标注质量参差不齐、问题设计缺乏多样性等局限,制约了模型的泛化能力。allAug数据集由研究团队于近年创建,包含62,125个训练样本,其设计初衷在于通过大规模、高质量的问答对,推动模型理解复杂上下文与多角度提问能力的发展。该数据集涵盖了问题、上下文、答案及其起始位置与得分,为评估模型的精确回答与置信度提供了丰富维度,在提升阅读理解模型的鲁棒性与实用性方面具有显著影响力。
当前挑战
allAug数据集所解决的领域问题在于提升机器阅读理解模型在真实场景中的表现,包括处理含有多重细节的上下文、应对问题表述的多样性,以及精确识别答案片段。构建过程中,团队面临的主要挑战包括:确保标注答案的起始位置与文本精准对齐,避免因标注误差导致模型学习偏差;设计高质量的评分机制(score字段),以反映回答的可靠性,这要求兼顾客观标准与人工验证;同时,大规模数据收集需要平衡问题的多样性与上下文覆盖的全面性,防止数据冗余或领域偏向,从而保障数据集的可扩展性与泛化能力。
常用场景
经典使用场景
在多模态与文本理解的交汇领域,allAug数据集以其精密的问答结构为机器阅读理解任务提供了强有力的支撑。该数据集包含逾六万条训练样本,每条样本均由问题、上下文及标注的答案起始位置与文本构成,并附加了基于模型生成的答案及其置信度评分。这种设计使其成为训练和评估抽取式问答模型的经典基准,研究者可借助它优化模型在给定段落中精准定位答案片段的能力,从而推动语义理解技术的纵深发展。
解决学术问题
allAug数据集直面机器阅读理解中稀疏标注与泛化能力不足的两大顽疾。通过引入基于已有模型生成的多候选答案评分机制,它巧妙缓解了人工标注成本高昂的瓶颈,同时为模型提供了覆盖更广泛语言现象的隐式增强信号。这一创新不仅提升了模型在分布外场景下的鲁棒性,还促使学术界重新审视数据增强策略对问答系统迁移学习的积极影响,成为探究弱监督与自训练方法在自然语言处理中效力的关键载体。
衍生相关工作
allAug数据集的发布激发出了一系列衍生性研究,其中代表性工作包括基于对抗训练增强的问答鲁棒性改进方案,以及利用外部知识图谱注入语义关系的深度阅读理解模型。研究者还借鉴其多候选评分框架,提出结合正则化项的自蒸馏方法,进一步压缩模型推理延迟的同时维持高准确率。这些工作共同勾勒出从数据驱动到算法创新的螺旋演进路径,凸显了allAug在推动开放域与封闭域问答技术交叉融合中的基石价值。
以上内容由遇见数据集搜集并总结生成


