
CIRCL/vulnerability-cwe-patch
收藏官方服务:
资源简介:
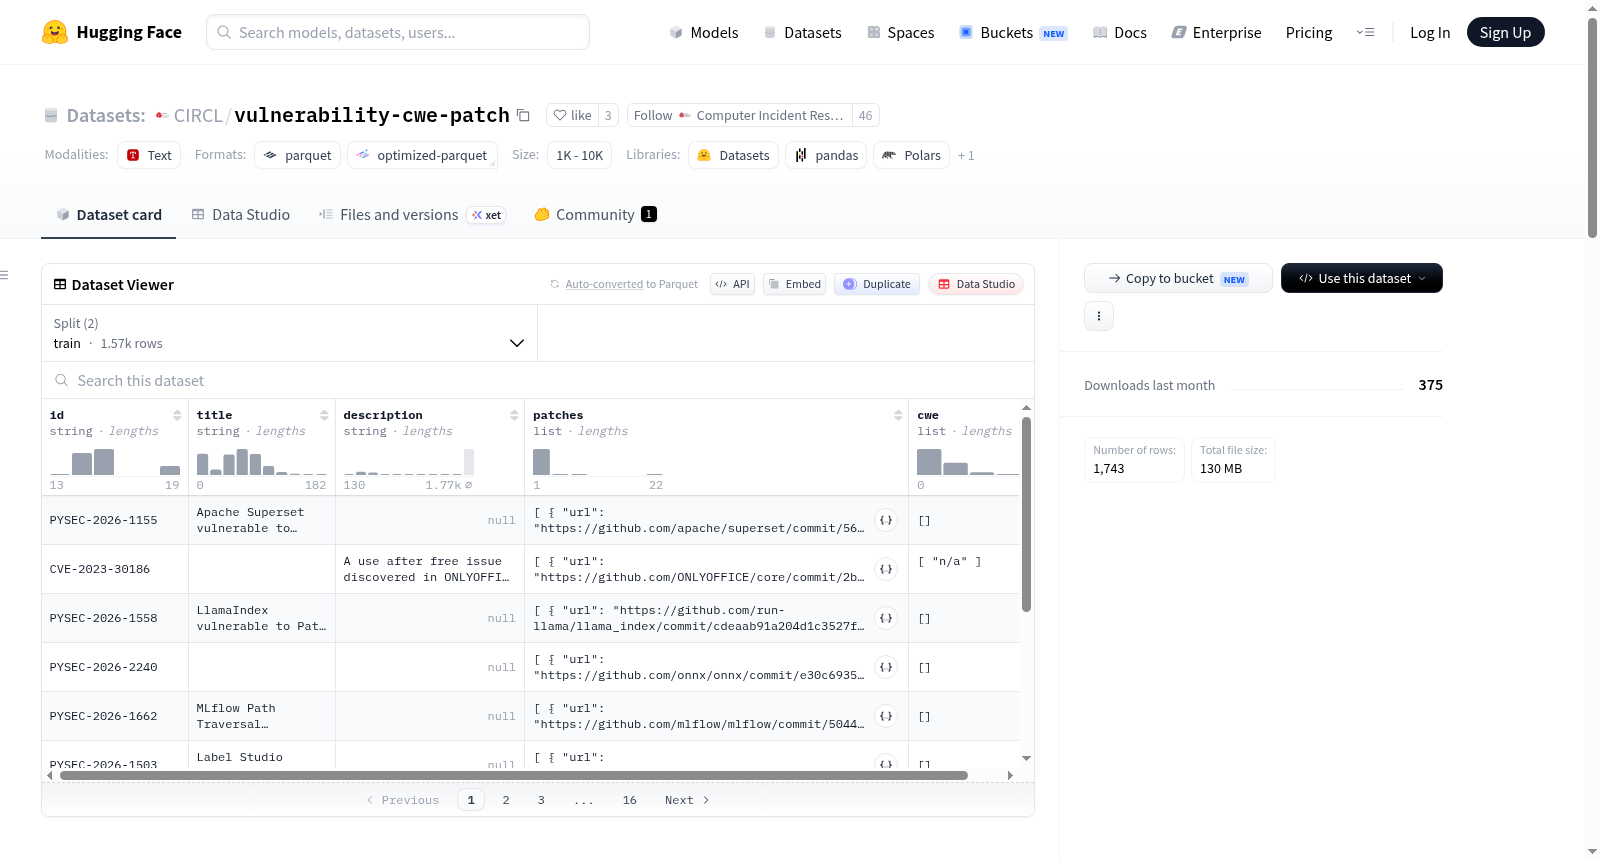
CIRCL/vulnerability-cwe-patch数据集提供了结构化的现实世界漏洞数据,其中包括CWE标识符和来自GitHub和GitLab等平台的实际补丁。该数据集旨在支持开发用于漏洞分类、筛选和自动修复的工具。每个条目包括漏洞标识符(如CVE/GHSA ID)、描述、CWE分类以及指向经过验证的补丁提交的链接,其中包含相应的diff内容和提交消息。
The CIRCL/vulnerability-cwe-patch dataset provides structured real-world vulnerability data, including CWE identifiers and actual patches from platforms like GitHub and GitLab. It was built to support the development of tools for vulnerability classification, triage, and automated repair. Each entry includes a vulnerability identifier (e.g., CVE/GHSA ID), a description, CWE categorization, and links to verified patch commits with associated diff content and commit messages.
提供机构:
CIRCL搜集汇总
数据集介绍
构建方式
本数据集源自对NVD CVE列表、GitHub安全公告(GHSA)、GitLab公告以及Red Hat、Cisco、CISA等厂商的CSAF馈送中漏洞记录的自动提取与整合。通过一套精密的管道流程,首先从多源获取漏洞条目,继而筛选出具备补丁的记录,并验证补丁链接的可访问性。随后提取补丁内容,经Base64编码后与提交信息一同存储,最终构建出包含39,260个漏洞及49,001个关联补丁的结构化数据集。
特点
该数据集的一大特色在于其丰富的结构化元数据,每条记录不仅涵盖漏洞标识符、标题与详细描述,还附带了经过验证的补丁链接、编码后的差异内容及提交信息。尤为重要的是,所有漏洞均标注了CWE标识符及名称,这为漏洞分类、自动化修复等任务提供了坚实的数据基础。数据集仅收录至少含有一个CWE标注的漏洞所对应的补丁,确保了高质量的监督学习样本。
使用方法
使用该数据集极为便捷,可通过Hugging Face的datasets库直接加载,仅需一行代码即可获取完整数据。用户可根据漏洞标识符(如CVE编号)对数据集进行过滤,精准提取目标条目。每条记录的patches字段下存储了补丁URL、Base64编码的差异文本及提交信息,便于开展漏洞分类、CWE预测、基于自然语言的补丁生成及提交信息理解等多种安全领域的机器学习任务。
背景与挑战
背景概述
在软件安全领域,通用漏洞披露(CVE)与通用弱点枚举(CWE)体系为漏洞管理提供了标准化框架,然而漏洞与补丁间的关联信息常分散于多个平台,难以系统化利用。由CIRCL(计算机事件响应中心卢森堡)主导并于近年构建的vulnerability-cwe-patch数据集,旨在填补这一空白,通过自动提取来自NVD、GitHub安全公告、GitLab公告及多家厂商CSAF源的结构化漏洞记录,并整合已验证的补丁链接与差异内容,形成首个大规模、多源的漏洞-补丁配对资源。该数据集包含约3.9万个漏洞与4.9万个补丁条目,其核心研究问题在于支撑漏洞分类、自动分级与智能修复任务的机器学习模型开发,对推动自动化安全运维与代码安全领域的发展具有显著影响力。
当前挑战
该数据集所应对的领域挑战在于:其一,漏洞描述与补丁之间存在语义鸿沟,传统方法难以从文本描述自动映射至修复代码,而此数据集通过配对补丁diff与提交信息,为跨模态理解提供了基础;其二,CWE标签的稀疏性与多标签噪声问题——部分漏洞仅有单一类别标注,且不同来源的CWE映射标准不一,增加了分类任务的复杂性。在构建过程中,挑战包括:从异构源(如CSAF、GitHub API)获取数据时的格式归一化与链接可用性验证,需设计稳健的过滤管道以剔除失效补丁链接;同时,补丁文本的base64编码虽利于存储,却增加了解码与序列化开销,影响大规模训练的效率。
常用场景
经典使用场景
在软件安全领域,'vulnerability-cwe-patch'数据集为构建智能化漏洞分析工具提供了关键支撑。其最经典的使用场景聚焦于漏洞分类与CWE预测任务:通过整合真实世界中数以万计的安全漏洞实例及其对应的标准化弱类型枚举(CWE)标识,研究者可基于包含详细描述和补丁信息的条目,训练机器学习模型自动完成漏洞类型的判别。该场景要求模型从自然语言描述中提取出与安全弱类型相关的语义特征,进而对未知漏洞进行准确归类,为后续的自动化修复奠定基础。
解决学术问题
该数据集有效回应了网络安全学术研究中若干关键难题,尤其是大规模漏洞的类型化认知鸿沟与缺乏高质量标签数据的困境。借助精心编排的、经多方验证的漏洞实例及附带的CWE标注与源代码补丁,研究者得以探索从自由文本描述到结构化弱类型的映射关系,推动自然语言处理与信息安全交叉领域的理论发展。此外,补丁文本的引入使模型能够进一步学习漏洞修复的范式,为自动化补丁生成与代码修复提供支撑,从而深化对软件安全漏洞内在机理的理解。
衍生相关工作
该数据集催生了一系列富有影响力的研究工作,尤其是在基于神经网络的漏洞表征与自动修复方向。经典衍生工作包括基于Transformer架构构建的漏洞文本分类器,以及利用检索增强生成(RAG)实现面向CWE的候选补丁推荐系统。此外,研究者还以此为基础探索了多任务学习框架,同时解决CWE预测与补丁生成两种任务,在统一模型中融合语义理解与代码修正能力。补丁文本的时序关联也为研究人员提供了探究漏洞生命周期演化与修复习惯的独特视角,相关成果进一步优化了自动化安全系统在实际生产环境中的适应性与可靠性。
以上内容由遇见数据集搜集并总结生成


