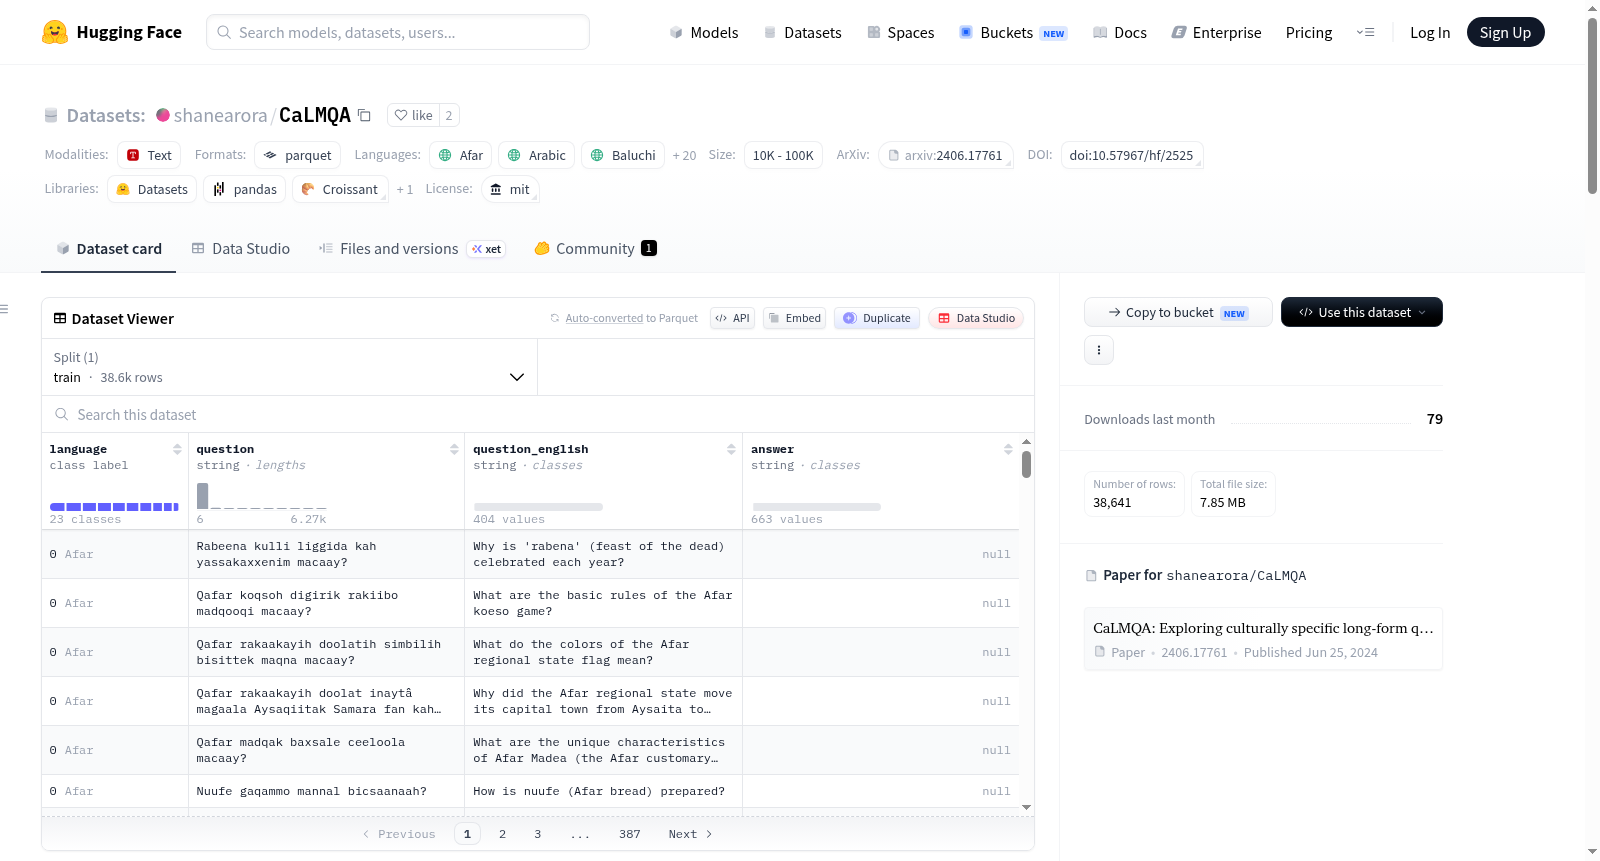
shanearora/CaLMQA
收藏资源简介:
CaLMQA是一个包含23种高资源到低资源语言的长形式问答(LFQA)数据集,包含2000个问题。问题分为文化特定问题和文化无关问题,文化特定问题是由特定文化背景的人提出的,而文化无关问题则是从英语翻译到其他语言的。数据集的结构包括语言、问题类型、问题、问题的英文翻译和答案。数据集的创建过程涉及从多个网站收集高资源到中资源语言的问题,以及通过众包工人编写低资源语言的问题。数据集的使用目的是评估最先进模型的多语言能力和文化知识。
CaLMQA is a long-form question answering (LFQA) dataset covering 23 languages ranging from high-resource to low-resource, containing a total of 2000 questions. The questions are categorized into culture-specific and culture-agnostic types. Culture-specific questions are formulated by people with specific cultural backgrounds, while culture-agnostic questions are translated from English into other target languages. The dataset consists of fields including language, question type, original question, English translation of the question, and the corresponding answer. The dataset construction process involves collecting questions for high-resource to mid-resource languages from multiple websites, and generating questions for low-resource languages via crowdsourced workers. The dataset is designed to evaluate the multilingual capabilities and cultural knowledge of state-of-the-art models.
数据集概述
CaLMQA是一个长形式问答(LFQA)数据集,涵盖23种高资源到低资源语言。
数据集详情
数据集描述
CaLMQA包含23种语言的2000个问题,其中11种为高资源到中资源语言,12种为低资源语言。问题分为文化特定和文化无关两种类型,用于评估最先进模型的多语言能力和文化知识。
语言分类
- 高资源到中资源语言: 阿拉伯语、中文、英语、德语、印地语、希伯来语、匈牙利语、日语、韩语、俄语、西班牙语
- 低资源语言: 阿法尔语、俾路支语、法罗语、斐济语、希利盖农语、基隆迪语、帕皮阿门托语、普什图语、萨摩亚语、汤加语、茨瓦纳语、沃洛夫语
许可证
MIT许可证
数据集结构
数据集包含以下字段:
language:问题的语言question_type:问题的类型,分为文化特定或文化无关question:问题的原文question_english:问题的英文翻译answer(可选):问题的答案
数据创建
源数据
- 文化特定问题: 低资源语言的问题由雇佣的众包工作者手动编写。高资源到中资源语言的问题来自特定社区问答网站。
- 文化无关问题: 所有文化无关问题从英语翻译而来,源数据来自Reddit ELI5。
数据收集和处理
- 高资源到中资源语言: 通过调查收集社区问答网站,然后雇佣工作者从这些网站收集长形式的文化特定问题。
- 低资源语言: 指导工作者编写文化特定问题。
源数据生产者
所有工作者均为所收集问题语言的母语者,并具备英语能力。工作者来自Prolific和UpWork平台。
个人和敏感信息
问题主题包括宗教、政治和历史,可能涉及敏感问题。在工作者指南中明确指出收集的问题不应具有争议性,并进行了人工审查。
偏见、风险和限制
从社区问答网站收集的问题可能反映这些社区的社会偏见,并可能未充分代表这些问答论坛中未涵盖的文化。工作者编写的问题可能带有工作者自身的偏见。