reddit-animal-discourse-2020-present
收藏资源简介:
Reddit动物相关讨论语料库(2020年至今)是一个从Reddit平台动物相关子版块收集的文本数据集,涵盖提交(帖子)和评论。该数据集是研究AI介导的价值锁定在人类动物福利话语中的一部分而构建的。数据通过PullPush.io收集,时间范围从2020年1月持续至今(截至2025年5月19日)。数据集总规模为889,110条记录,覆盖了六个子版块:r/AnimalRights、r/AntiVegan、r/AskVegans、r/PlantBasedDiet、r/vegan和r/vegetarian,各版块的提交数和评论数均有详细统计。数据按子版块和内容类型(提交或评论)组织为Parquet文件。提交字段包括id、标题、正文、作者、创建时间、分数、评论数等;评论字段包括id、正文、作者、父ID、链接ID等。子版块的选择旨在覆盖动物伦理立场的频谱:支持动物(如r/vegan、r/AnimalRights)、辩论/混合(如r/DebateAVegan、r/AskVegans)、怀疑/反对(如r/exvegan、r/AntiVegan)以及相关主题(如r/wildlife)。原始文本内容公开,但为保护隐私,用户名已通过SHA-256加盐哈希处理(截断为12位十六进制字符,前缀为user_),以移除个人身份信息,同时保留同一用户跨记录的分析能力。数据集适用于文本分类、话语分析、价值观研究等任务,仅限非商业研究使用。
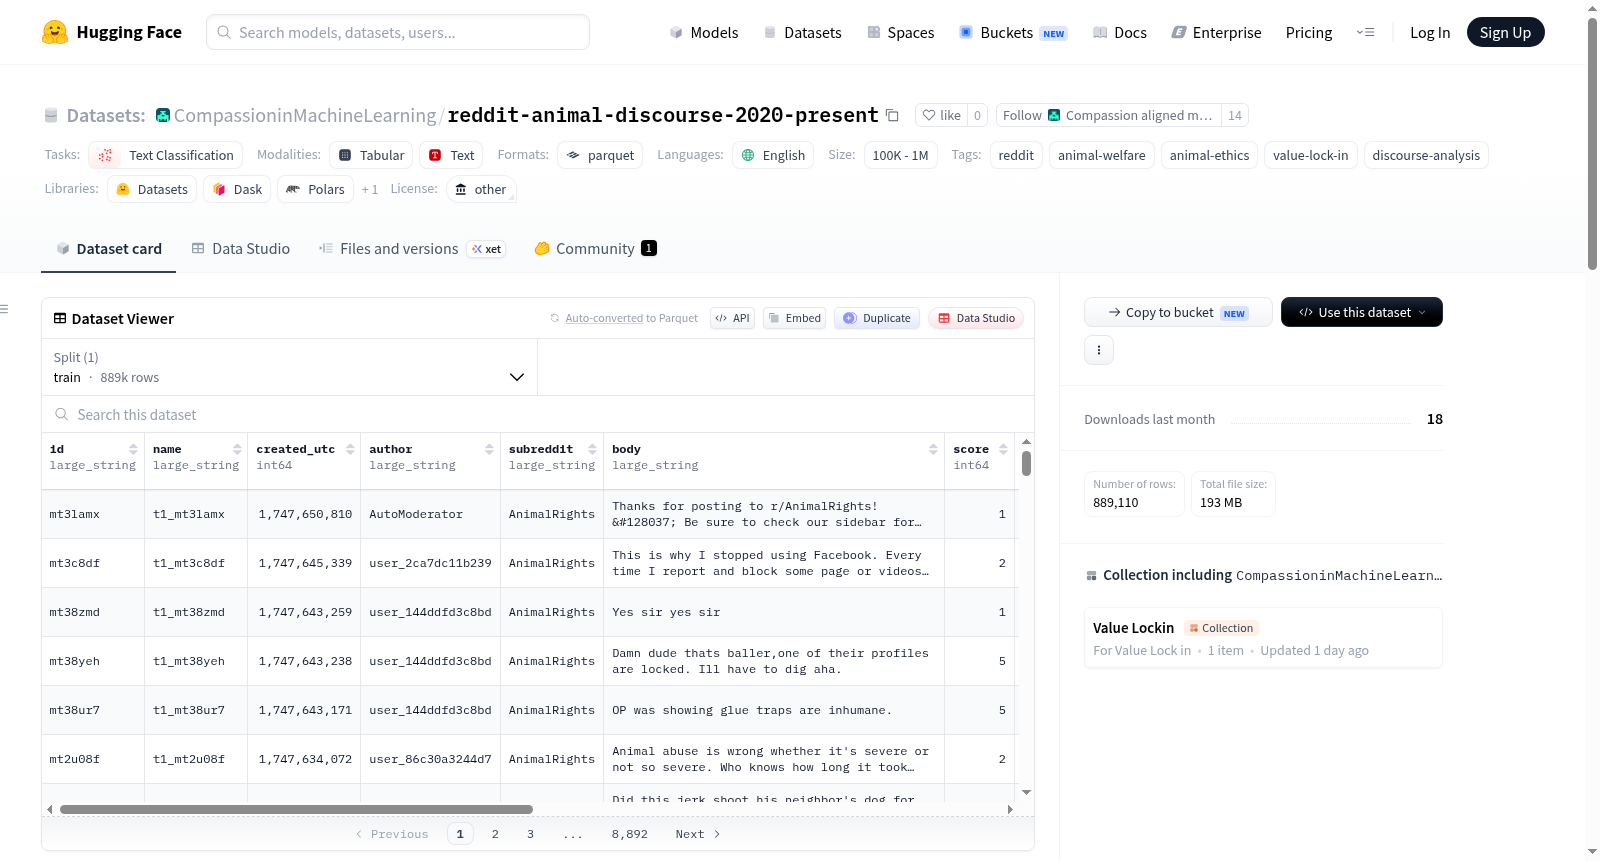
The Reddit Animal-Related Discussion Corpus (2020–Present) is a text dataset collected from animal-related subreddits on the Reddit platform, covering submissions (posts) and comments. This corpus was constructed as part of research on AI-mediated value entrenchment in human animal welfare discourse. The data was collected via PullPush.io, with a time range spanning from January 2020 to the present (as of May 19, 2025). The total size of the dataset is 889,110 records, covering six subreddits: r/AnimalRights, r/AntiVegan, r/AskVegans, r/PlantBasedDiet, r/vegan, and r/vegetarian, with detailed statistics available for the number of submissions and comments in each subreddit. The dataset is organized into Parquet files by subreddit and content type (submission or comment). Submission fields include id, title, body, author, creation time, score, number of comments, and more; comment fields include id, body, author, parent ID, link ID, and more. The selection of subreddits aims to cover the spectrum of animal ethical stances: pro-animal (e.g., r/vegan, r/AnimalRights), debate/mixed (e.g., r/DebateAVegan, r/AskVegans), skeptical/oppositional (e.g., r/exvegan, r/AntiVegan), and related topics (e.g., r/wildlife). The raw text content is publicly available, but to protect privacy, usernames have been salted and hashed using SHA-256, truncated to 12 hexadecimal characters and prefixed with "user_", to remove personally identifiable information while retaining the ability to analyze the same user across multiple records. This corpus is applicable to tasks such as text classification, discourse analysis, and values research, and is restricted to non-commercial research use only.
数据集概要
- 名称: Reddit Animal-Discourse Corpus (2020–present)
- 语言: 英文
- 规模: 1M < n < 10M 条记录,总计 889,110 条
- 任务类型: 文本分类
- 许可证: 非商业研究用途(Reddit 用户内容条款适用)
数据来源与时间范围
- 通过 PullPush.io 收集自 2020 年 1 月至今的 Reddit 动物相关子版块帖文与评论。
- 覆盖以下子版块及其数据量:
| 子版块 | 帖文数 | 评论数 | 帖文日期范围 |
|---|---|---|---|
| r/AnimalRights | 18,293 | 5,193 | 2020-01-01 → 2025-05-19 |
| r/AntiVegan | 21,365 | 171,450 | 2020-01-01 → 2025-05-19 |
| r/AskVegans | 5,167 | 127,895 | 2020-01-01 → 2025-05-19 |
| r/PlantBasedDiet | 26,629 | 97,582 | 2020-01-01 → 2025-05-19 |
| r/vegan | 93,272 | 228,490 | 2022-12-03 → 2025-05-19 |
| r/vegetarian | 46,481 | 47,293 | 2020-01-01 → 2025-05-19 |
文件结构
- 每个子版块与数据类型(帖文/评论)对应一个 Parquet 文件,命名格式如
AntiVegan__submission.parquet。 - 帖文字段: id, name, created_utc, author, subreddit, title, selftext, url, score, num_comments, upvote_ratio, link_flair_text, permalink, is_self, over_18, spoiler, stickied, created_date
- 评论字段: id, name, created_utc, author, subreddit, body, score, parent_id, link_id, permalink, is_submitter, stickied, created_date
子版块分类
- 支持动物权益: r/vegan, r/AnimalRights, r/vegetarian, r/PlantBasedDiet
- 辩论/混合: r/DebateAVegan, r/AskVegans
- 怀疑/反对: r/exvegan, r/AntiVegan, r/carnivore
- 相邻领域: r/wildlife, r/conservation
伦理与隐私处理
- 用户名经过加盐哈希处理(SHA-256,项目特定盐值,截断为 12 位十六进制字符,前缀
user_),移除个人可识别信息(PII),同时保留同一用户跨记录分析能力。 - 保留
[deleted]、[removed]、AutoModerator等标识符。 - 内容为抓取时的快照,可能不同于当前 Reddit 状态。
引用
- 引用出处将后续补充(研究待发布)。