遇见数据集

ancient_greek_theatre

收藏
Hugging Face2024-07-28 更新2024-12-12 收录
官方服务:

资源简介:

该数据集包含24部古希腊戏剧的现代希腊语翻译,这些戏剧由阿里斯托芬、欧里庇得斯、埃斯库罗斯和索福克勒斯创作。数据集的收集过程包括在openbook.gr上寻找免费的现代希腊语翻译,使用pdfly提取PDF文件中的文本,并通过vim和vimscript进行多轮手动和自动清理。最后,通过uconv应用NFKD规范化,得到一个非常干净(尽管不完美)的24部古希腊戏剧集合。

This dataset contains Modern Greek translations of 24 ancient Greek plays written by Aristophanes, Euripides, Aeschylus, and Sophocles. The dataset collection process involved searching openbook.gr for free Modern Greek translations, extracting text from PDF files using pdfly, conducting multiple rounds of manual and automated cleanup via Vim and Vimscript, and finally applying NFKD normalization via uconv to produce a highly clean (though imperfect) collection of these 24 ancient Greek plays.

创建时间:
2024-07-28
原始信息汇总

Ancient Greek Theatre 数据集概述

数据集信息

  • 特征:

    • 名称: text
    • 数据类型: string
  • 分割:

    • 训练集 (train):
      • 字节数: 2173017
      • 样本数: 18
    • 验证集 (val):
      • 字节数: 183032
      • 样本数: 2
    • 测试集 (test):
      • 字节数: 359226
      • 样本数: 4
  • 下载大小: 1360491 字节

  • 数据集大小: 2715275 字节

  • 配置:

    • 配置名称: default
    • 数据文件:
      • 训练集路径: data/train-*
      • 验证集路径: data/val-*
      • 测试集路径: data/test-*
  • 许可证: MIT

  • 任务类别: 文本生成

  • 语言: 希腊语

  • 数据集名称: Ancient Greek Theatre

搜集汇总
数据集介绍
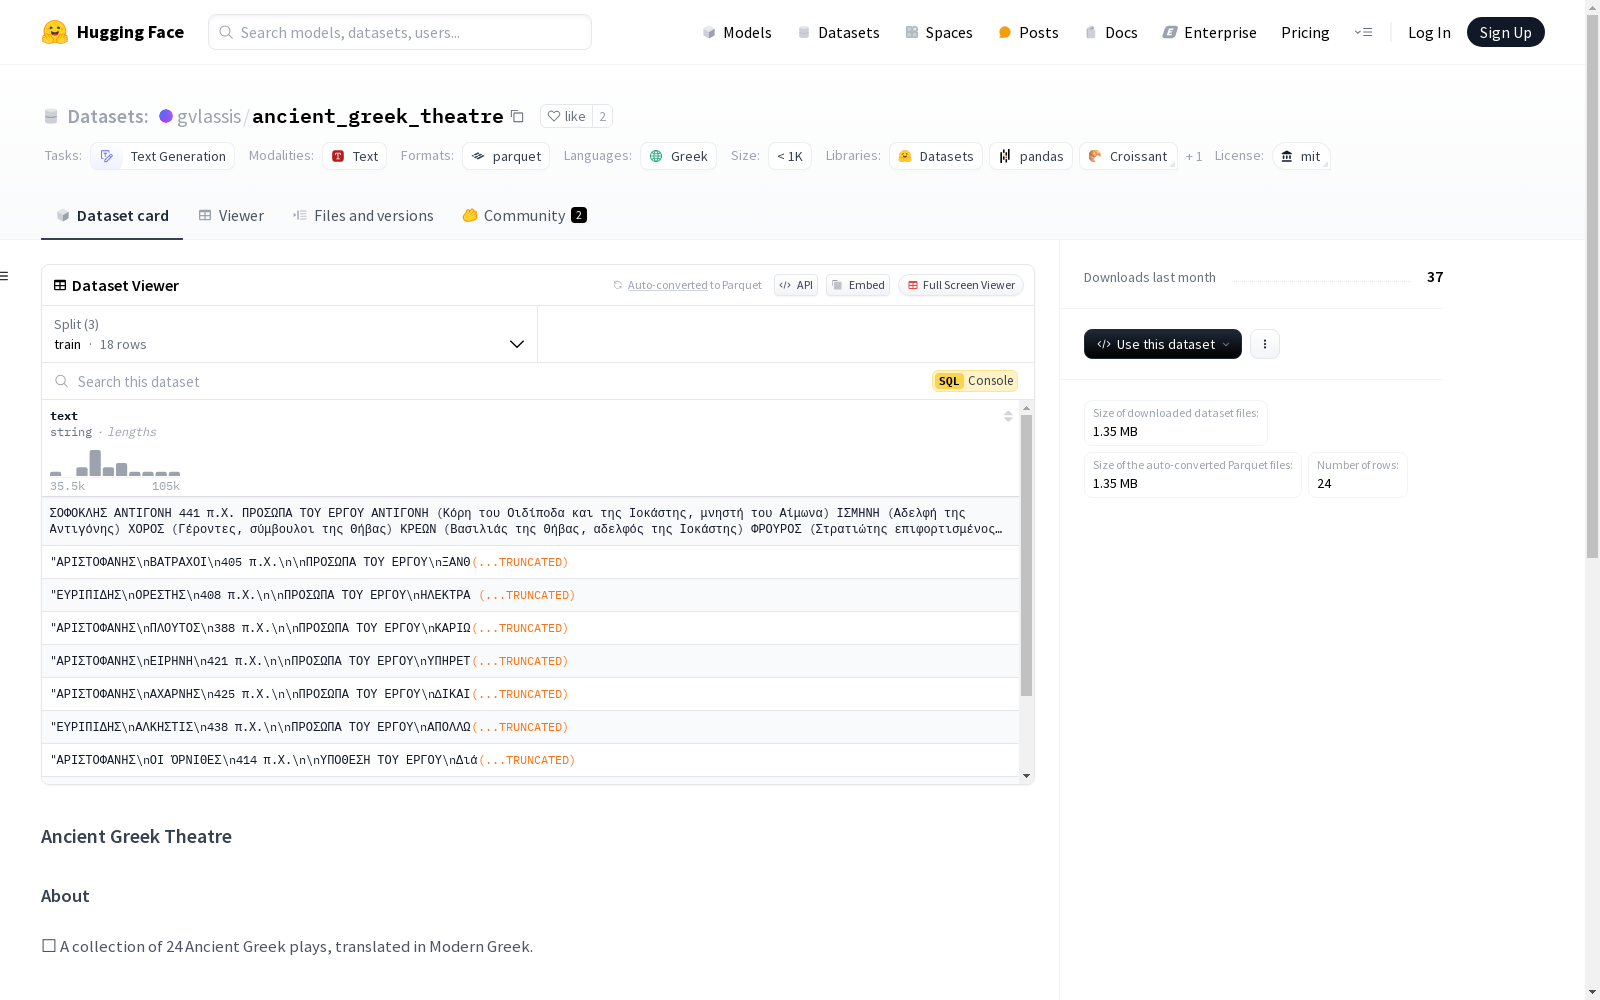
ancient_greek_theatre 数据集图片
构建方式
该数据集的构建过程始于从[openbook.gr](https://www.openbook.gr/)网站收集古希腊戏剧的现代希腊语翻译PDF文件。随后,使用[pdfly](https://github.com/py-pdf/pdfly)工具提取文本,并通过vim和vimscript进行多轮手动和自动清理。缺失的部分(如角色、情节)从维基百科补充,最终通过[uconv](https://linux.die.net/man/1/uconv)工具进行NFKD规范化处理,确保文本的整洁性。这一过程虽繁琐,但确保了数据的高质量。
特点
该数据集包含了24部古希腊戏剧的现代希腊语翻译,涵盖了阿里斯托芬、欧里庇得斯、埃斯库罗斯和索福克勒斯等著名剧作家的作品。数据集以文本形式存储,分为训练集、验证集和测试集,分别包含18、2和4个样本。尽管数据集规模较小,但其高度清洁的文本质量使其成为研究古希腊戏剧和现代希腊语语言模型的宝贵资源。
使用方法
使用该数据集时,可通过Hugging Face的`datasets`库轻松加载。用户只需调用`datasets.load_dataset("gvlassis/ancient_greek_theatre")`即可获取数据集。该数据集适用于文本生成任务,尤其适合用于训练和评估语言模型,以生成类似于古希腊剧作家的文本。通过这种方式,研究者可以深入探索古希腊戏剧的语言风格和文化内涵。
背景与挑战
背景概述
Ancient Greek Theatre数据集是一个专注于古希腊戏剧的文本生成数据集,包含了24部古希腊戏剧的现代希腊语翻译。该数据集由个人研究者gvlassis创建,灵感来源于Tiny Shakespeare和shakespearefirstfolio数据集,旨在为古希腊戏剧的文本生成任务提供高质量的语料。数据集中的戏剧作品涵盖了古希腊著名剧作家如阿里斯托芬、欧里庇得斯、埃斯库罗斯和索福克勒斯的经典作品。通过手动和自动化的文本清理与预处理,数据集在保持文本原貌的同时,确保了数据的整洁性和可用性。该数据集的发布为古希腊文学研究、自然语言处理以及跨语言文本生成领域提供了宝贵的资源。
当前挑战
Ancient Greek Theatre数据集在构建过程中面临了多重挑战。首先,古希腊戏剧的现代希腊语翻译资源较为稀缺,且分布零散,数据收集过程耗时且复杂。其次,原始文本的格式多样,尤其是从PDF文件中提取文本时,常常伴随格式混乱和字符编码问题,需要通过多轮手动和自动化清理来确保数据质量。此外,部分文本存在缺失或错误,需依赖外部资源如维基百科进行补充和修正。在技术层面,数据集的规模较小,仅包含24部戏剧,这对训练大规模语言模型提出了挑战,尤其是在生成高质量文本时,模型可能面临过拟合或泛化能力不足的问题。
常用场景
经典使用场景
在古典文学与语言学研究中,ancient_greek_theatre数据集为学者提供了一个独特的资源,用于探索古希腊戏剧的语言风格和叙事结构。通过分析这些戏剧的现代希腊语翻译,研究者能够深入理解古希腊文化的表达方式及其对后世文学的影响。
解决学术问题
该数据集解决了古典文学研究中文本稀缺的问题,特别是对于古希腊戏剧的现代希腊语翻译。它为语言模型训练提供了高质量的数据,使得研究者能够在缺乏大量原始文本的情况下,依然能够进行有效的文本生成和分析。
衍生相关工作
基于ancient_greek_theatre数据集,研究者已经开发出多种文本生成模型,这些模型能够模仿古希腊戏剧家的写作风格。此外,该数据集也激发了关于古典文学与现代技术结合的新研究领域,如使用机器学习技术进行文本修复和风格迁移。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务