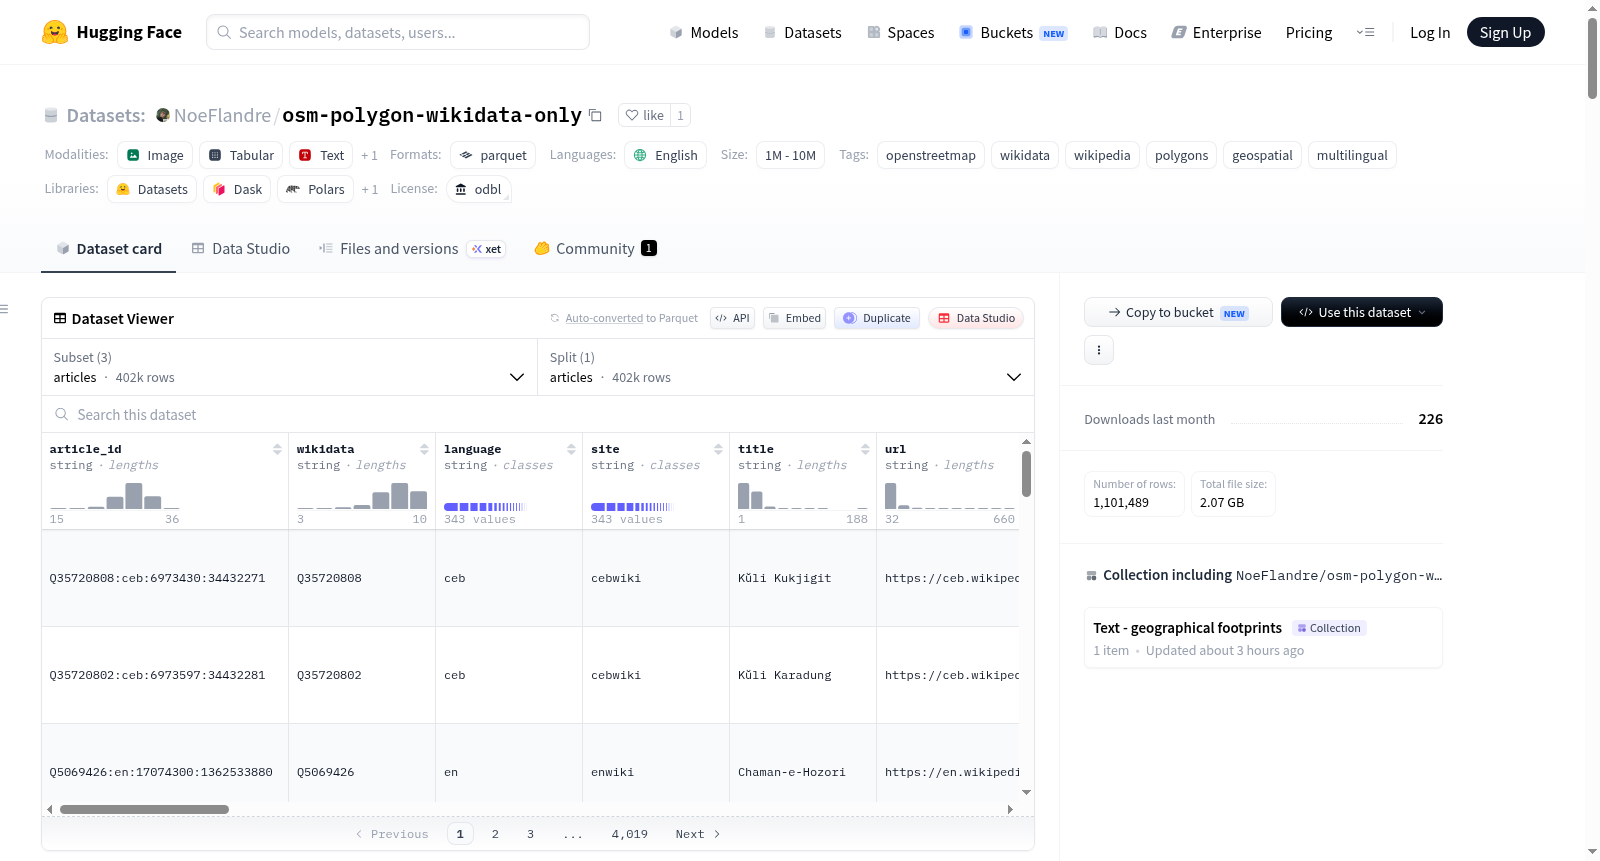
osm-polygon-wikidata-only
收藏资源简介:
该数据集整合了OpenStreetMap(OSM)多边形数据、Wikidata实体描述和多语言维基百科文章文本,专为地理空间与多语言自然语言处理研究设计。数据集包含三个核心部分:1)polygons表存储带有wikidata=*标签的OSM多边形要素,包含几何信息、标签属性和中心点坐标;2)articles表收录与Wikidata实体关联的维基百科文章,涵盖343种语言,包含文章标题、全文内容、元数据和提取状态;3)polygon_articles表作为连接表,记录多边形与文章之间的多对多关联关系。数据集规模包括229,967个多边形、214,230个唯一Wikidata实体和356,839篇维基百科文章,覆盖58个地理区域,总单词数超过1.32亿。数据来源遵循开放许可:OSM数据采用ODbL 1.0,Wikidata采用CC0 1.0,维基百科文章采用CC BY-SA 4.0。该数据集适用于地理信息检索、多语言文本分析、实体链接、知识图谱构建等任务,特别适合需要结合空间几何与多语言文本描述的研究场景。
This dataset integrates OpenStreetMap (OSM) polygon data, Wikidata entity descriptions, and multilingual Wikipedia article texts, and is specifically designed for geospatial and multilingual natural language processing research. The dataset consists of three core components: 1) The `polygons` table stores OSM polygon features tagged with `wikidata=*`, including geometric information, tag attributes, and centroid coordinates; 2) The `articles` table includes Wikipedia articles associated with Wikidata entities, covering 343 languages, and contains article titles, full text content, metadata, and extraction status; 3) The `polygon_articles` table serves as a junction table that records the many-to-many association relationships between polygons and articles. The dataset has a scale of 229,967 polygons, 214,230 unique Wikidata entities, and 356,839 Wikipedia articles, covering 58 geographic regions, with a total word count exceeding 132 million. The data sources follow open licenses: OSM data is licensed under ODbL 1.0, Wikidata under CC0 1.0, and Wikipedia articles under CC BY-SA 4.0. This dataset is applicable to tasks such as geographic information retrieval, multilingual text analysis, entity linking, and knowledge graph construction, and is particularly suitable for research scenarios that require the combination of spatial geometry and multilingual textual descriptions.
数据集概述:NoeFlandre/osm-polygon-wikidata-only
该数据集包含带有 wikidata=* 标签的 OpenStreetMap(OSM)多边形,并附有 Wikidata 描述和每个有效语言版本 Wikipedia 文章的全文,无文章数量上限。
核心数据规模
| 指标 | 数值 |
|---|---|
| 多边形数量 | 258,112 |
| 唯一 Wikidata 实体数 | 241,700 |
| Wikipedia 文章数 | 401,848 |
| 多边形-文章关联数 | 441,529 |
| 覆盖语言数 | 343 种 |
| 地理区域数 | 68 个 |
| 总词数 | 150,063,220 |
| 数据集磁盘大小 | 1.9 GB |
Wikipedia 覆盖漏斗
| 阶段 | 数量 | 占多边形比例 |
|---|---|---|
| 全量多边形 | 258,112 | 100.0% |
| 拥有 ≥1 篇文章 | 130,597 | 50.6% |
| 拥有非空文本 | 130,596 | 50.6% |
| 拥有英文覆盖 | 35,872 | 13.9% |
| 无英文但有其他语言 | 94,725 | 36.7% |
| 拥有 2+ 种语言 | 51,858 | 20.1% |
| 拥有 5+ 种语言 | 18,627 | 7.2% |
| 拥有 10+ 种语言 | 8,313 | 3.2% |
语言分布(按文章数量排名前20)
| 语言 | 文章数 | 占比 | 多边形数量 |
|---|---|---|---|
| 德语 (de) | 47,921 | 11.9% | 50,931 |
| 英语 (en) | 32,440 | 8.1% | 35,872 |
| 宿务语 (ceb) | 28,224 | 7.0% | 28,862 |
| 法语 (fr) | 26,507 | 6.6% | 29,131 |
| 西班牙语 (es) | 18,070 | 4.5% | 19,711 |
| 埃及阿拉伯语 (arz) | 13,612 | 3.4% | 14,096 |
| 荷兰语 (nl) | 11,991 | 3.0% | 12,997 |
| 加泰罗尼亚语 (ca) | 11,529 | 2.9% | 12,176 |
| 瑞典语 (sv) | 10,540 | 2.6% | 11,157 |
| 俄语 (ru) | 9,580 | 2.4% | 10,391 |
数据文件结构
数据集包含三个核心 Parquet 文件,另附可选增强文件:
1. polygons/*.parquet
每行对应一个多边形,包含以下字段:
- 标识列:
polygon_id(确定性 ID)、source_pbf、osm_type、osm_id、wikidata(Q-id) - 属性列:
name、tags(JSON)、tag_keys、tag_count、osm_primary_tag - 空间列:
centroid(GeoJSON Point)、lat、lon、bbox、geometry(完整 GeoJSON)、area_m2、area_km2、area_bucket - 标记列:
has_name、has_wikidata、has_wikipedia、wikipedia_language_count、wikipedia_languages、wikipedia_article_count、has_english_wikipedia、has_french_wikipedia、text_available、best_language - 元数据列:
extraction_version、extracted_at
2. articles/*.parquet
每行对应一篇唯一的 Wikipedia 文章,包含以下字段:
- 标识列:
article_id(确定性 ID)、wikidata、language、site、title、url、page_id、revision_id - 时间列:
revision_timestamp、retrieved_at - 文本列:
wikidata_label、wikidata_description、wikidata_aliases、lead_text、extract、full_text(全文)、full_text_format、article_length_chars、article_length_words、article_length_tokens_estimate - 媒体/分类列:
thumbnail_url、thumbnail_width、thumbnail_height、categories - 来源/状态列:
license、attribution、source_api、fetch_status、fetch_error、content_hash
3. polygon_articles/*.parquet
多对多关联表,包含字段:polygon_id、article_id、wikidata、language、source_pbf、region、osm_type、osm_id、page_id、revision_id、is_best_language
可选增强文件(不替换核心表)
wikipedia/documents/*.parquet和wikipedia/sections/*.parquetwikivoyage/documents/*.parquet和wikivoyage/sections/*.parquetwikidata/facts/*.parquet
数据来源与许可
- OpenStreetMap 多边形:(c) OpenStreetMap 贡献者,许可协议 ODbL 1.0
- Wikidata 实体数据:CC0 1.0
- Wikipedia 文章文本:CC BY-SA 4.0,归属信息内嵌于每条文章记录
加载方式(Python)
python from datasets import load_dataset ds = load_dataset("parquet", data_files={ "polygons": "hf://datasets/NoeFlandre/osm-polygon-wikidata-only/polygons/*.parquet", })
维护信息
- 数据集生成日期:2026-07-11
- 维护者:Noé Flandre