
遇见数据集

SOMOS

收藏
arXiv2022-08-24 更新2024-06-21 收录
官方服务:

资源简介:

SOMOS数据集是由三星电子希腊Innoetics团队创建的,专注于神经文本到语音合成评估的大规模数据集。该数据集包含20,100条由200个不同神经TTS系统生成的合成语音样本,使用LPCNet作为统一的声码器以确保样本变化仅由声学模型决定。数据集涵盖了广泛的领域和长度,旨在通过收集的MOS自然度评价,推动自动MOS预测系统的研究。该数据集通过亚马逊Mechanical Turk平台进行大规模的MOS测试,收集了395,318个评价,其中359,380个与合成语音相关。SOMOS数据集的应用领域主要集中在提升TTS系统的评估方法,特别是在单个说话人场景下,快速评估新TTS系统的想法。

The SOMOS dataset was created by the Samsung Electronics Greece Innoetics team, serving as a large-scale resource dedicated to the evaluation of neural text-to-speech (TTS) synthesis. This dataset contains 20,100 synthetic speech samples generated by 200 distinct neural TTS systems, where LPCNet was adopted as a unified vocoder to ensure that all variations across the samples are solely determined by their respective acoustic models. The dataset covers a wide range of domains and utterance lengths, and aims to promote research on automatic mean opinion score (MOS) prediction systems through the collected naturalness MOS ratings. Large-scale MOS tests were conducted on the Amazon Mechanical Turk platform for this dataset, yielding a total of 395,318 ratings, among which 359,380 are associated with synthetic speech. The primary applications of the SOMOS dataset focus on improving TTS system evaluation methodologies, particularly for rapidly assessing new TTS systems in single-speaker scenarios.
提供机构:
三星电子,希腊
创建时间:
2022-04-07
搜集汇总
数据集介绍
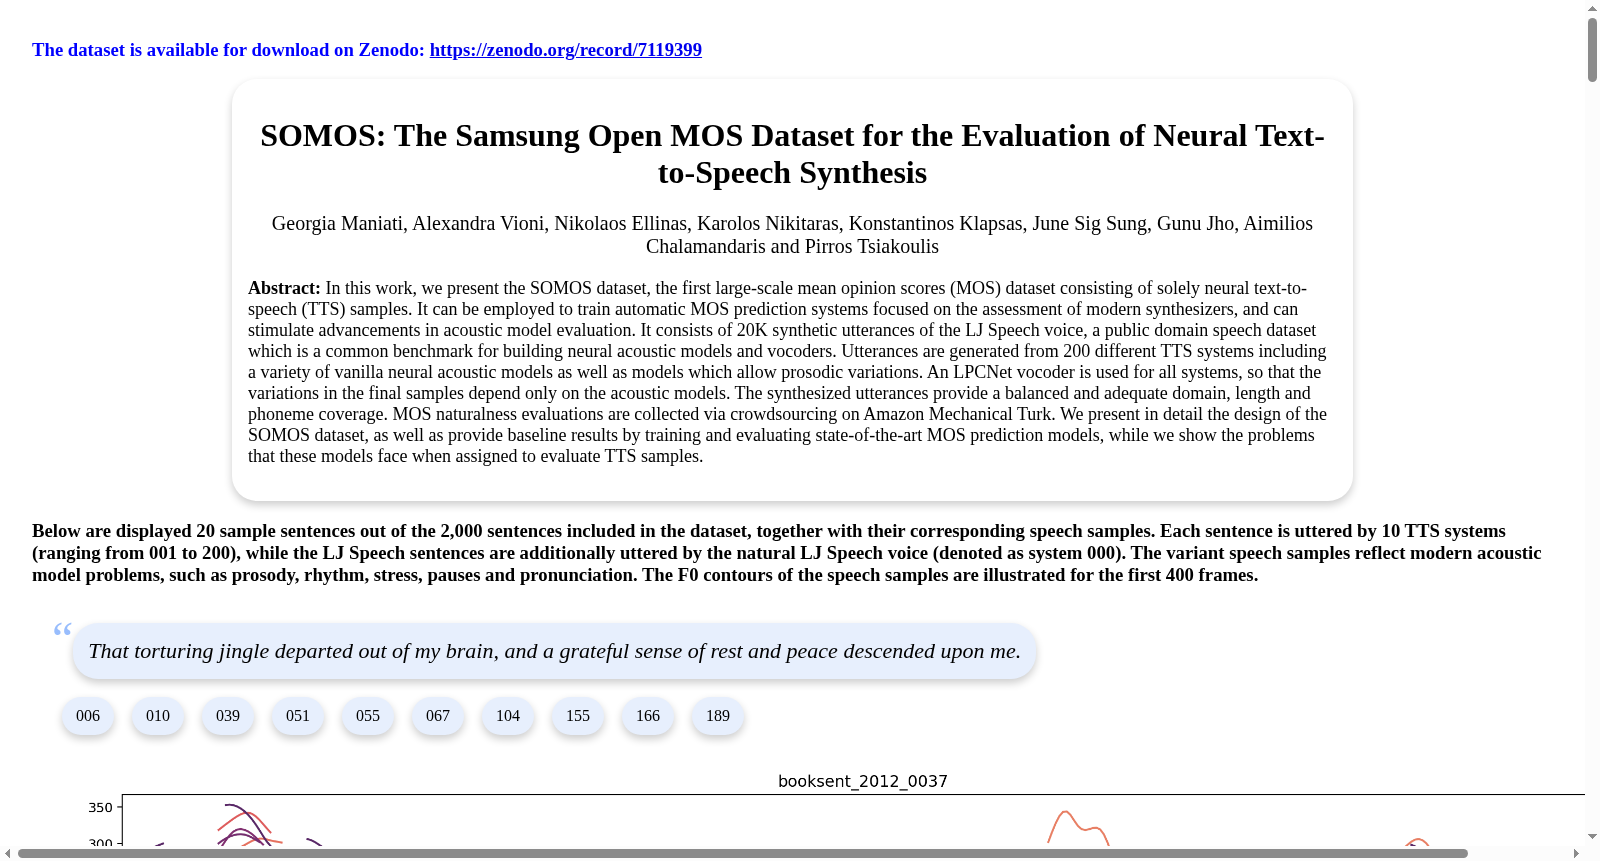
SOMOS 数据集图片
构建方式
SOMOS数据集专为评估神经文本转语音合成系统而设计,是首个大规模仅包含神经TTS样本的平均意见得分数据集。数据构建基于LJ Speech语音库,从200个TTS系统中生成2万条合成话语,这些系统涵盖标准注意力机制模型、非注意力Tacotron模型、融入句法线索的增强架构、基于ToBI韵律标注的变体、无监督风格建模系统以及可控韵律特征模型。所有系统均采用LPCNet声码器以确保样本差异仅源于声学模型。推理语料包含2000个句子,覆盖对话、新闻、小说等多元领域,句子长度从3到38个单词不等,确保语言内容、长度和音素的均衡覆盖。
特点
该数据集的核心特点在于其聚焦于神经TTS声学模型的韵律自然性评估,通过固定声码器消除信号质量干扰,使MOS评分真实反映韵律适切性。数据规模达39.5万条众包评分,涵盖美国、英国和加拿大三个英语区域,并包含专家标注作为基准。数据集提供完整版和清洁版两种子集,后者通过验证问题、自然样本对照、评分一致性检测等质量控制手段过滤可疑标注,显著提升评分可靠性。系统级评分与专家判断的斯皮尔曼相关系数高达0.90,验证了众包数据的有效性。
使用方法
SOMOS数据集适用于训练和评估自动MOS预测模型,尤其针对神经TTS系统的声学模型评估场景。研究者可采用论文提供的70%-15%-15%训练-验证-测试划分,确保系统、听者和文本均未在训练集中出现。基线实验表明,SSL-MOS模型在清洁版数据集上表现最优,系统级斯皮尔曼相关系数达0.947,但话语级评分仍面临挑战,凸显当前模型在评估韵律变异合成话语时的局限性。该数据集为开发与人类评估更相关的话语级TTS评估模型提供了关键资源。
背景与挑战
背景概述
在神经语音合成领域,主观平均意见得分(MOS)测试一直是评估合成语音自然度的黄金标准,然而其高昂的人力成本与时间开销促使研究者探索自动化的MOS预测方法。SOMOS数据集由三星电子旗下Innoetics团队于2022年发布,旨在填补现有公开数据集中缺乏纯神经TTS样本的空白。该数据集包含20,000条由200个基于Tacotron架构的神经TTS系统生成的合成语音样本,所有样本均采用统一的LPCNet声码器,从而将质量差异聚焦于声学模型的韵律表现。通过收集来自美国、英国和加拿大三个英语地区的395,318条众包评分,SOMOS成为首个大规模、专用于神经TTS自然度评估的开源数据集,为训练针对现代合成器的MOS预测模型提供了关键资源,推动了声学模型评估技术的进步。
当前挑战
SOMOS数据集面临的核心挑战在于解决当前MOS预测模型在语句级评估上的局限性。尽管系统级评分相关性较高,但现有模型(如MOSNet、LDNet和SSL-MOS)在语句级预测中表现欠佳,这源于合成语音的韵律细微差异(如重音、语调模式)难以通过帧级声学特征捕捉。此外,数据构建过程中也遭遇多重困难:首先,跨地域众包评分的可靠性参差不齐,美国地区近半数任务存在潜在不可靠响应,需设计验证题与黄金标准样本进行筛选;其次,确保200个系统在韵律多样性上的覆盖度,需通过显式(如ToBI标注)与隐式(如句法线索)方式调控参数,同时避免声码器质量对评分的干扰;最后,数据集仅包含单说话人(LJ Speech)样本,限制了模型对多说话人场景的泛化能力。
常用场景
经典使用场景
在神经语音合成领域,SOMOS数据集被广泛用于训练和评估自动平均意见分(MOS)预测模型。该数据集由纯神经TTS系统生成的语音样本及其对应的主观自然度评分构成,为研究者提供了一个标准化、大规模且高质量的基准资源。其经典使用场景包括:基于深度学习的非侵入式语音质量评估模型的开发与验证,尤其是针对现代神经合成器在韵律变化、语调自然度等方面的表现进行细粒度评价。通过该数据集,研究者能够训练出更贴合人类听觉感知的MOS预测系统,从而替代昂贵且耗时的人工主观测试,推动语音合成评估方法的自动化与客观化。
衍生相关工作
SOMOS数据集的发布催生了一系列经典衍生工作。首先,基于该数据集,研究者提出了多种改进的MOS预测架构,如融合自监督学习特征的SSL-MOS模型,其在句级评估上的性能显著优于传统方法。其次,SOMOS被用作VoiceMOS Challenge等国际竞赛的基准数据集,推动了跨系统、跨语种的语音质量评估方法研究。此外,该数据集还启发了针对韵律建模的专项工作,例如通过分析SOMOS中不同韵律参数(如重音、节奏、停顿)对MOS评分的影响,学者们开发了更精细的韵律可控TTS模型。这些工作不仅深化了对合成语音自然度影响因素的理解,也为未来实现类人水平的语音合成提供了重要参考。
数据集最近研究
最新研究方向
在神经语音合成领域,主观平均意见得分(MOS)评估长期依赖昂贵且耗时的人工听测,而现有公开数据集多聚焦于传统合成技术或语音转换任务,难以精准反映现代神经TTS系统的韵律自然度。SOMOS数据集应运而生,作为首个专为神经TTS设计的20K规模MOS语料库,通过200个基于Tacotron的声学模型生成韵律多样化的合成语音,并利用LPCNet统一声码器消除信号质量干扰,确保MOS评分聚焦于韵律恰当性。该数据集在三大英语众测平台上采集近40万条评分,并引入严格质量控制机制,显著提升了众包标注的可靠性。前沿研究正基于SOMOS探索SSL-MOS等深度学习模型在系统级与语句级MOS预测中的泛化能力,揭示当前模型在细粒度韵律评估上的瓶颈——如错误重音或语调模式导致的自然度下降。这一资源不仅推动了客观评估指标从粗粒度系统级向细粒度语句级迈进,更为单说话人场景下TTS声学模型的快速迭代提供了标准化基准,对实现接近人类感知的合成语音质量评估具有里程碑意义。
相关研究论文
  • 1
    SOMOS: The Samsung Open MOS Dataset for the Evaluation of Neural Text-to-Speech Synthesis三星电子,希腊 · 2022年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

