
github_fetch_huggingface_terminal_9070_177pn9_derived_sentiment_scores
收藏数据链接:
官方服务:
资源简介:
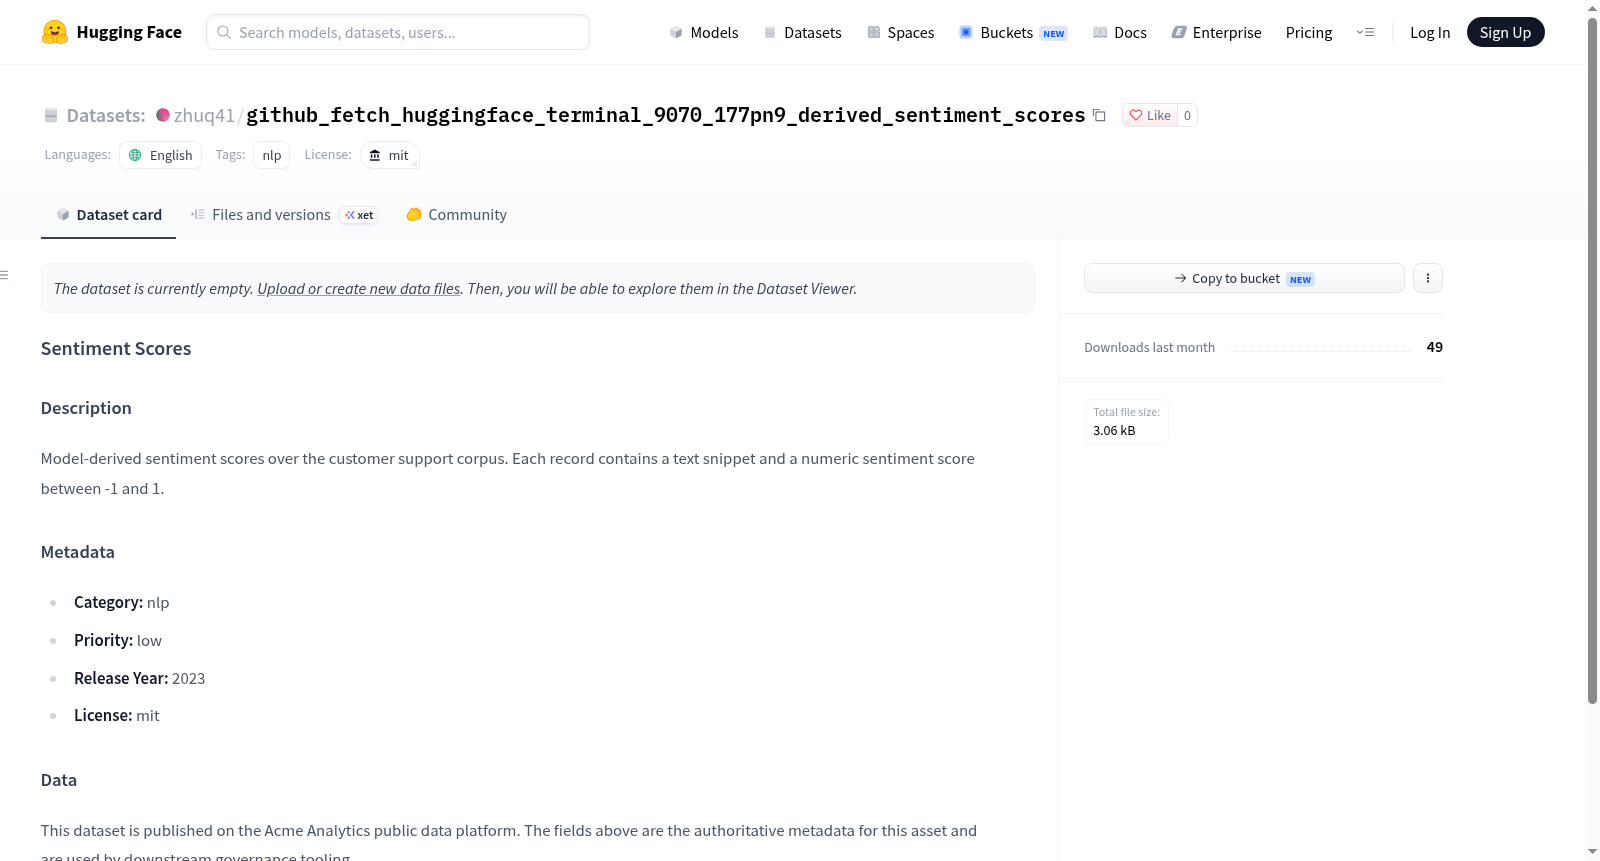
该数据集名为“情感分数”(Sentiment Scores),包含从客户支持语料库中通过模型计算得出的情感分数。每一条记录由一个文本片段和一个介于 -1 到 1 之间的数值情感分数组成。该数据集于 2023 年发布,采用 MIT 许可证,属于自然语言处理(NLP)类别。数据集可用于情感分析、客户反馈分析或相关 NLP 模型的训练与评估任务。
The dataset is named Sentiment Scores, containing sentiment scores computed by a model from a customer support corpus. Each record consists of a text snippet and a numerical sentiment score ranging from -1 to 1. The dataset was released in 2023 under the MIT license and falls under the Natural Language Processing (NLP) category. It can be used for sentiment analysis, customer feedback analysis, or training and evaluation of related NLP models.
创建时间:
2026-08-22
原始信息汇总
数据集概述
基本信息
- 数据集名称: Sentiment Scores
- 语言: 英语 (en)
- 标签: nlp
- 许可证: MIT
- 优先级: low
- 发布日期: 2023年
内容描述
该数据集包含从客户支持语料库中派生的情感得分。每条记录包含一个文本片段和一个介于 -1 到 1 之间的数值情感得分。
类别与用途
- 类别: 自然语言处理 (nlp)
- 适用场景: 适用于情感分析相关的自然语言处理任务,特别是客户支持领域的文本情感评估。
数据类型
每条数据记录包含:
- 文本片段 (text snippet)
- 数值情感得分 (sentiment score),取值范围为 -1 到 1
数据发布平台
该数据集发布在 Acme Analytics 公共数据平台上,上述字段为该资产的权威元数据,供下游治理工具使用。
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,情感分析旨在量化文本中蕴含的情感倾向。该数据集依托客户支持语料库,采用模型驱动的方法生成情感得分。具体而言,每条记录由一段文本片段及其对应的情感分数构成,分数值连续分布于-1至1之间,其中负值表示消极情感,正值表示积极情感,零值附近则反映中性倾向。这一构建方式通过预训练模型对原始客服对话进行推断,避免了人工标注的成本与主观偏差,同时确保了情感极性的细粒度区分。
使用方法
研究人员与开发者可将该数据集用于情感分析模型的训练、验证或微调,尤其适用于客服对话场景的情感倾向预测任务。使用时,可将文本片段作为输入特征,情感分数作为回归目标或转换为分类标签。该数据集亦可用于评估现有情感分析工具在特定领域的表现,或作为迁移学习的源数据。由于许可证为MIT,使用者可自由修改、分发和商用,但需保留原始版权声明。在应用前,建议检查数据分布与自身任务的一致性,并参考平台提供的权威元数据以确保合规使用。
背景与挑战
背景概述
情感分析作为自然语言处理领域的重要分支,旨在通过计算手段识别和量化文本中的主观信息。2023年发布的github_fetch_huggingface_terminal_9070_177pn9_derived_sentiment_scores数据集,由Acme Analytics公共数据平台构建,提供了客户支持语料库的模型衍生情感得分。该数据集包含文本片段及介于-1至1之间的数值情感评分,采用MIT许可证,属于自然语言处理类别。其核心研究问题在于利用预训练模型对客户支持对话进行细粒度情感量化,为情感分析模型的训练与评估提供基准资源。该数据集的发布促进了客户服务领域的情感计算研究,对情感分析模型的鲁棒性和泛化能力评估具有参考价值。
当前挑战
情感分析领域面临的核心挑战在于准确捕捉文本中复杂、微妙的情感表达,尤其是客户支持场景中常见的混合情感、讽刺和领域特定术语。构建本数据集时,主要挑战包括:确保模型衍生情感得分的可靠性与一致性,避免因模型偏差导致评分失真;处理客户支持语料中的噪声、非正式表达和多轮对话上下文依赖;以及平衡评分尺度在极端情感与中性情感之间的分布。此外,数据集的低优先级标签和有限元数据可能限制其在下游任务中的泛化应用,如何验证情感得分的跨领域有效性亦是待解难题。
常用场景
经典使用场景
在自然语言处理的情感分析领域,该数据集凭借其对客户支持语料库的细粒度情感标注,成为模型训练与评估的经典资源。具体而言,每条记录包含文本片段与[-1,1]区间内的连续情感得分,适用于回归式情感强度预测任务,而非仅限离散极性分类。研究者常将其用于微调预训练语言模型(如BERT、RoBERTa),以捕捉客户支持对话中细微的情感渐变,或作为基准测试集验证模型在真实业务场景下的泛化能力。
解决学术问题
该数据集有效缓解了情感分析研究中细粒度标注数据稀缺的困境,尤其针对客户支持领域情感表达含蓄、强度多变的特点。它解决了传统离散标签无法量化情感强度、难以区分中性表述与微弱情绪等学术难题,为情感回归、序数分类及跨领域迁移学习提供了可靠基准。其发布推动了情感计算从粗粒度极性判断向连续强度建模的范式转变,对心理语言学与商业智能交叉研究具有方法论意义。
实际应用
在产业实践中,该数据集直接赋能客户服务系统的情感监测与预警。企业可利用其训练模型实时分析用户对话中的情绪波动,自动识别高不满或高满意交互,进而优化客服排班、触发人工干预或个性化回复策略。同时,该数据集支持产品反馈分析、社交媒体舆情追踪等场景,帮助组织量化用户体验、评估服务改进效果,并驱动数据驱动的客户关系管理决策。
数据集最近研究
最新研究方向
在自然语言处理领域,面向客户支持语料的情感分析正从粗粒度极性判定转向细粒度情感强度建模与可解释性增强。该数据集提供的连续情感分数(-1至1)为研究情感强度回归、跨领域迁移及低资源场景下的模型鲁棒性提供了基准。近期工作聚焦于利用大语言模型生成弱监督信号以校准情感分数,并探索其在对话系统中的实时情绪感知应用。同时,情感分析的可解释性与公平性成为热点,例如检测模型在客户支持场景中的偏见。该数据集亦推动情感分数与下游任务(如意图识别、响应生成)的联合优化,对提升人机交互体验具有实际意义。
以上内容由遇见数据集搜集并总结生成


