
PoetryMTEB/CCPD
收藏官方服务:
资源简介:
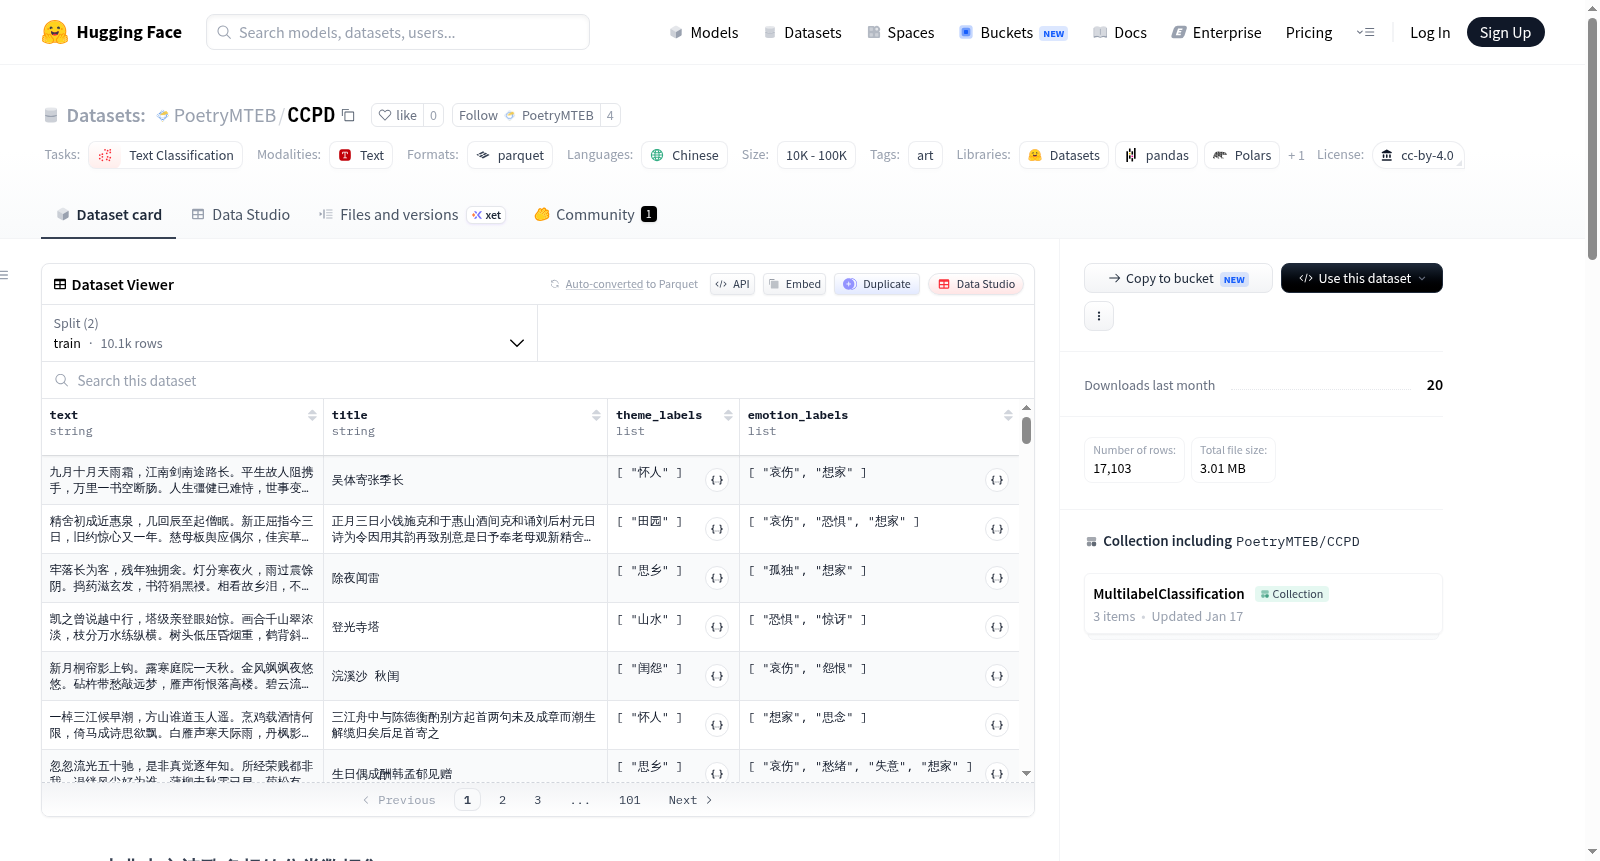
CCPD (古典中文诗歌多标签分类数据集) 是一个包含多标签标注的古典中文诗歌数据集,用于诗歌主题和情感的多标签分类研究。数据集包含17103首诗歌,每个诗歌可以有多个主题和情感标签。
CCPD (Classical Chinese Poetry Dataset) is a multi-label annotated classical Chinese poetry dataset, used for multi-label classification research on poetry themes and emotions. The dataset contains 17,103 poems, each of which can have multiple themes and emotional labels.
提供机构:
PoetryMTEB搜集汇总
数据集介绍
构建方式
CCPD(Classical Chinese Poetry Dataset)是一个专为古典中文诗歌多标签分类研究而构建的高质量数据集。其构建过程严谨而系统,首先从海量古典诗歌文献中遴选出17,103首诗歌作为基础语料。为确保模型训练的可靠性与评估的公平性,数据集按照60%与40%的比例划分为训练集与测试集,并采用多标签分层抽样策略,从而保证两个子集中各类标签的分布高度一致。每条数据以结构化字典形式呈现,包含诗歌正文、标题、主题标签列表及情感标签列表,为多标签分类任务提供了清晰且标准化的数据格式。
特点
该数据集的核心特点在于其多维度、细粒度的标签体系。主题维度涵盖思乡、怀人、田园、战争、山水、怀古、闺怨、悼亡、咏物、送别等10个类别,深刻反映了古典诗歌的丰富题材;情感维度则包含想家、哀伤、愁绪、孤独、失意、思念、流泪、恐惧、怨恨、喜悦等13个类别,细腻捕捉了诗作中蕴含的复杂情感。这种双标签体系使得CCPD不仅适用于多标签文本分类,更能支撑诗歌主题分析与情感分析等跨任务研究,为古典文学的自然语言处理提供了独特而宝贵的资源。
使用方法
使用CCPD数据集十分便捷,研究者可通过HuggingFace的datasets库直接加载。只需调用`load_dataset("PoetryMTEB/CCPD")`,即可获得划分好的训练集与测试集,其大小分别为10,262首与6,841首。每条数据均包含text、title、theme_labels及emotion_labels字段,可直接输入至多标签分类模型进行训练与评估。该数据集广泛应用于多标签文本分类、诗歌主题分析、情感分析、古典文学研究以及跨任务迁移学习等NLP任务,为学术研究提供了坚实的数据基础。
背景与挑战
背景概述
古典中文诗歌作为中华文化的瑰宝,承载着丰富的情感与深邃的哲思,近年来随着自然语言处理技术的进步,对诗歌文本进行自动化分析成为计算文学研究的热点。PoetryMTEB/CCPD数据集于近年由相关研究机构构建,旨在推动古典诗歌的多标签分类研究,核心聚焦于诗歌主题与情感的联合识别。该数据集收录了逾一万七千首诗歌,涵盖思乡、怀古等十大主题标签与哀伤、喜悦等十三种情感标签,通过多标签分层抽样策略确保训练与测试集分布一致,为跨任务迁移学习与古典文学数字化提供了标准化的评测基准,对融合人文学科与人工智能的交叉领域产生了重要影响。
当前挑战
该数据集面临的挑战首先源于古典诗歌本身的语义模糊性与多义性,同一诗句可能同时表达多种主题与情感,导致多标签分类任务中标签间依赖关系复杂,传统模型难以精准捕捉。其次,构建过程中需应对诗歌文本的稀疏性——古汉语用词凝练、意象跳跃,且部分诗歌因历史流传存在版本歧义,标注一致性难以保障。此外,10个主题与13种情感标签的细粒度划分,加剧了类别不平衡问题,如“悼亡”类诗歌数量远少于“山水”类,易使模型产生偏置。这些挑战要求研究者设计更鲁棒的语义表示与标签关联建模方法,以提升分类的准确性与泛化能力。
常用场景
经典使用场景
在古典中文诗歌与自然语言处理的交叉领域中,CCPD数据集为多标签分类任务提供了高度结构化的语料支撑。其最经典的使用场景在于诗歌主题与情感的多标签联合预测,即通过模型同时识别一首诗所蕴含的诸如“思乡”、“田园”等主题类别,以及“愁绪”、“孤独”等情感维度。这一任务不仅要求模型捕捉诗歌语义的层次性,还需应对古典文本中含蓄、隐喻性的表达方式,从而推动了深度学习模型在文学文本细粒度理解上的能力跃升。
衍生相关工作
基于CCPD数据集,学术界已衍生出若干经典工作。一方面,研究者将其作为多标签文本分类的基准,对比不同预训练语言模型(如BERT、RoBERTa等)在古典中文诗歌上的表现,并探索针对古汉语特性的词嵌入优化策略。另一方面,该数据集催生了诗歌生成与风格迁移任务,部分工作利用其标签信息实现可控的诗歌创作,例如根据指定主题或情感生成符合格律的古典诗句。此外,跨语言迁移学习研究中也常引用CCPD,用于评估模型在低资源古汉语场景下的泛化能力,推动了计算语言学与文学研究的交叉创新。
数据集最近研究
最新研究方向
在自然语言处理与数字人文学科的交叉领域,古典中文诗歌的多标签分类研究正成为前沿热点。CCPD作为首个大规模、系统标注主题与情感标签的古典诗歌数据集,为深度挖掘诗歌语义提供了高质标注资源。当前研究聚焦于利用多标签分层抽样策略优化类别不平衡问题,并探索跨任务迁移学习范式,将诗歌主题分析与情感识别统一建模。该数据集不仅推动了中文古诗词的细粒度情感计算与主题演化分析,还催生了面向传统文学智能解读的新一代预训练模型,其成果在文化遗产数字化保护与智能教育领域具有深远影响。
以上内容由遇见数据集搜集并总结生成


