ShahzebKhoso/local-code-arena-starcoder_15b
收藏资源简介:
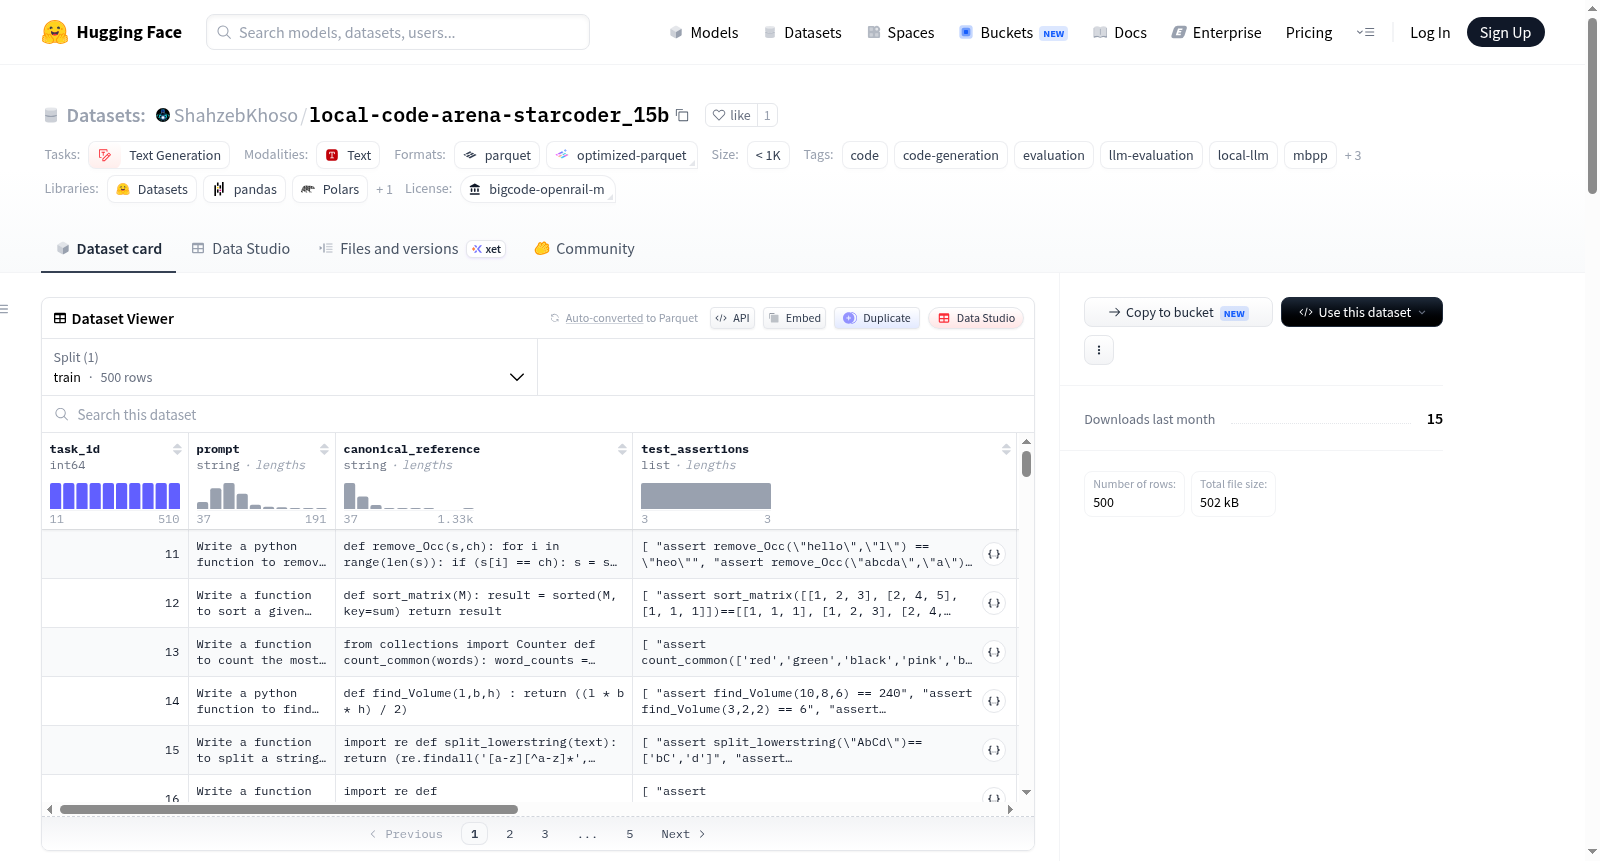
该数据集托管了针对重量级StarCoder 15B基础基础模型运行Mostly Basic Python Problems (MBPP)基准测试所捕获的原始评估指标、执行遥测日志和结构语法输出。该特定分区记录了对话基准测试循环中未对齐基础权重的绝对扩展限制,为对齐溢价跟踪建立了大规模基线。数据集包含核心性能摘要(如功能通过率1.4%、平均生成速度54.35令牌/秒)、参数扩展与对齐矩阵对比、硬件配置详情(如Alienware m18笔记本、NVIDIA RTX 4090 GPU),以及详细的数据集架构和特征模式(例如task_id、prompt、canonical_reference、test_assertions、model_metadata、raw_generation、parsed_code、evaluation_metrics等字段)。评估指标细分包括functional_pass(布尔值,指示代码是否通过测试)、sandbox_feedback(运行时反馈字符串)、codebleu_overall(结构相似性分数)、generation_speed_tps(生成速度令牌/秒)和latency_seconds(延迟秒数)。数据集旨在支持本地评估分析,可通过Hugging Face datasets库加载,并遵循BigCode OpenRAIL-M v1许可证。
--- license: bigcode-openrail-m task_categories: - 文本生成 tags: - 代码 - 代码生成 - 评估 - 大语言模型评估 - 本地大语言模型 - 多数基础Python问题基准测试(Mostly Basic Python Problems,MBPP) - StarCoder - BigCode - 遥测 size_categories: - n < 1K --- # 本地代码竞技场遥测:基于StarCoder 15B(基础版)的MBPP基准测试 本仓库存储了针对重量级**StarCoder 15B**基础大语言模型运行**多数基础Python问题基准测试(Mostly Basic Python Problems,MBPP)**所捕获的原始评估指标、执行遥测日志以及结构化语法输出结果。 该特定数据集分区记录了非对齐基础权重在对话基准测试循环中的绝对缩放极限,为对齐溢价追踪建立了大型基准基线。 ## 📊 核心性能总结 - **评估目标:** `starcoder:15b`(通过Ollama服务器部署) - **单样本通过率(Pass@1):** **1.4%** ⚠️ - **平均生成速度:** **54.35 Token/秒** ⚡ - **评估窗口:** 500个任务(测试划分集) --- ## 📈 参数缩放与对齐矩阵 将该重量级基线与其现代参数匹配的指令微调版本并列对比,可凸显对话微调所带来的巨大性能差异: | 模型标签 | 参数规模 | 模型配置类型 | Pass@1准确率 | 本地吞吐量(Token/秒) | | :--- | :--- | :--- | :--- | :--- | | **`starcoder:15b`** | **155亿** | **传统原生基础模型** | **1.4%** 🎯 | **54.35 Token/秒** | | `qwen2.5-coder:14b` | 140亿 | 现代指令专用模型 | **48.6%** 🏆 | **48.70 Token/秒** | *核心技术洞察:* StarCoder 15B具备出色的处理吞吐量,在本地消费级硬件上可维持超过54 Token/秒的生成速度。然而,由于缺乏对话后训练对齐,其难以在结构化Markdown语法包装中隔离输出内容,或在零样本自然语言提示下优雅终止生成。与对齐模型相比,这导致了显著的功能性能下降,证明了后训练指令层对于将原始参数容量转化为可验证的执行成功至关重要。 --- ## 💻 基线硬件配置 所有遥测记录均在单一本地环境中编译得到: - **主机系统:** Alienware m18 高性能笔记本电脑 - **GPU加速卡:** NVIDIA GeForce RTX 4090 移动版GPU(16GB GDDR6显存 / 最大175W TGP) - **驱动 / CUDA栈:** NVIDIA Driver 581.95 | CUDA 13.0 - **隔离引擎:** 多线程Python代码执行沙箱(2.0秒硬壁钟超时限制) --- ## 📂 数据集架构与特征模式 数据集中的每一行均代表一个经过完整评估的结构化代码生成实例。下表列出了Parquet记录中可用的字段schema: | 列字段 | 数据类型 | 功能描述 | | :--- | :--- | :--- | | `task_id` | `int64` | MBPP数据集条目的原始源跟踪指针。 | | `prompt` | `string` | 传递给本地大语言模型实例的文本指令字符串。 | | `canonical_reference` | `string` | 基础数据集提供的标准Python参考解。 | | `test_assertions` | `list` | 包含显式运行时Python `assert`验证操作的字符串数组。 | | `model_metadata` | `struct` | 记录`model_id`与宿主硬件参数的JSON字典。 | | `raw_generation` | `string` | 直接从本地API流接收的未编辑原始返回字符串。 | | `parsed_code` | `string` | 剥离所有对话式Markdown文本包装后提取的代码块。 | | `evaluation_metrics` | `struct` | 跟踪结构化与执行遥测的深度指标集。 | ### 🛠️ 评估指标细分 在`evaluation_metrics`结构化子字段中,各字段对应精确的跟踪标准: * **`functional_pass`** (`bool`):若代码可正常编译并100%通过关联的测试断言字符串,则取值为`true`。 * **`sandbox_feedback`** (`string`):隔离运行时环境捕获的精确标准输出消息或回溯信息(例如`Execution Timeout`(执行超时)、`NameError`(名称错误)或`Success`(成功))。 * **`codebleu_overall`** (`float`):用于评分的聚合结构指标,对比抽象语法树匹配与数据流语法布局配置与参考目标的契合度。 * **`generation_speed_tps`** (`float`):在本地RTX 4090上捕获的精确Token每秒生成效率得分。 * **`latency_seconds`** (`float`):模型推理响应字符串的绝对往返执行延迟(单位:秒)。 --- ## 🚀 如何使用此数据集 您可通过Hugging Face `datasets`库将该遥测数据集流式传输至本地评估分析笔记本中: python from datasets import load_dataset # 将本地代码竞技场性能日志直接流式传输至您的DataFrame dataset = load_dataset("ShahzebKhoso/local-code-arena-mbpp-starcoder-15b") # 访问单个记录块 first_entry = dataset['train'][0] print(f"记录的矩阵吞吐量:{first_entry['evaluation_metrics']['generation_speed_tps']} Token/秒") ## 📄 许可与引用 本数据集基于BigCode OpenRAIL-M v1许可证分发。若您在对比研究工作中使用了这些原始遥测文件,请引用本Hub仓库。