glm53-flash-harvest
收藏资源简介:
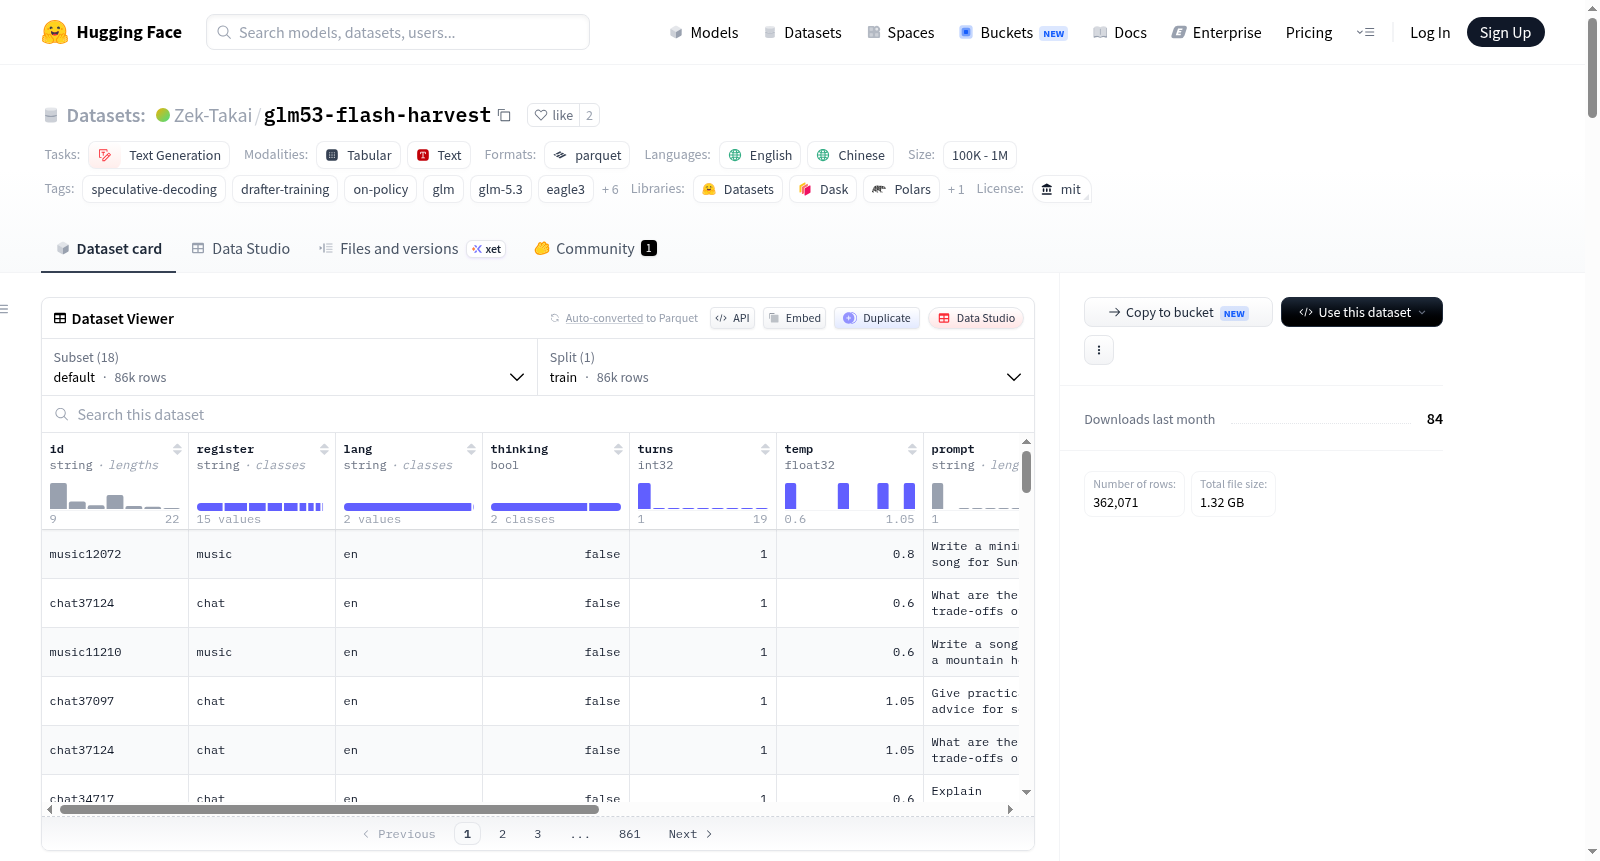
GLM-5.3-Flash On-Policy Harvest 数据集由 zai-org/GLM-5.3-Flash 模型生成的 on-policy 响应组成,旨在为投机解码的 drafter 头部(如 DFlash2 / DSpark 系列)提供训练文本,学习预测目标模型实际生成的内容。数据集包含四个轮次(round1-4),总计 86,006 个响应,246,701,765 个 token,覆盖多种寄存器(register):代码(14种语言)、散文/创意写作、结构化数据(JSON/表格/计划/规范)、推理/数学、聊天/通用问答、代理/工具调用、中文(混合寄存器)、音乐/歌词、多轮对话等。数据区分 thinking 开启和关闭模式,响应中可能包含内联的思考链。每个样本以 Parquet 格式存储,包含统一字段:id(提示词ID)、register(寄存器)、lang(语言)、thinking(是否包含思考链)、turns(轮次)、temp(采样温度)、prompt(最终用户提示词)、response(模型响应)、tokens(完成 token 数)、messages_json(多轮上下文)。数据集提供多种配置(如 default、round1、round2、thinking_on、thinking_off 及各寄存器子集),方便按需加载。提示词来自合成和部分人类来源(如 open-perfectblend),所有响应均为 GLM-5.3-Flash 生成,许可证为 MIT。
The GLM-5.3-Flash On-Policy Harvest dataset consists of on-policy responses generated by the zai-org/GLM-5.3-Flash model, intended to provide training text for the drafter head of speculative decoding (such as DFlash2 / DSpark series) to learn to predict the actual content generated by the target model. The dataset includes four rounds (round1-4), totaling 86,006 responses and 246,701,765 tokens, covering various registers: code (14 languages), prose/creative writing, structured data (JSON/tables/plans/specifications), reasoning/math, chat/general Q&A, agent/tool calls, Chinese (mixed registers), music/lyrics, multi-turn conversations, etc. The data distinguishes between thinking on and off modes, and responses may contain inline chain-of-thought. Each sample is stored in Parquet format with unified fields: id (prompt ID), register, lang, thinking (whether chain-of-thought is included), turns, temp (sampling temperature), prompt (final user prompt), response (model response), tokens (completion token count), messages_json (multi-turn context). The dataset provides multiple configurations (e.g., default, round1, round2, thinking_on, thinking_off, and register subsets) for easy loading. Prompts come from synthetic and partially human sources (e.g., open-perfectblend), all responses are generated by GLM-5.3-Flash, and the license is MIT.
GLM-5.3-Flash On-Policy Harvest 数据集概述
基本信息
- 数据集名称:GLM-5.3-Flash On-Policy Harvest
- 许可证:MIT
- 语言:英语(en)、中文(zh)
- 任务类别:文本生成(text-generation)
- 数据规模:约 10K-100K 条(86,006 条响应 / 246,701,765 个生成 token)
- 用途:用于投机解码(speculative-decoding)草稿模型(drafter heads, DFlash2 / DSpark)的训练,使草稿模型学习预测目标模型(GLM-5.3-Flash)的实际生成内容。
数据生成
- 基于 zai-org/GLM-5.3-Flash(FP8 参考权重,vLLM day-0 镜像),采样温度在 0.6/0.8/0.95/1.05 之间循环。
- 使用 Claude Code 和 Spectra Scope 工具辅助生成。
- 采用 on-policy 方法,即草稿模型学习预测目标模型实际会生成的内容。
数据集结构
四轮采集数据(rounds)
| 轮次 | 响应数 | token 数 | 状态 |
|---|---|---|---|
| Round 1 — balanced base | 46,611 | 60,945,988 | ✅ 完成 |
| Round 2 — coverage expansion | 18,858 | 56,434,338 | ✅ 完成 |
| Round 3 — gap-fill | 15,337 | 84,947,473 | ✅ 完成 |
| Round 4 — production realism | 5,200 | 44,373,966 | ✅ 完成 |
| 全语料总计 | 86,006 | 246,701,765 | — |
各轮次详情
Round 1(2026-08-30 采集,46,611 条响应,0 错误)
- 单轮对话,关闭思考模式,生成上限 1,600 token,基于合成提示库(确定性组合,种子 42)。
- 包含类别:代码(13,846 行 / 34.0%)、散文/创意(12,546 行 / 29.0%)、结构化如 JSON/表格/计划/说明书(9,299 行 / 20.4%)、聊天(7,087 行 / 10.3%)、音乐/歌词(3,754 行 / 6.1%)、操作类 CLI/智能体(79 行 / 0.1%)。
Round 2(2026-08-30 采集,18,858 条响应,预算受限运行,每个提示两种温度)
- 9,465 行(50.2%)启用思考模式,包含内联
<think>…</think>链,共 39.95M token。 - 1,709 行是中文内容。
- 新增类别:推理/数学(3,187 行)、智能体/工具调用(1,745 行)、中文(1,709 行)、多轮对话(90 行)。
- 生成上限提升至 1,600-2,560(思考行高达 6,144)。
Round 3 — gap-fill(2026-09-02 采集,15,337 条响应)
- 深补推理、智能体、结构化和多轮对话类别;思考模式按行混合,未封顶推理链的上限可达 12,288。
- 新增注册类别:agentic(+3,895 行)、multiturn(+2,046 行)、reasoning(+7,445 行)、structured(+1,951 行)。
Round 4 — production realism(2026-09-02 采集,5,200 条响应)
- 生产现实场景:基于真实仓库(SWE-bench Verified、github-code-clean)的智能体编码循环、代码编辑与审查、迭代多轮对话(4-10 轮助手回复,每轮单独成行)、非代码工具循环、8k-32k 长上下文前缀、竞赛数学推理、约 15% 行附加系统提示。
- 行 ID 以
#tK结尾表示对话的第 K 轮。
数据格式与模式
统一 Parquet 文件(zstd 压缩)存储,列结构如下:
| 字段 | 类型 | 说明 |
|---|---|---|
| id | string | 注册类别前缀的提示 ID |
| register | string | code / prose / music / structured / chat / operator / reasoning / agentic / zh / multiturn |
| lang | string | en / zh |
| thinking | bool | 响应是否包含内联 <think>…</think> 链 |
| turns | int32 | 上下文轮数(1 = 单轮;>1 = 多轮) |
| temp | float32 | 采样温度 |
| prompt | string | 最终用户提示 |
| response | string | GLM-5.3-Flash 的响应 |
| tokens | int32 | 完成 token 数量 |
| messages_json | string | 多轮行的完整对话上下文,否则为 null |
Config 配置与切片
共提供 17 种配置,便于按需加载:
| config | 行数 | tokens | 内容 |
|---|---|---|---|
| default | 86,006 | 246.7M | 全量语料(四轮全部) |
| round1 | 46,611 | 60.9M | Round 1:关闭思考,单轮 |
| round2 | 18,858 | 56.4M | Round 2:混合模式 |
| round3 | 15,337 | 84.9M | Round 3:gap-fill |
| round4 | 5,200 | 44.4M | Round 4:生产现实 |
| thinking_on | 9,465+ | — | 含内联 <think>…</think> 链的响应 |
| thinking_off | — | — | 不含推理链的响应 |
| code | 17,985 | 38.2M | 代码,14 种语言 |
| prose | 15,923 | 29.7M | 故事、书信、独白、诗歌 |
| structured | 12,161 | — | JSON、表格、计划、说明书、runbook |
| reasoning | 10,632 | — | 数学/逻辑,逐步推理 |
| chat | 10,141 | 9.1M | 一般问答/指令 |
| agentic | 5,640 | — | 工具调用转录(JSON 工具模式) |
| zh | 1,709 | 5.1M | 中文,混合注册类别 |
| music | 4,400 | 4.4M | 带结构标签的歌词 |
| multiturn | 4,846 | — | 多轮上下文(设置 messages_json) |
| operator | 79 | 0.07M | CLI/智能体风格提示 |
注册类别和思考模式配置横跨所有轮次(是同一行数据的重新分片,并非新增数据)。round3、round4 和 provenance_r34 配置可获取各轮的独立文件。
数据质量控制与标注
Round 3+4 提供标签卫生数据(provenance_r34.parquet),按行标注:
- 思考模式开启行:Round 3 中 383/10,366 行(3.7%)在关闭链前达到 token 上限(
cap_hit);Round 4 中 400/2,185 行(18.3%)。 - 思考模式关闭行:Round 3 中 1,466/4,971 行(29.5%)在其答案内包含
<think>标签(think_tag_in_off);Round 4 中 614/3,015 行(20.4%)。这些是按照实际生成保留的文本,若需要干净标签数据,可按标志过滤。
提示来源与许可
- Round 1:全部为合成、原创提示。
- Round 2:合成提示外加来自 mlabonne/open-perfectblend(经 mgoin/open-perfectblend-glm5.2-regen)的人类提示轮次,用于聊天和多轮注册类别。
- Round 3+4:提示库来源包括 SWE-bench Verified(MIT)、github-code-clean(Apache-2.0,仅限 MIT/Apache/BSD/ISC/CC0 许可文件)、open-perfectblend-glm5.2-regen、hendrycks MATH(MIT)、Wikipedia 2023-11-01(CC-BY-SA 3.0)。各源数据集的底层提示许可见各源数据集。
- 所有响应文本:GLM-5.3-Flash(MIT)。整体语料库:MIT。
快速上手示例
python from datasets import load_dataset
加载全量数据
ds = load_dataset("Zek-Takai/glm53-flash-harvest", data_files="data/*.parquet", split="train")
仅加载思考模式响应
thinking = ds.filter(lambda r: r.get("thinking"))
按配置加载特定切片
ds = load_dataset("Zek-Takai/glm53-flash-harvest", "<config>", split="train")
引文格式
bibtex @misc{glm53flashharvest2026, title = {GLM-5.3-Flash On-Policy Harvest}, author = {Zek-Takai}, year = {2026}, url = {https://huggingface.co/datasets/Zek-Takai/glm53-flash-harvest} }