arabic-dialect-corpus
收藏资源简介:
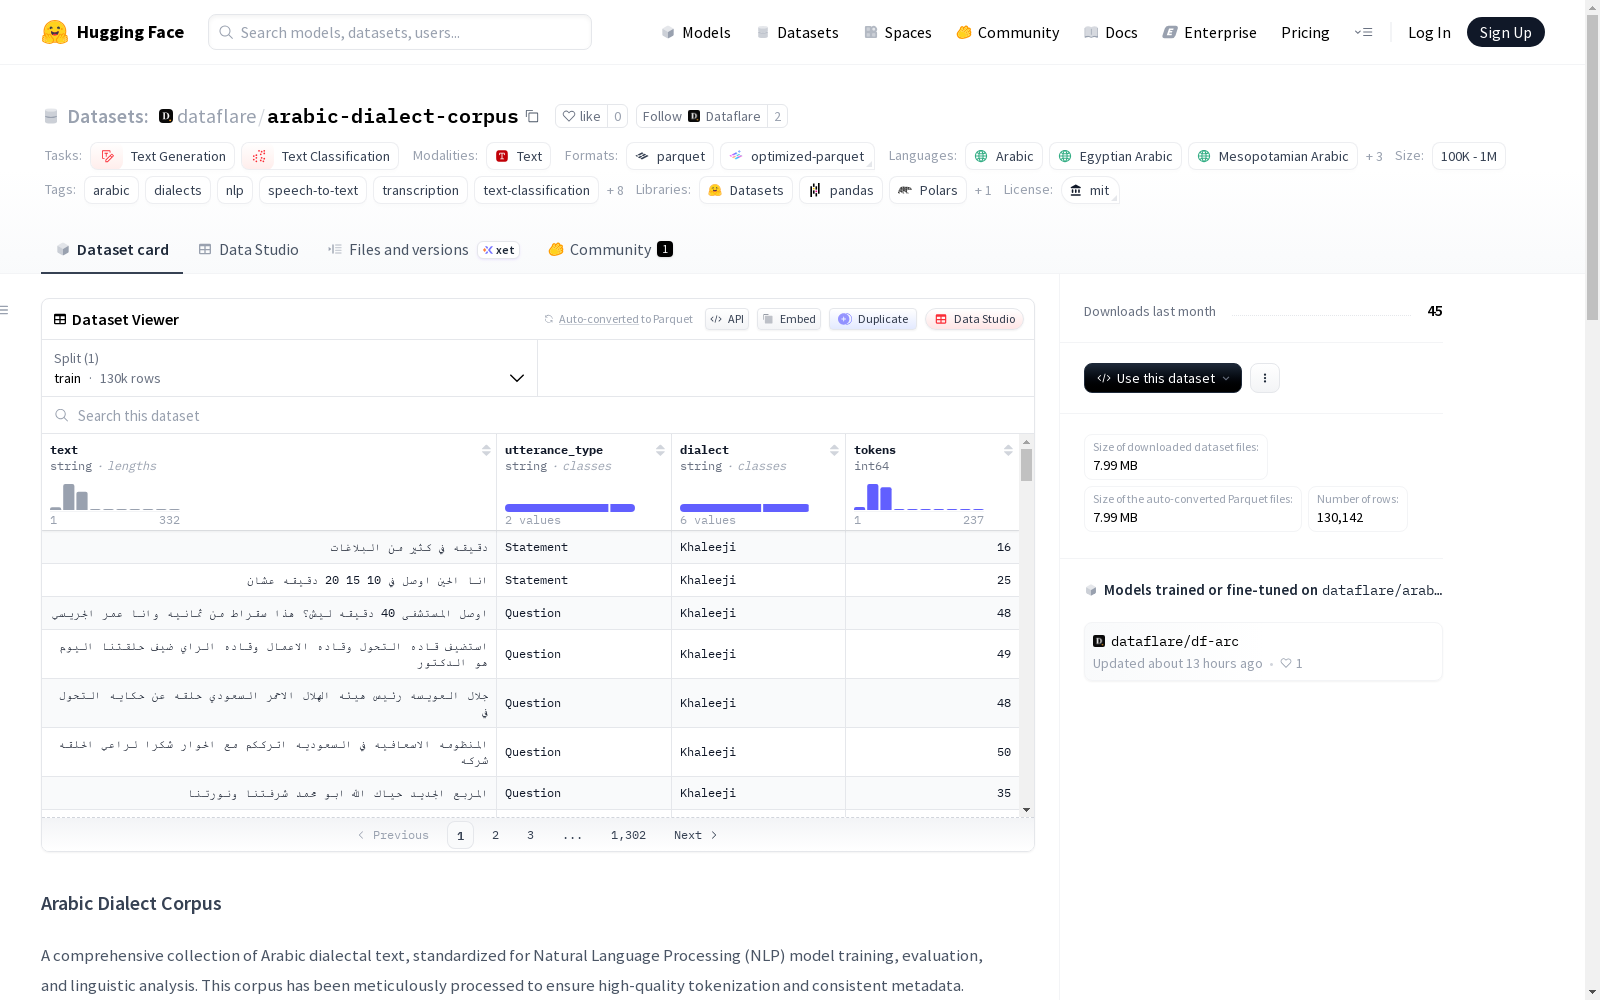
阿拉伯语方言语料库是一个全面的阿拉伯语方言文本集合,经过标准化处理,适用于自然语言处理(NLP)模型训练、评估和语言分析。该语料库经过精心处理,确保高质量的分词和一致的元数据。数据集包含多种阿拉伯语方言,如埃及方言、海湾方言、黎凡特方言、马格里布方言和伊拉克方言。每个记录包含文本内容、主题、话语类型、方言和分词数量等字段。数据集总记录数为127,180条,总分词数为5,802,324个,平均每条记录45.62个分词。
The Arabic Dialect Corpus is a comprehensive collection of standardized Arabic dialectal texts, designed for natural language processing (NLP) model training, evaluation, and linguistic analysis. The corpus has undergone meticulous processing to ensure high-quality word segmentation and consistent metadata. The dataset includes multiple Arabic dialects, such as Egyptian, Gulf, Levantine, Maghrebi, and Iraqi dialects. Each record contains fields including text content, topic, discourse type, dialect, and number of word segments. The total number of records in the dataset is 127,180, with a total of 5,802,324 word segments, averaging 45.62 word segments per record.
Arabic Dialect Corpus 数据集概述
数据集基本信息
- 数据集名称:Arabic Dialect Corpus
- 发布者:Dataflare
- 发布日期:2026年1月
- 版本:1.0
- 许可证:MIT License
- 数据集地址:https://huggingface.co/datasets/dataflare/arabic-dialect-corpus
语言与方言
- 语言:阿拉伯语及其方言,包括
ar、arz、acm、apc、ary、arb - 方言区域覆盖:埃及 (
ar-EG)、伊拉克 (ar-IQ)、黎巴嫩 (ar-LB)、摩洛哥 (ar-MA)、沙特阿拉伯 (ar-SA) - 方言类别:5类,具体为
Masri(埃及方言)、Khaleeji(海湾方言)、Levantine(黎凡特方言)、Maghrebi(北非方言)、Iraqi(伊拉克方言)
数据集规模与统计
- 总记录数:127,180 条
- 总令牌数:5,802,324 个
- 平均每条记录令牌数:45.62 个
- 训练集大小:130,142 条样本,20,535,791 字节
- 下载大小:7,987,038 字节
- 数据集大小:20,535,791 字节
- 规模分类:100K < n < 1M
数据集结构
每条记录包含以下字段:
text(字符串):原始阿拉伯语文本内容。topic(字符串):文本的语义类别或主题。utterance_type(字符串):话语类型分类(例如:陈述、疑问)。dialect(字符串):区域方言名称。tokens(整数):使用cl100k_base(GPT-4 标准) 编码计算的精确令牌数量。
任务类别与标签
- 任务类别:文本生成、文本分类
- 标签:arabic, dialects, nlp, speech-to-text, transcription, text-classification, linguistics, corpus, egyptian, gulf, levantine, maghrebi, iraqi, cl100k_base
数据集用途
- 主要用途:用于自然语言处理模型训练、评估和语言分析的综合阿拉伯语方言文本集合。
- 处理特点:经过精心处理,确保高质量的令牌化和一致的元数据。
数据加载方式
使用 Hugging Face datasets 库直接加载:
python
from datasets import load_dataset
dataset = load_dataset("dataflare/arabic-dialect-corpus")
方法论摘要
- 数据收集:来自转录媒体和公共档案等多种来源。
- 处理流程:
- 规范化:文本规范化以去除噪声,同时保留方言特征。
- 分割:将长段落分割成适合训练的块。
- 令牌计数:使用
tiktoken进行严格的令牌计数,以辅助课程训练和长度分桶。
质量保证
- 令牌计数验证:使用
cl100k_base验证超过 580 万令牌。 - 数据密度:优化平均记录长度至约 45 个令牌,以提高训练效率。
- 方言覆盖:确认分布在 5 个不同的方言类别中。
- 数据完整性:无空记录,采用标准化元数据模式。
引用信息
如果研究或应用中使用了本数据集,请使用以下 BibTeX 条目引用: bibtex @dataset{arabic_dialect_corpus, title={Arabic Dialect Corpus}, author={Dataflare}, year={2026}, publisher={Hugging Face}, url={https://huggingface.co/datasets/dataflare/arabic-dialect-corpus} }