home-credit-default-risk
收藏资源简介:
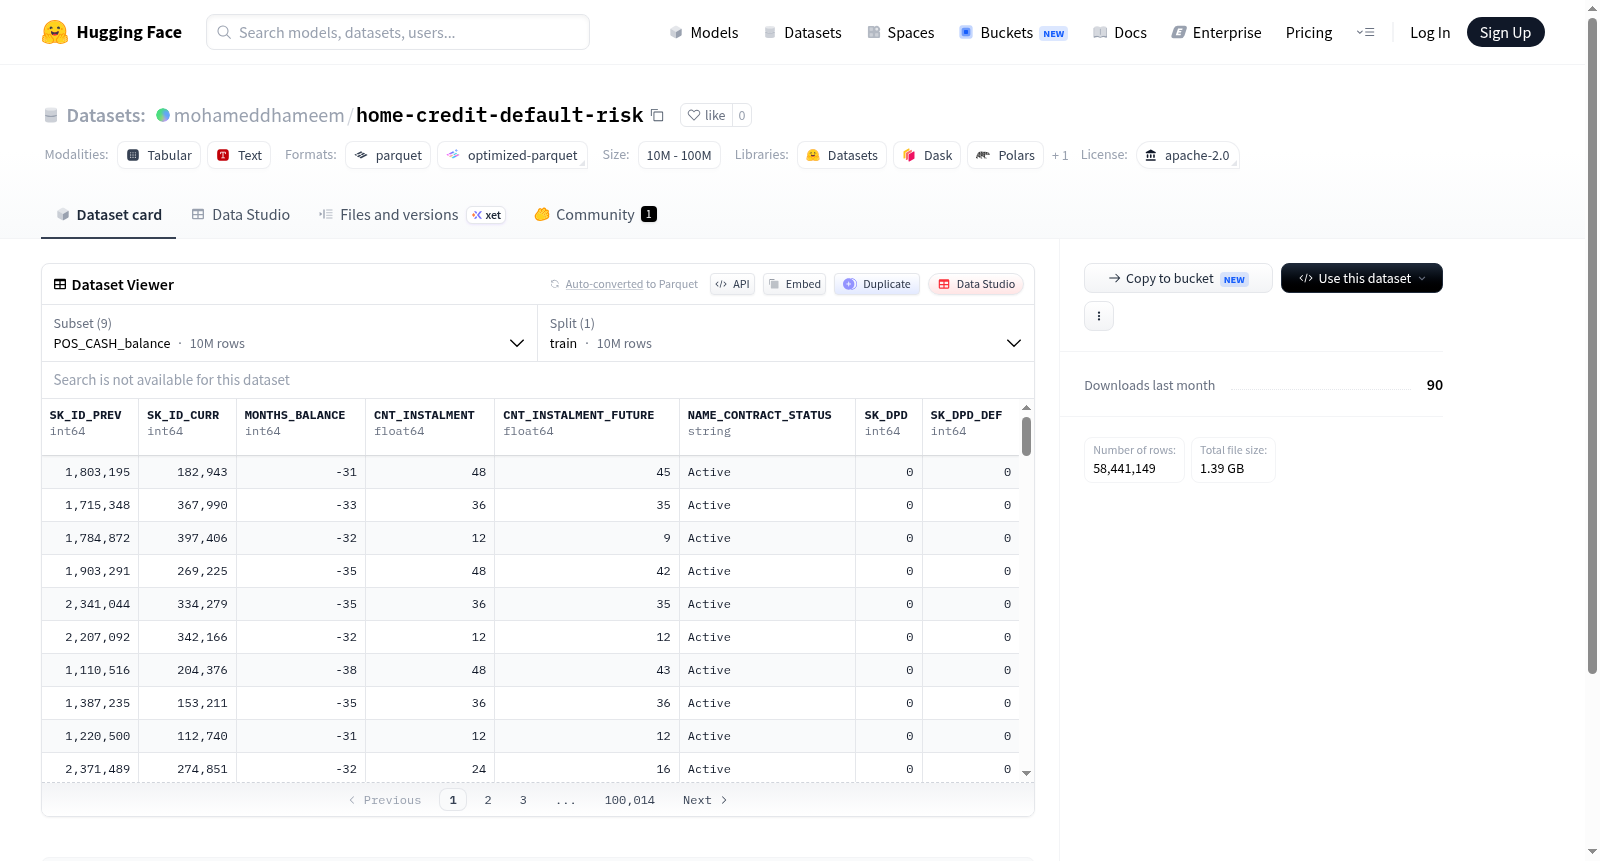
该数据集是一个结构化的金融信贷数据集,包含多个相互关联的数据表,主要用于信贷风险评估和违约预测任务。数据集由9个独立表格组成:POS_CASH_balance(POS现金余额,1000万样本)、application_test(申请测试集,4.8万样本)、application_train(申请训练集,30.7万样本)、bureau(征信局记录,171万样本)、bureau_balance(征信局余额记录,2730万样本)、credit_card_balance(信用卡余额,384万样本)、installments_payments(分期付款记录,1360万样本)、previous_application(历史申请记录,167万样本)以及sample_submission(提交样例)。数据字段涵盖客户基本信息(如性别、年龄、职业、收入)、财务信息(如信用额度、年金、商品价格)、申请信息(如合同类型、申请时间)、信用历史(如征信记录、逾期天数、付款状态)、资产信息(如房产面积、楼层数、建筑年份)以及行为数据(如社交圈观察、电话变更、文档标志)。表格通过客户ID(SK_ID_CURR)和先前申请ID(SK_ID_PREV)进行关联,形成一个完整的信贷生命周期视图。该数据集适用于监督学习中的二分类预测任务(例如application_train中的TARGET字段),典型应用场景包括客户信用评分、贷款违约预测和风险管理模型开发。
This dataset is a structured financial credit dataset containing multiple interrelated data tables, mainly used for credit risk assessment and default prediction tasks. It consists of 9 independent tables: POS_CASH_balance (POS cash balance, 10 million samples), application_test (test application set, 48,000 samples), application_train (training application set, 307,000 samples), bureau (credit bureau records, 1.71 million samples), bureau_balance (credit bureau balance records, 27.3 million samples), credit_card_balance (credit card balance, 3.84 million samples), installments_payments (installment payment records, 13.6 million samples), previous_application (historical application records, 1.67 million samples), and sample_submission (submission template). The data fields cover customer basic information such as gender, age, occupation, income, financial information such as credit limit, annuity, commodity price, application information such as contract type, application time, credit history such as credit bureau records, overdue days, payment status, asset information such as property area, number of floors, construction year, and behavioral data such as social circle observations, phone number changes, document flags. The tables are linked via customer ID (SK_ID_CURR) and previous application ID (SK_ID_PREV), forming a complete credit lifecycle view. This dataset is suitable for binary classification prediction tasks in supervised learning, e.g., the TARGET field in application_train, with typical application scenarios including customer credit scoring, loan default prediction and risk management model development.